ภาพถ่ายพูดได้ AI

อัปโหลดภาพพอร์เทรตและแทร็กเสียง (สูงสุด 35s) หรือพิมพ์สคริปต์แล้วเลือกเสียง จากนั้น OmniHuman 1.5 จะเปลี่ยนภาพถ่ายให้เป็นวิดีโอพูดที่ริมฝีปากซิงก์และการเคลื่อนไหวเป็นธรรมชาติ ใช้ภาพถ่ายของตัวเองเพื่อลงแสดงเอง

0 / 2,000
130 cr/s · ≤35s

จากภาพถ่ายเดียวสู่วิดีโอที่พูดได้

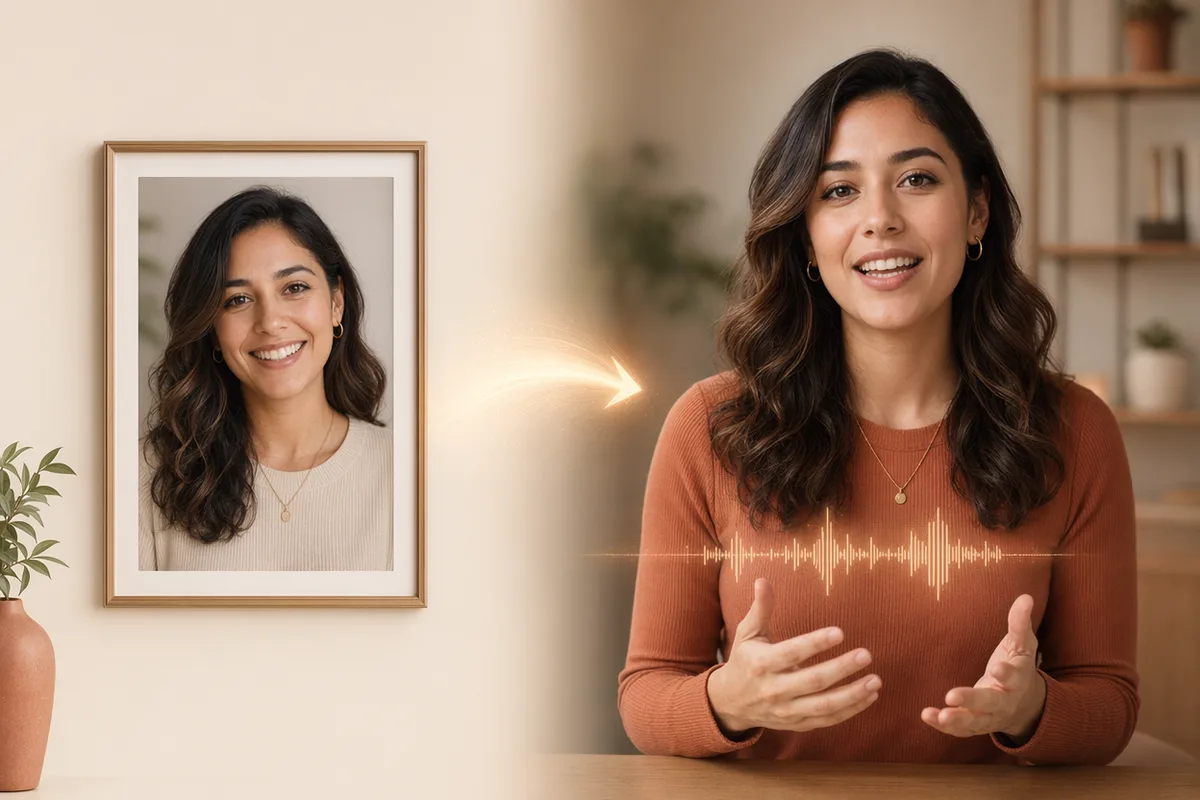
ภาพบุคคลเดียวกับสคริปต์กลายเป็นผู้พูดที่สมจริง — ริมฝีปาก สีหน้า และท่าทางซิงค์กัน ไม่ต้องใช้กล้องหรือสตูดิโอ

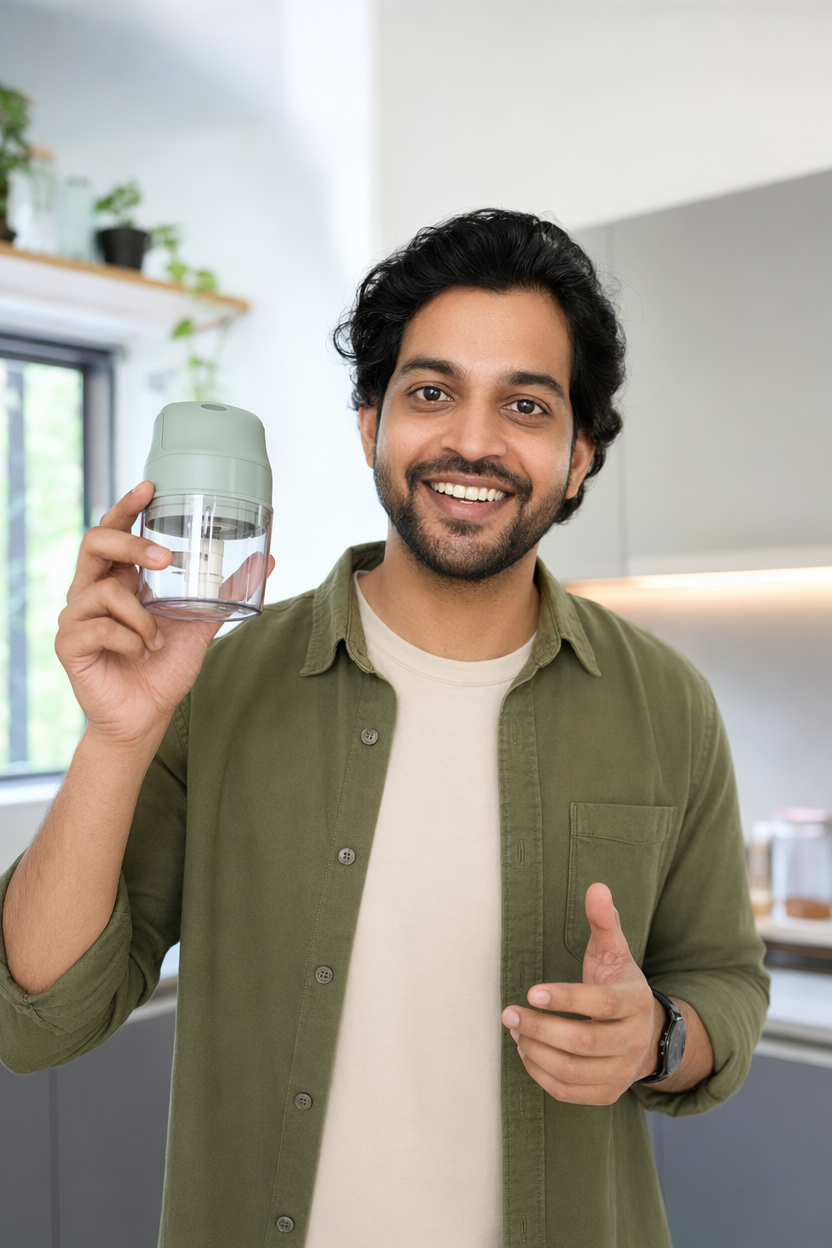
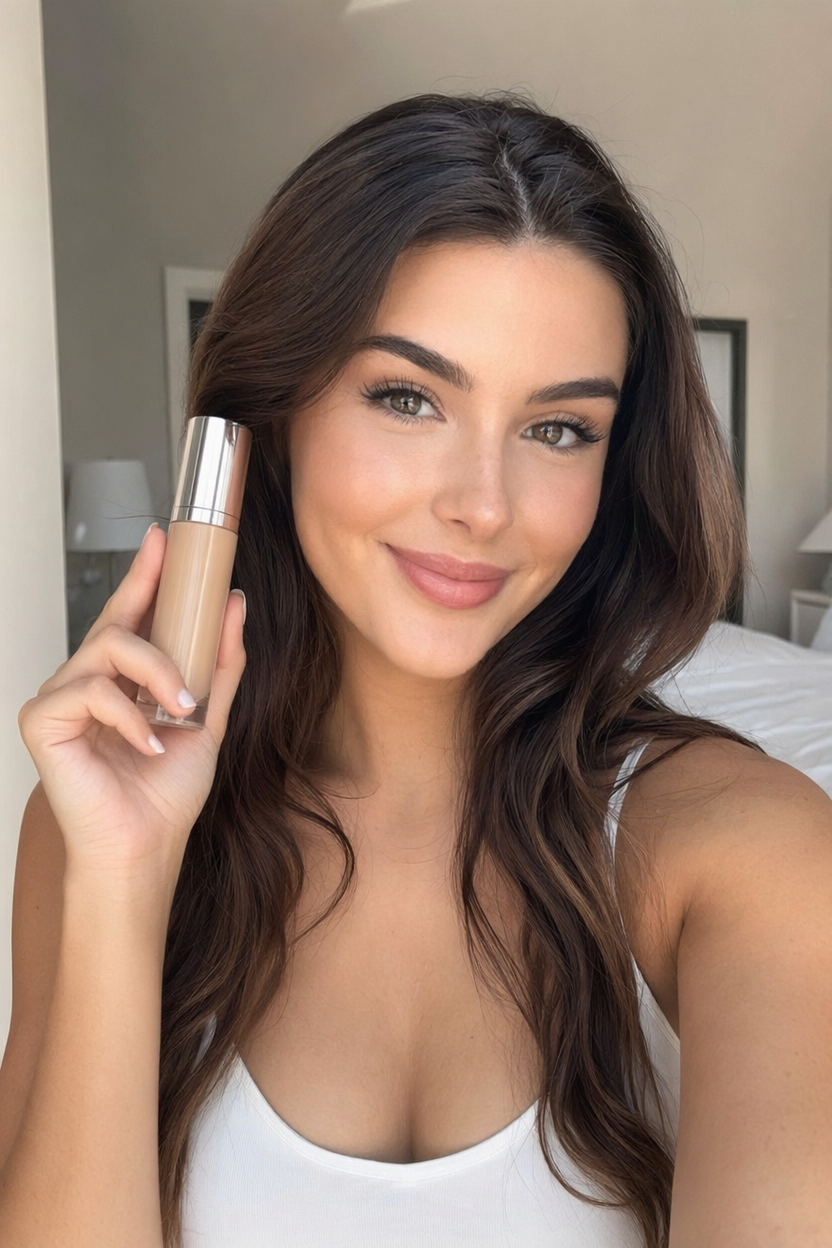
ภาพต้นฉบับOriginal portrait photo of a beauty creator holding a skincare product
สคริปต์

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

วิดีโอ AI อวตาร

ทำให้ภาพถ่ายใดก็ได้พูด รวมถึงภาพของคุณเอง

ตัวสร้างภาพถ่ายพูดได้ AI (มนุษย์ดิจิทัล) แบบครบวงจร: อัปโหลดภาพบุคคลและคลิปเสียง หรือพิมพ์สคริปต์แล้วเลือกเสียงพูด จากนั้นรับวิดีโอพูดที่สมจริง พร้อมริมฝีปากที่เคลื่อนตรงกับเสียง สีหน้าและท่าทางที่เป็นธรรมชาติ ใช้ภาพถ่ายของตัวเองเพื่อเป็นผู้นำเสนอได้ ขับเคลื่อนโดย ByteDance OmniHuman 1.5 ไม่ต้องใช้กล้อง นักแสดง หรือสตูดิโอ

ภาพบุคคลในกรอบที่กำลังกลายเป็นอวาทาร์ AI พูดได้ของผู้หญิงคนเดียวกัน โดยมีคลื่นเสียงอยู่ระหว่างทั้งสองภาพ

แสดงเองในวิดีโอ หรือสร้างโฆษกดิจิทัลของคุณเอง

ไม่ต้องถ่ายทำ ไม่ต้องใช้นักแสดง ไม่ต้องใช้กรีนสกรีน อัปโหลดภาพถ่ายที่ชัดเจนของคุณเพียงภาพเดียว แล้วคุณจะกลายเป็นผู้นำเสนอที่อ่านสคริปต์ของคุณ ด้วยเสียงของคุณเองหรือเสียงจากคลังเสียง หรือใช้ภาพถ่ายของบุคคลที่ให้สิทธิ์คุณแล้ว เพื่อสร้างพิธีกรดิจิทัลที่นำกลับมาใช้ซ้ำได้ สำหรับวิดีโออธิบายผลิตภัณฑ์ บทนำคอร์สเรียน ประกาศ และโฆษณา สร้างบทพูดใหม่ได้ทุกเมื่อโดยไม่ต้องถ่ายทำใหม่
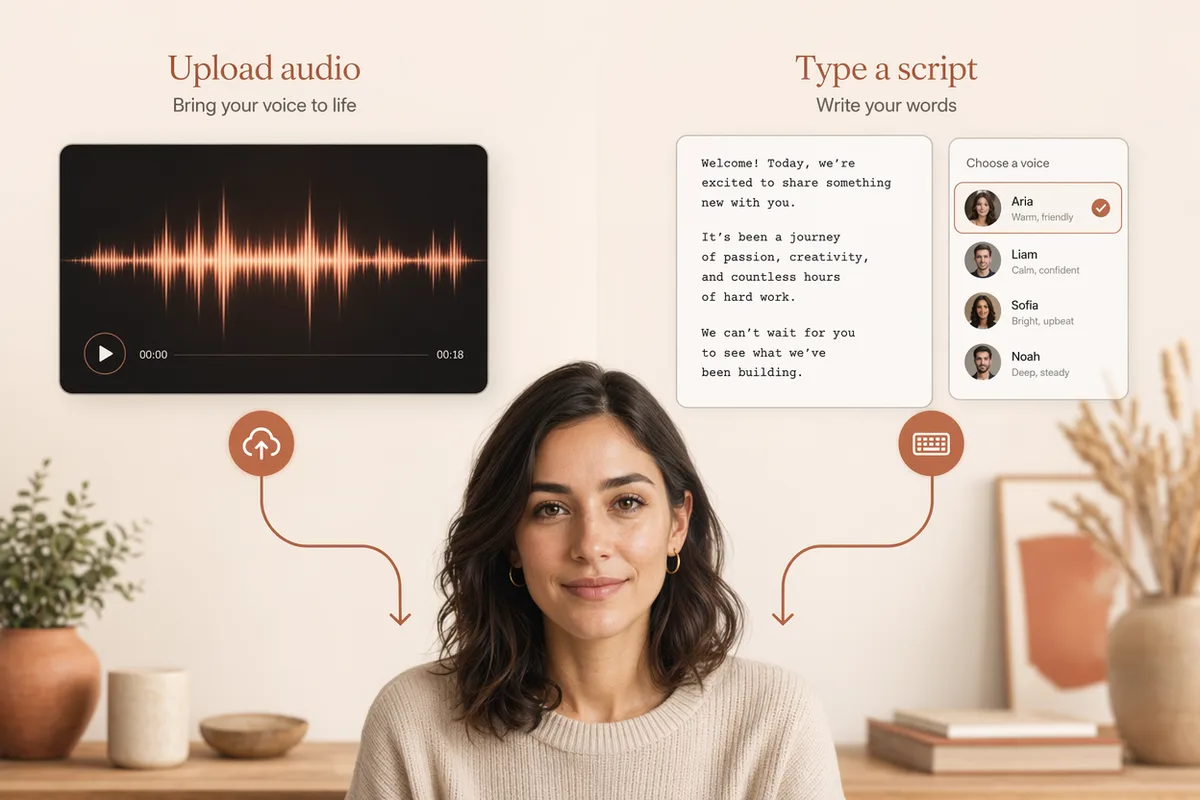
อินพุตสองอย่างสำหรับภาพถ่ายพูดได้ AI: คลื่นเสียงที่อัปโหลด และสคริปต์ที่พิมพ์พร้อมตัวเลือกเสียงพูด

มีสองวิธีในการป้อนข้อมูล: อัปโหลดไฟล์เสียง หรือพิมพ์สคริปต์

มีไฟล์เสียงอยู่แล้วใช่ไหม? อัปโหลดได้เลย แล้วตัวละครจะขยับปากตามเสียงนั้น หากไม่มีไฟล์เสียง ให้เปลี่ยนเป็นโหมดข้อความ — พิมพ์สิ่งที่ตัวละครควรพูด เลือกเสียงจากคลังเสียงแปลงข้อความเป็นเสียงพูดในตัว แล้วข้อความนั้นจะถูกสังเคราะห์เป็นเสียงขับรถให้คุณโดยอัตโนมัติ ความยาวโดยประมาณและค่าใช้จ่ายเครดิตจะแสดงก่อนที่คุณจะสร้าง

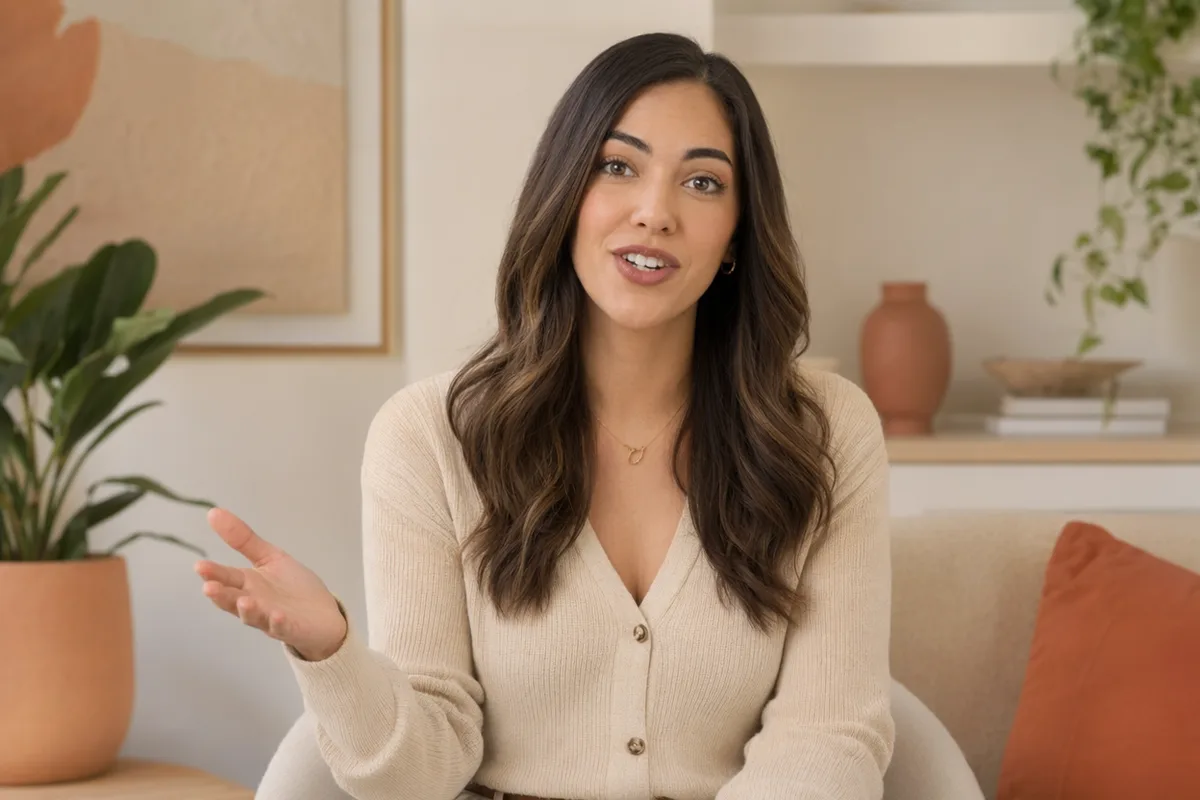
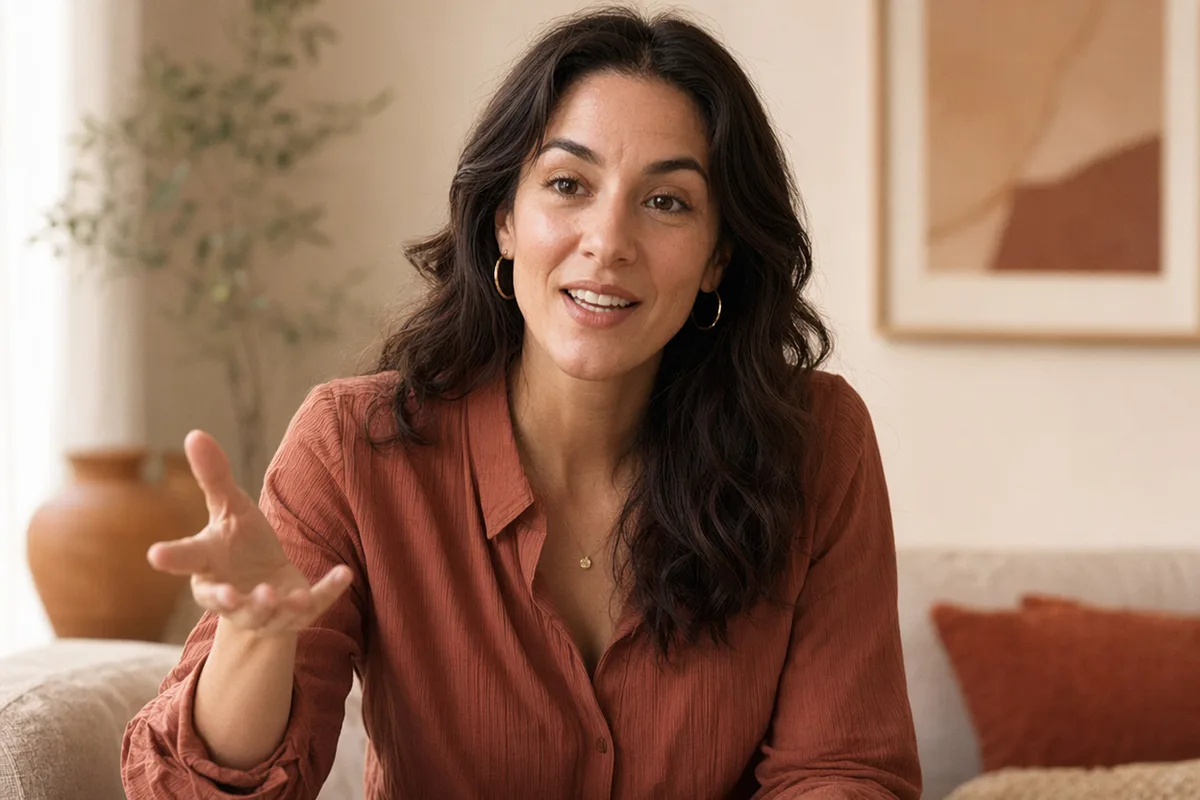
ภาพนิ่งจากภาพถ่ายพูดได้ AI ของผู้หญิงที่กำลังพูดกับกล้องพร้อมท่าทางมือที่เป็นธรรมชาติ

เหมือนจริง — ไม่ใช่แค่ปากที่ขยับได้

OmniHuman 1.5 อ่านจังหวะ น้ำเสียง และความหมายของเสียง เพื่อควบคุมการเคลื่อนไหวของศีรษะ ท่าทาง และท่าทางมือ ควบคู่ไปกับการซิงค์ริมฝีปากที่แม่นยำ ในขณะที่ยังคงรักษาเอกลักษณ์และแสงสว่างของบุคคลนั้นไว้ ผลลัพธ์ที่ได้คือการแสดงที่เหมือนผู้บรรยายจริง ๆ มากกว่าภาพนิ่งที่มีการเคลื่อนไหวของปาก

ผู้นำเสนอจากภาพถ่ายพูดได้ AI ในห้องนั่งเล่นกำลังนำเสนอคลิปโซเชียลสั้น ๆ

สร้างขึ้นเพื่อการตลาด การฝึกอบรม และสื่อสังคมออนไลน์

สร้างคลิปวิดีโอสำหรับโฆษณาและหน้า Landing Page, บทเรียนพร้อมคำบรรยายและคู่มือการฝึกอบรม, โพสต์แบบพูดคุยสำหรับโซเชียลมีเดีย หรือเวอร์ชันหลายภาษาของข้อความเดียวกัน ทุกรุ่นจะถูกบันทึกไว้ในประวัติพร้อมข้อมูลป้อนเข้า เพื่อให้คุณสามารถปรับปรุงและสร้างเวอร์ชันต่างๆ ได้อย่างรวดเร็ว

ภาพบุคคลที่พร้อมสำหรับ AI ภาพถ่ายพูดได้

ภาพบุคคลสไตล์ผู้ประกาศที่สร้างบน CreateVision AI — ใส่เสียงเข้าไป ภาพไหนก็ขับวิดีโออวตารพูดได้ทั้งนั้น

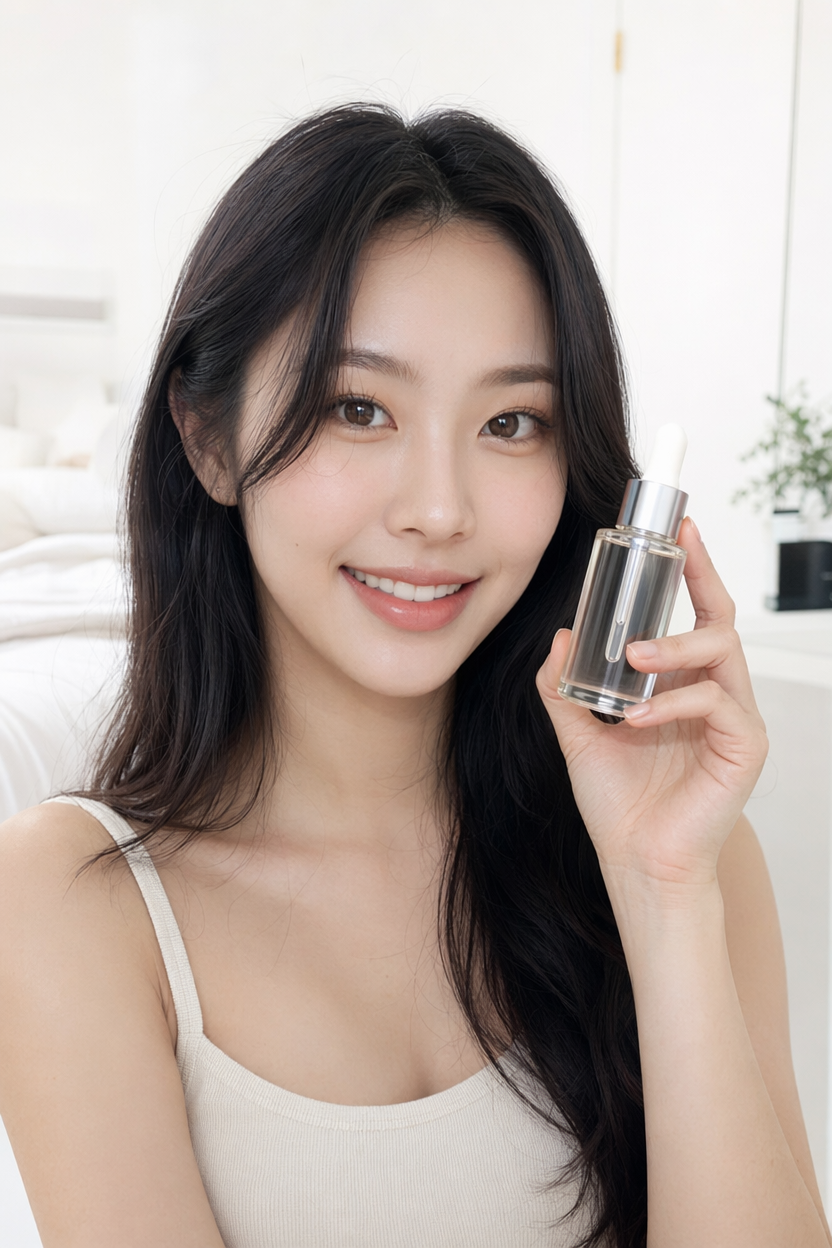
อวตาร AI ของผู้สร้างความงามกำลังนำเสนอเซรั่มบำรุงผิว
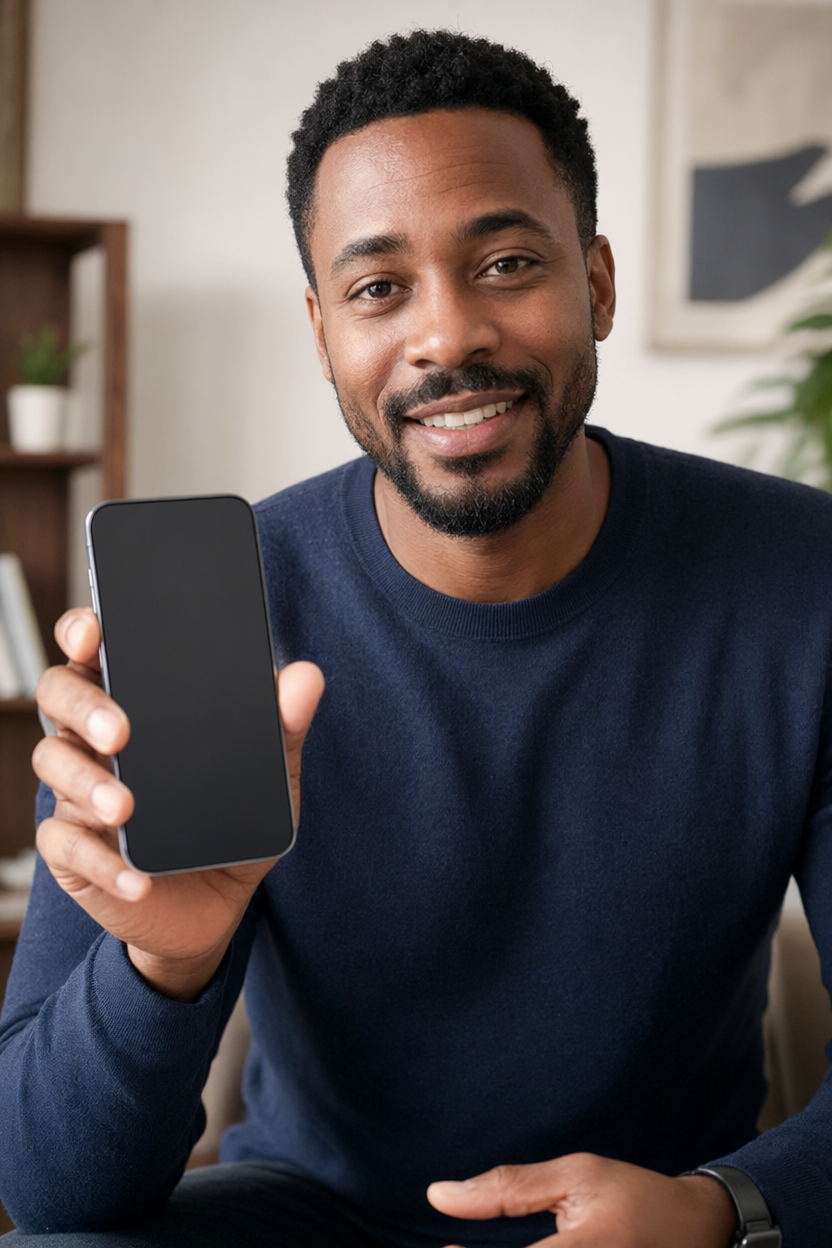
อวตาร AI ของนักรีวิวเทคโนโลยีที่กำลังนำเสนอสมาร์ทโฟน
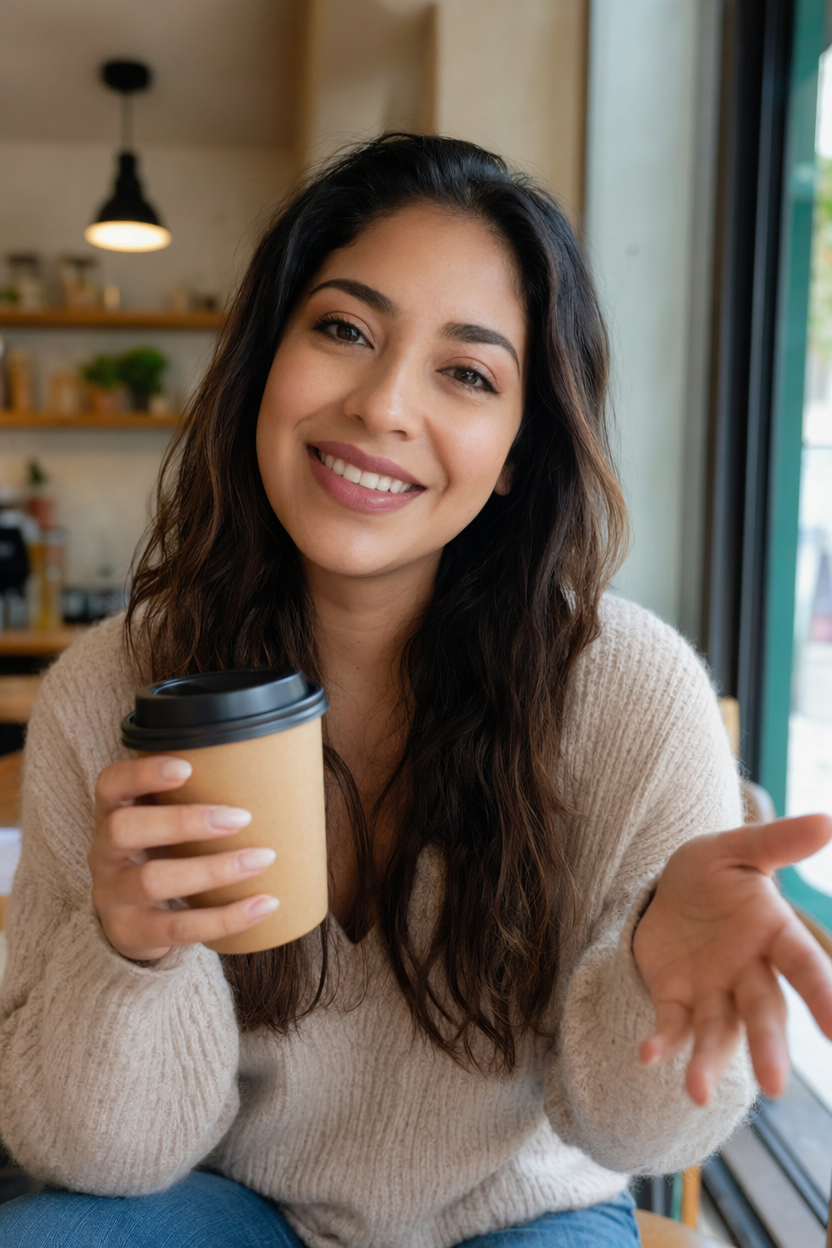
อวตาร AI ของผู้สร้างไลฟ์สไตล์ถือถ้วยกาแฟ
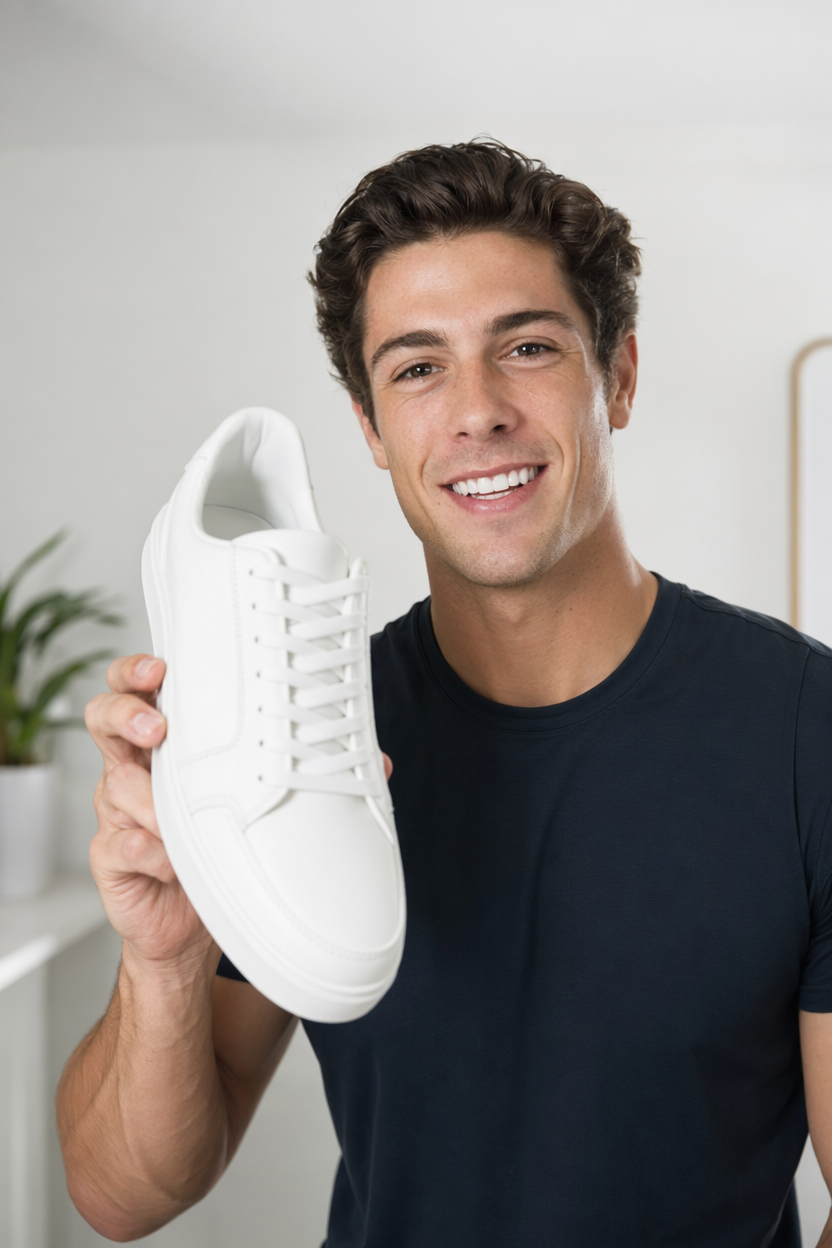
อวตาร AI ของผู้รีวิวรองเท้าผ้าใบกำลังนำเสนอรองเท้า
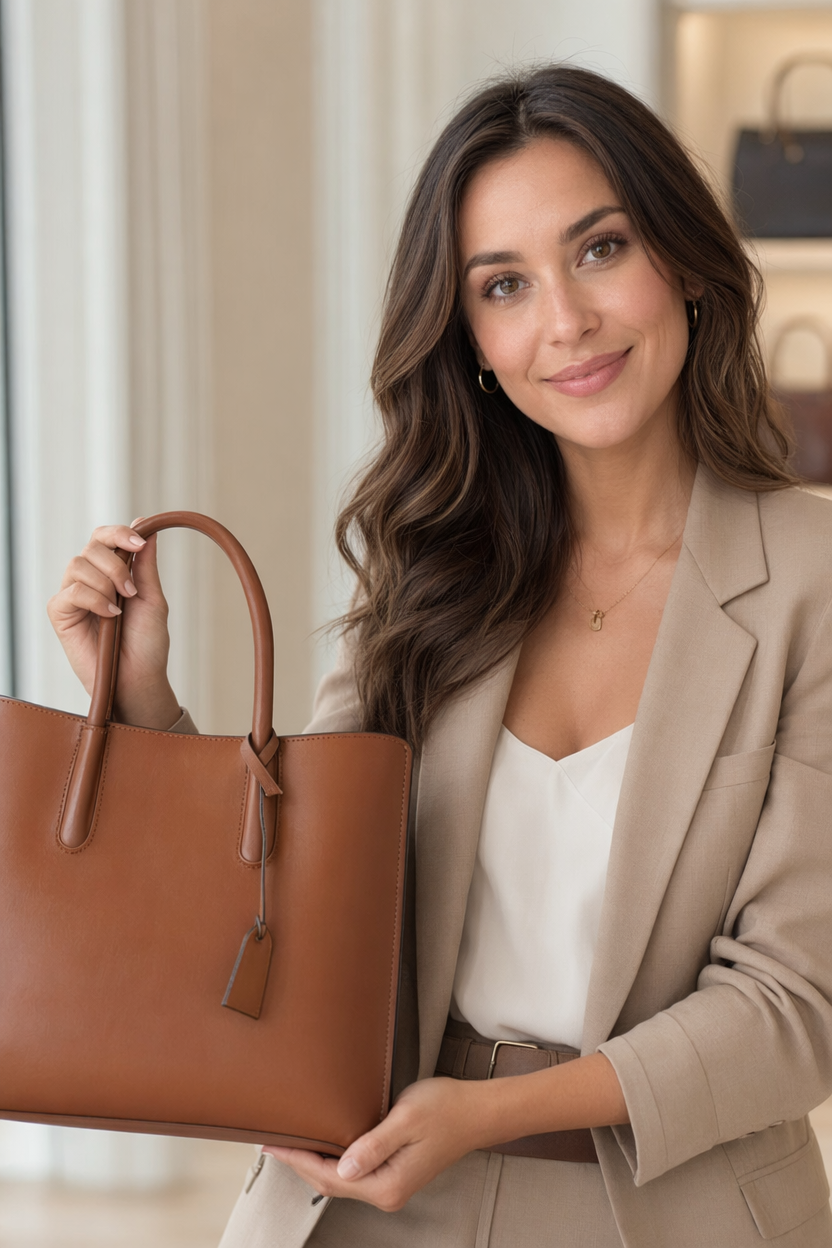
อวตาร AI ของนักออกแบบแฟชั่นพร้อมกระเป๋าถือ
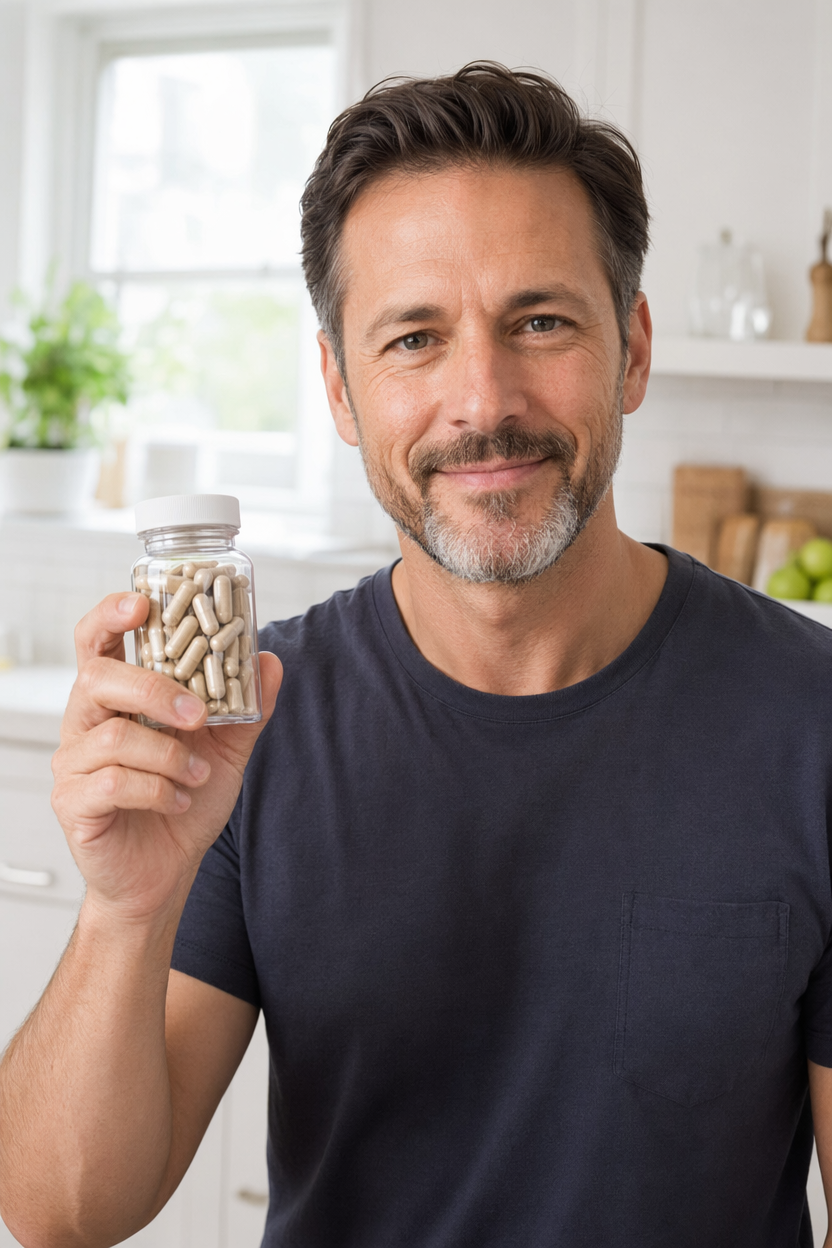
อวตาร AI ของผู้สร้างสรรค์ผลิตภัณฑ์เพื่อสุขภาพ กำลังนำเสนอผลิตภัณฑ์เสริมอาหาร
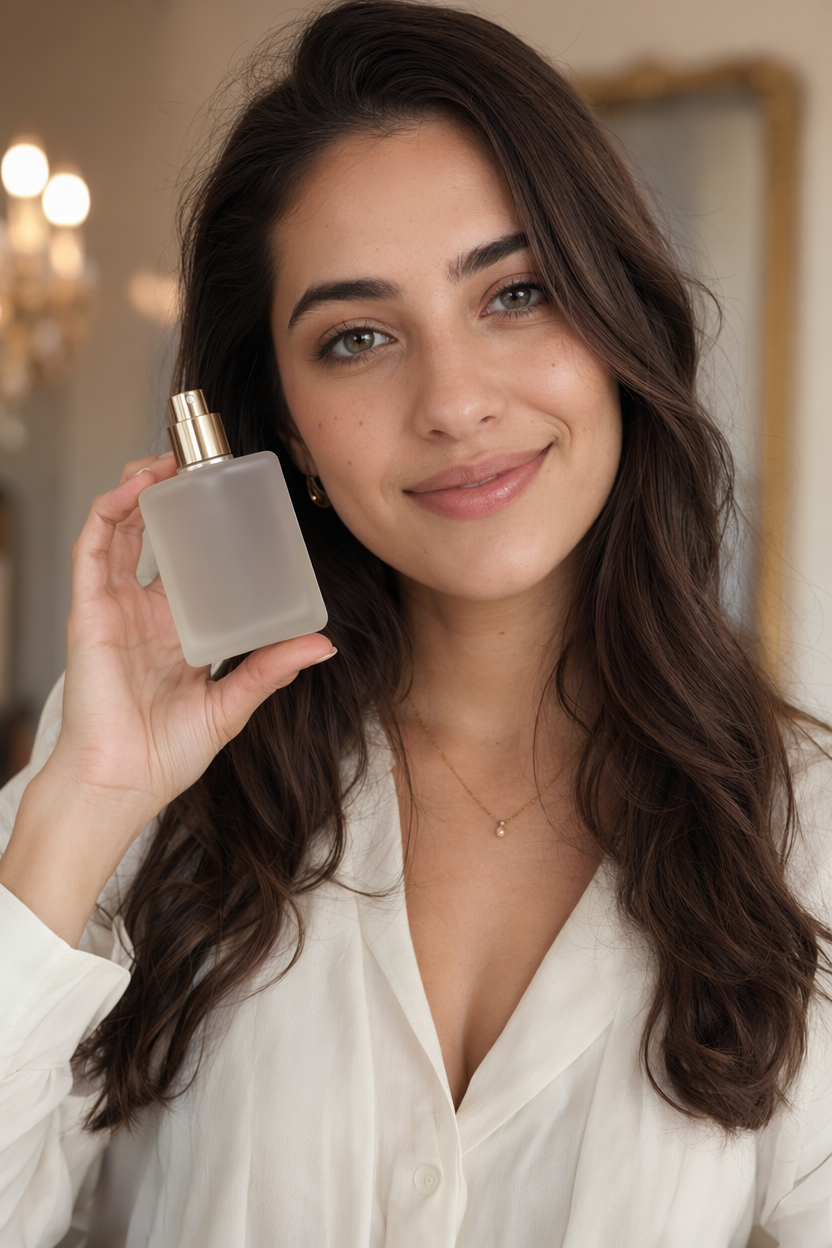
อวตาร AI ของผู้เชี่ยวชาญด้านความงามพร้อมขวดน้ำหอม
อวตาร AI ของผู้สร้างสรรค์รายการทำอาหารที่บ้านพร้อมอุปกรณ์ครัว

โมเดลที่อยู่เบื้องหลังตัวสร้างภาพถ่ายพูดได้ AI ตัวนี้

OmniHuman 1.5 คือตัวขับเคลื่อนการขยับปาก สีหน้า และการเคลื่อนไหวร่างกายบนหน้านี้

ข้อมูลจำเพาะของภาพถ่ายพูดได้ AI

อินพุตภาพบุคคลหนึ่งภาพ บวกไฟล์เสียงที่อัปโหลดหรือสคริปต์ที่พิมพ์เอง อย่างใดอย่างหนึ่ง
ภาพของใครภาพของคุณเอง หรือของบุคคลที่ให้สิทธิ์คุณแล้ว ทั้งภาพถ่ายและเสียงต้องเป็นของที่คุณมีสิทธิ์ใช้
คำแนะนำเรื่องภาพบุคคลหันหน้าตรง แสงดี เห็นใบหน้าทั้งหมดและอยู่ในโฟกัส แว่นกันแดดและเงาเข้ม ๆ จะลดความแม่นของลิปซิงก์
ความยาวเสียงสูงสุด 35 วินาทีต่อการสร้างหนึ่งครั้ง — ราว 85 คำพูด
คลังเสียงเสียงในตัว 60 แบบ ครอบคลุม 10 ภาษา ฟังตัวอย่างได้ก่อนสร้าง
โมเดลOmniHuman 1.5 ซึ่งขับเคลื่อนลิปซิงก์ สีหน้า และการเคลื่อนไหวของศีรษะและร่างกายที่เป็นธรรมชาติ
ค่าใช้จ่ายคิดค่าใช้จ่ายตามวินาทีของผลลัพธ์เหมือนการสร้างวิดีโออื่น ๆ และแสดงให้เห็นก่อนคุณกดสร้าง
เอาต์พุตคลิปที่ดาวน์โหลดได้ บันทึกไว้ในประวัติพร้อมภาพบุคคลต้นฉบับและสคริปต์

วิธีแสดงในภาพถ่ายพูดได้ AI ของคุณเอง

ภาพของคุณ ถ้อยคำของคุณ คลิปเดียวจบ

  1. 1

    อัปโหลดภาพถ่ายของคุณ

    ภาพถ่ายหันหน้าตรงที่ชัดเจนให้ผลดีที่สุด: เซลฟีจากมือถือ ภาพถ่ายครึ่งตัว หรือเฟรมจากวิดีโอ AI ภาพถ่ายพูดได้จะอ่านใบหน้าของคุณจากเฟรมเดียวนี้

  2. 2

    เพิ่มเสียงของคุณ

    บันทึกเสียงตัวเองแล้วอัปโหลด หรือพิมพ์สคริปต์แล้วเลือกหนึ่งใน 60 เสียงพูดในตัว เสียงยาวได้สูงสุด 35 วินาที

  3. 3

    สร้าง แล้วนำตัวเองกลับมาใช้ซ้ำ

    โมเดลจะซิงก์ริมฝีปาก สีหน้า และการขยับศีรษะอย่างเป็นธรรมชาติให้ตรงกับเสียง เก็บภาพเดิมไว้แล้วสร้างบทพูดใหม่ได้ทุกเมื่อที่ต้องการ โดยไม่ต้องถ่ายทำใหม่

วิธีเขียนสคริปต์สำหรับภาพถ่ายพูดได้ AI

ตรงนี้ไม่มีพรอมต์ภาพ — ภาพบุคคลกับเสียงเป็นตัวทำงาน สิ่งที่คุณเขียนคือสคริปต์ และการเลือกใช้คำในสคริปต์เป็นตัวตัดสินว่าผลลัพธ์จะดูเป็นธรรมชาติหรือไม่

1

ประโยคเปิด

เริ่มด้วยอะไรสั้น ๆ วินาทีแรกคือช่วงที่ลิปซิงก์ถูกมองเห็นชัดที่สุด

เฮ้ — ขอสั้น ๆ แป๊บนึงนะ

2

ความยาวประโยค

ให้แต่ละประโยคยาวไม่เกินราว 15 คำ อนุประโยคยาว ๆ ทำให้เกิดจังหวะหยุดที่ไม่เป็นธรรมชาติ

เซรั่มขวดนี้มีสองส่วนผสม นั่นคือทั้งหมดของสูตร

3

เครื่องหมายวรรคตอน

เครื่องหมายจุลภาคและจุดจะกลายเป็นจังหวะหายใจ ใส่ไว้ตรงที่คุณจะหยุดจริง ๆ

มันได้ผลจริง — และใช้เวลาแค่สิบวินาที

4

งบความยาว

ประมาณ 2.5 คำต่อวินาที เขียนให้พอดีกับความยาวคลิปที่คุณต้องการ

ราว 85 คำสำหรับคลิป 35 วินาที

แบบคลุมเครือ

ผลิตภัณฑ์อันปฏิวัติวงการของเราใช้เทคโนโลยีล้ำสมัยเพื่อส่งมอบผลลัพธ์ที่ไร้ผู้ใดเทียบทานสำหรับลูกค้าผู้พิถีพิถันที่มองหาความเป็นเลิศ

แบบเจาะจง

นี่คือส่วนที่ทุกคนถามเสมอ สองส่วนผสม ไม่มีตัวเติม คุณจะเห็นความต่างในราวหนึ่งสัปดาห์

ทำไมถึงได้ผล

อันแรกเป็นประโยคเดียวยาว 19 คำที่เต็มไปด้วยคำนามธรรม อวตารจึงอ่านออกมาแบนราบและไม่มีจังหวะหายใจ เพราะไม่มีที่ให้หยุดเลย อันที่สองเป็นสามประโยคสั้นที่มีจุดเน้นเป็นธรรมชาติ ซึ่งเป็นสิ่งที่ทำให้การอ่านฟังดูเหมือนคนจริง

แบบคลุมเครือ

สวัสดีค่ะ และขอต้อนรับสู่ช่องของเรา ซึ่งวันนี้เราจะมาพูดคุยกันถึงห้าสิ่งที่สำคัญที่สุดที่คุณจำเป็นต้องรู้เกี่ยวกับกิจวัตรการดูแลผิว

แบบเจาะจง

ห้าเรื่องเกี่ยวกับการดูแลผิว ข้อแรกคือข้อที่คนส่วนใหญ่เข้าใจผิด

ทำไมถึงได้ผล

ประโยคเปิดยาว ๆ ที่ไม่มีจังหวะหยุด คือจุดที่ลิปซิงก์เพี้ยนมากที่สุด เพราะโมเดลไม่มีเครื่องหมายวรรคตอนให้ยึด ประโยคเปิดสั้น ๆ ให้จุดเน้นที่ชัดเจนและดึงความสนใจได้ดีกว่า

นิสัยที่ควรเลิก

  • ใช้ภาพบุคคลที่ใบหน้าเล็ก เอียง หรือมีเงาบังบางส่วน ความแม่นของลิปซิงก์ขึ้นอยู่กับว่าเห็นปากในเฟรมต้นฉบับชัดแค่ไหนโดยตรง
  • เขียนเกินขีดจำกัดของเสียง การสร้างจำกัดที่เสียง 35 วินาที — สคริปต์ที่ยาวกว่านั้นจะถูกตัด ให้แบ่งเป็นท่อน ๆ แล้วใช้ภาพบุคคลเดิมซ้ำ
  • ถ้อยคำเทคนิคที่อัดแน่นเกินไป ตัวเลข ตัวย่อ และชื่อสินค้ายาว ๆ คือจุดที่เสียงสังเคราะห์ฟังดูเป็นเสียงสังเคราะห์ชัดที่สุด เขียนแบบที่คุณจะพูดออกมาจริง ๆ

มากกว่าเครื่องมือสร้างวิดีโออวตาร AI

อวตารพูดได้เป็นเพียงผลลัพธ์แบบหนึ่ง การสร้างภาพและวิดีโอก็ทำงานจากบัญชีเดียวกัน

แหล่งข้อมูลที่มีประโยชน์เกี่ยวกับวิดีโออวตาร AI

ราคาของภาพถ่ายพูดได้ AI และเครดิตฟรี

วิดีโอภาพถ่ายพูดได้คิดค่าบริการต่อวินาทีเช่นเดียวกับวิดีโอเอาต์พุตอื่น ๆ บัญชีใหม่ได้รับเครดิตฟรี 200 เครดิตเพื่อลองใช้งาน

Free

$0

เหมาะสำหรับการเริ่มต้น

  • เครดิตต้อนรับ 200 ใช้ได้สูงสุด 80 ต่อวัน
  • Z Image Turbo ร่างภาพที่ 0 เครดิต
  • ความเร็วในการสร้างมาตรฐาน
  • รวมประวัติการสร้างภาพ
เริ่มต้นใช้งาน

Premium

ยอดนิยมที่สุด
$29/month

เรียกเก็บเงินรายปี · $240/ปี

  • 8,000 เครดิต/เดือน ไม่มีขีดจำกัดรายวัน
  • โมเดลพรีเมียมทั้งหมด — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • ความเร็วในการสร้างเร็วขึ้น 5 เท่า พร้อมคิวลำดับความสำคัญ
  • การปรับปรุงพรอมต์ด้วย AI
อัปเกรดเป็น Premium

Ultimate

$59/month

เรียกเก็บเงินรายปี · $468/ปี

  • 18,000 เครดิต/เดือน ไม่มีขีดจำกัดรายวัน
  • การสร้างภาพความละเอียดสูงสูงสุดถึง 4K
  • การซัพพอร์ตแบบเร่งด่วน
  • คิวที่เร็วที่สุดและสิทธิ์เข้าถึงโมเดลใหม่ก่อนใคร
อัปเกรดเป็น Ultimate

ภาพถ่ายพูดได้ AI — คำถามที่พบบ่อย

1

ภาพถ่ายพูดได้ AI คืออะไร?

ภาพถ่ายพูดได้ AI ซึ่งเรียกอีกอย่างว่าอวาทาร์ AI หรือมนุษย์ดิจิทัล คือวิดีโอพูดที่สร้างขึ้นของบุคคลหนึ่ง ซึ่งสร้างจากภาพถ่ายเพียงภาพเดียวกับเสียงพูด แทนที่จะถ่ายทำ คุณเพียงให้ภาพบุคคลและเสียง (หรือสคริปต์ + เสียงพูด) แล้วโมเดลจะสร้างการแสดงพูดที่สมจริง — ใช้เป็นผู้นำเสนอดิจิทัล โฆษก หรือผู้บรรยาย

2

ฉันต้องใช้อะไรบ้างในการสร้าง?

เพียงแค่ใส่รูปถ่ายหน้าตรงที่ชัดเจน พร้อมกับไฟล์เสียง (mp3/wav) หรือในโหมดข้อความ ก็ใส่สคริปต์ที่ต้องการให้พูด และเลือกเสียงจากคลังเสียงในตัว ก็สามารถสร้างวิดีโออวตารพูดได้แล้ว

3

ฉันสามารถใช้เสียงของตัวเองได้ไหม?

ใช่ค่ะ คุณสามารถอัปโหลดไฟล์เสียงของคุณเอง แล้วตัวละครจะขยับปากตามเสียงนั้น หากคุณไม่มีไฟล์เสียง ให้เปลี่ยนเป็นโหมดข้อความ แล้วเลือกเสียงจากคลังเสียงแปลงข้อความเป็นเสียงพูดแทนค่ะ

4

วิดีโออวตารสามารถมีความยาวได้นานแค่ไหน?

สามารถบันทึกเสียงได้สูงสุด 35 วินาทีต่อครั้ง สำหรับสคริปต์ที่ยาวกว่านั้น ให้แบ่งออกเป็นหลายคลิป ระบบจะแสดงระยะเวลาโดยประมาณขณะที่คุณพิมพ์ และจะคิดค่าบริการตามวินาทีของเสียง

5

ฉันสามารถใช้ AI อวตารเพื่ออะไรได้บ้าง?

การใช้งานทั่วไป ได้แก่ การอธิบายผลิตภัณฑ์และโฆษณา การบรรยายในหลักสูตรและขั้นตอนการปฐมนิเทศ คลิปพูดคุยบนโซเชียลมีเดีย ประกาศ และข้อความหลายภาษา — ในทุกที่ที่คุณอาจต้องถ่ายทำผู้บรรยาย

6

โมเดลใดที่ขับเคลื่อนอวตาร AI?

CreateVision AI ใช้ OmniHuman 1.5 ของ ByteDance ซึ่งควบคุมการซิงค์ริมฝีปาก การเคลื่อนไหวศีรษะ และท่าทางต่างๆ จากเสียง ดูรายละเอียดทางเทคนิคได้ที่หน้าข้อมูลรุ่น OmniHuman 1.5

7

ภาพแบบไหนใช้กับเครื่องมือสร้างวิดีโออวตาร AI ได้ดีที่สุด

ภาพบุคคลหน้าตรงที่แสงเพียงพอ เห็นใบหน้าทั้งหมดและอยู่ในโฟกัส แว่นกันแดด เงาหนาทับใบหน้า มุมที่เอียงมากเกินไป หรือใบหน้าที่เล็กเกินไปในเฟรม ล้วนลดความแม่นยำของการขยับปาก

8

ฉันต้องอัดเสียงตัวเองไหม

ไม่ต้อง คุณพิมพ์บทแล้วเลือกเสียงจากคลังเสียงในตัวได้เลย ซึ่งมี 60 เสียงครอบคลุม 10 ภาษา และหากอยากใช้เสียงที่คุณอัดเอง ก็อัปโหลดได้เช่นกัน

9

ฉันสามารถแสดงในวิดีโอด้วยตัวเองได้ไหม?

ได้ และนี่คือการใช้งานที่พบมากที่สุด อัปโหลดภาพถ่ายของคุณ แล้วเลือกบันทึกเสียงของตัวเอง หรือพิมพ์สคริปต์แล้วเลือกเสียงจากคลังเสียง ผลลัพธ์คือตัวคุณที่กำลังพูดถ้อยคำของคุณ โดยไม่ต้องตั้งกล้อง ครีเอเตอร์หลายคนเก็บภาพดี ๆ ไว้ภาพเดียว แล้วสร้างคลิปใหม่จากภาพนั้นทุกสัปดาห์

10

ฉันสามารถใช้ภาพถ่ายพูดได้ AI เพื่อการพาณิชย์ได้ไหม?

ใช่ ภายใต้ข้อกำหนดการให้บริการของ CreateVision AI เนื้อหาที่คุณสร้างสามารถนำไปใช้เพื่อวัตถุประสงค์ส่วนตัวและเชิงพาณิชย์ได้ โดยให้เครดิตแก่ CreateVision AI ตามความเหมาะสม คุณต้องรับผิดชอบว่าตนมีสิทธิ์ในภาพถ่ายและเสียงที่อัปโหลด รวมถึงกฎการเปิดเผยการใช้ AI ใดๆ บนแพลตฟอร์มที่คุณเผยแพร่

11

ฉันเคยเอาตัวเองเข้าไปในวิดีโอด้วย Sora อันนี้เหมือนกันไหม

เป้าหมายเดียวกัน กลไกต่างกัน ที่นี่ภาพถ่ายของคุณคือตัวตน และเสียงหรือสคริปต์ของคุณขับเคลื่อนคำพูด ผลลัพธ์จึงเป็นคลิป talking-head ที่ซิงก์ริมฝีปาก ไม่ใช่ฉากที่คุณถูกหย่อนเข้าไป ใช้ได้กับภาพถ่ายใบเดียวใดก็ได้ ไม่ต้องลงทะเบียนด้วยวิดีโอ และไม่ขึ้นอยู่กับการที่แอปอื่นยังเปิดให้ใช้งานอยู่

สร้างภาพถ่ายพูดได้ AI ภาพแรกของคุณ

เริ่มสร้างสรรค์