自己出鏡,或打造一位數位代言人
不用拍攝,不用演員,不用綠幕。上傳一張清晰的自拍,你就是唸台詞的出鏡者,用你自己的聲音或聲音庫裡的聲音都可以。也可以用一位已經授權給你的人的照片,打造一位可重複使用的數位主持人,用於產品說明、課程開場、公告和廣告。隨時重新生成新台詞,無需補拍。
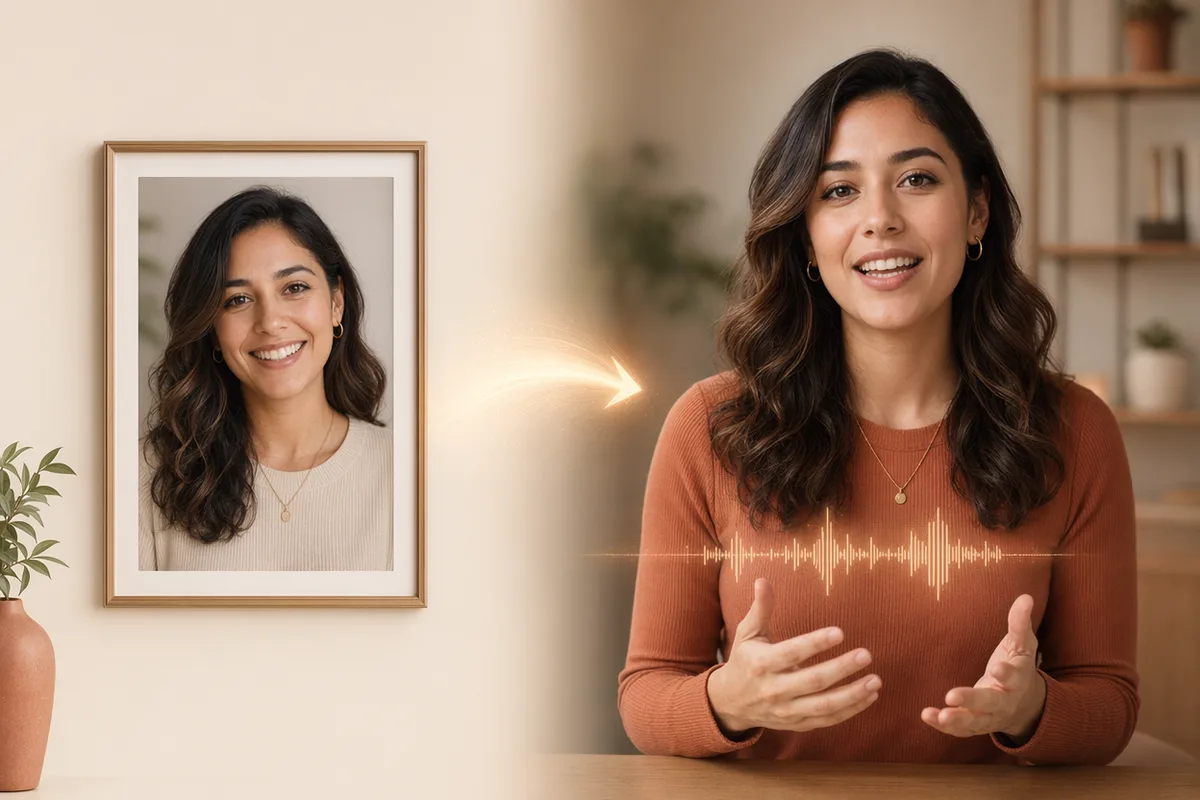
上傳一張人像和一段音訊(最長 35 秒),或輸入台詞並挑一個聲音,OmniHuman 1.5 就會把照片變成對嘴同步、動作自然的說話影片。用你自己的照片,自己出鏡。
一張人像加上腳本,就成為栩栩如生的代言人——口型、表情、手勢同步。免攝影機、免攝影棚。
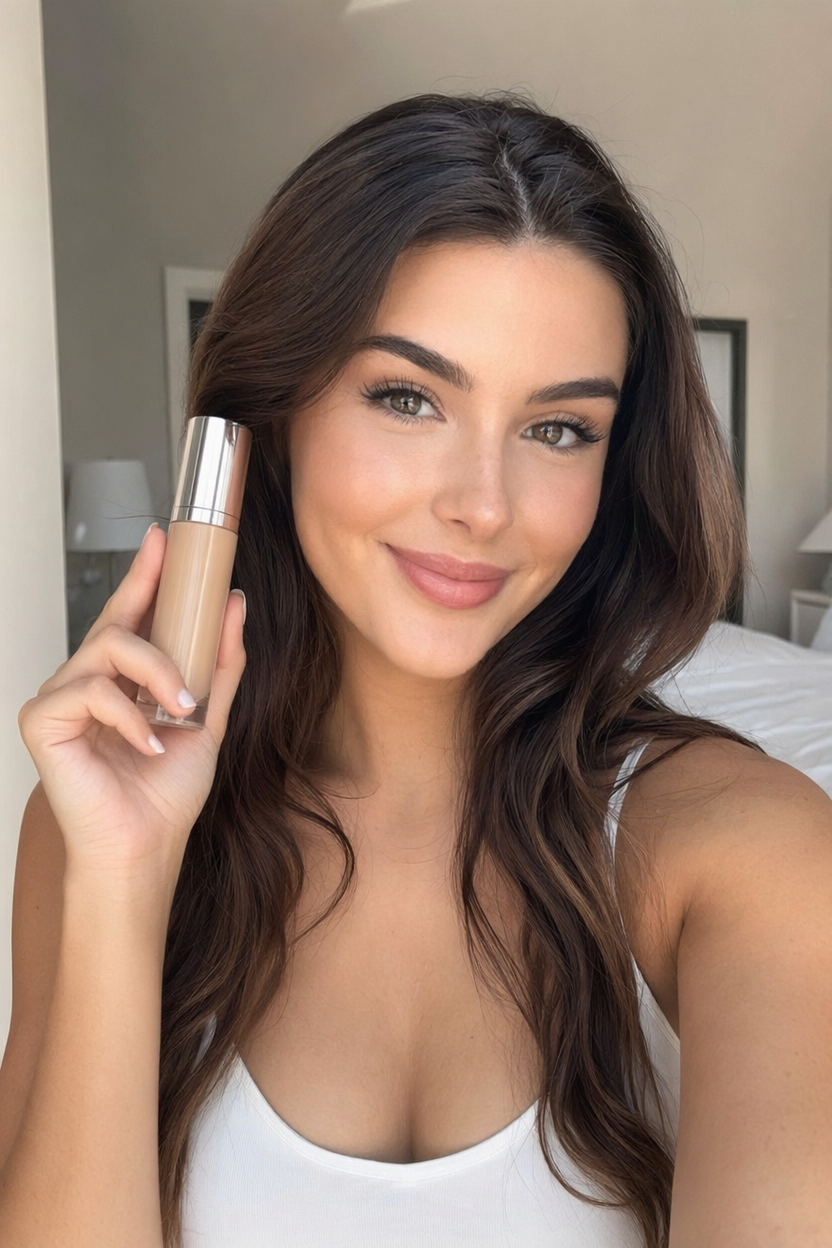
Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.
一個完整的 AI 會說話照片(數位人)生成器:上傳一張人像和一段音訊,或輸入台詞並挑一個聲音,就能得到對嘴同步、表情自然、帶手勢的逼真說話影片。用你自己的照片當出鏡者。由字節跳動 OmniHuman 1.5 驅動,不需要相機、演員或攝影棚。
不用拍攝,不用演員,不用綠幕。上傳一張清晰的自拍,你就是唸台詞的出鏡者,用你自己的聲音或聲音庫裡的聲音都可以。也可以用一位已經授權給你的人的照片,打造一位可重複使用的數位主持人,用於產品說明、課程開場、公告和廣告。隨時重新生成新台詞,無需補拍。
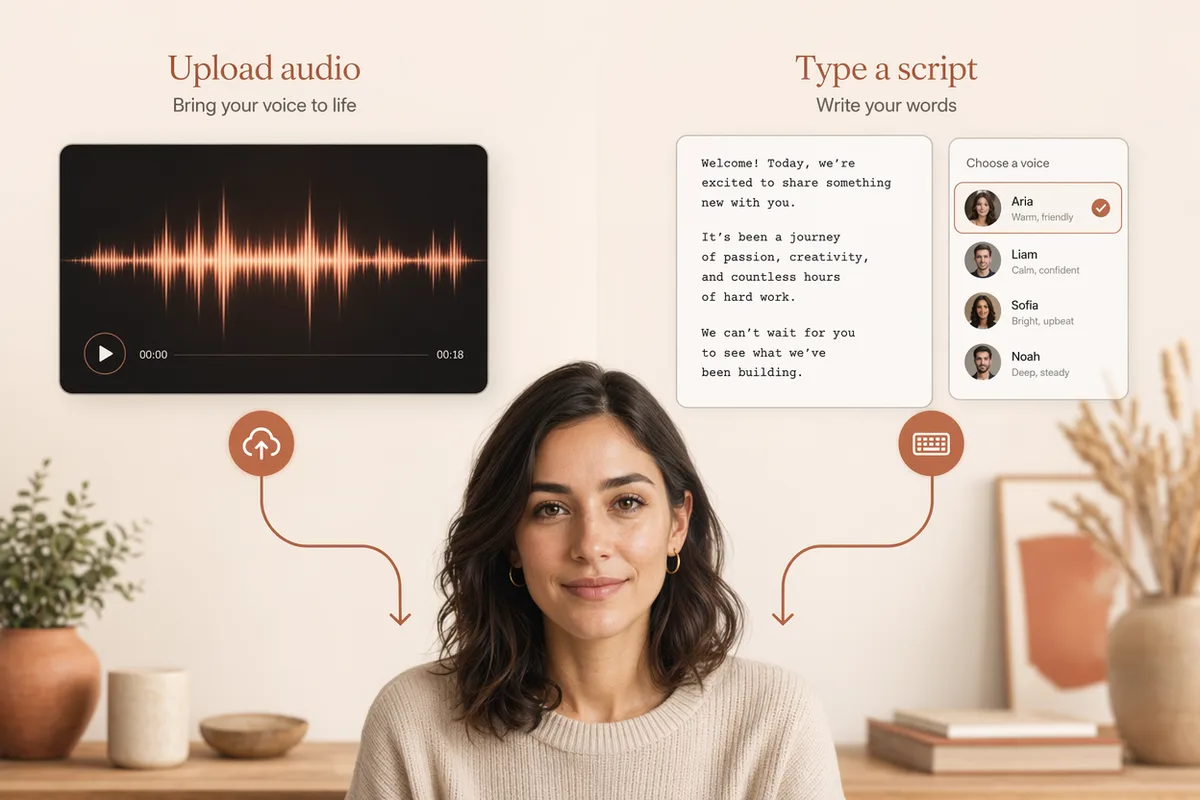
已經有錄音了?上傳後,虛擬形象會自動進行口型同步。沒有音訊?切換到文字模式-輸入虛擬形象應該說的話,從內建的文字轉語音庫中選擇一個語音,系統會自動將腳本合成到駕駛語音中。生成前會顯示預計時長和所需積分。
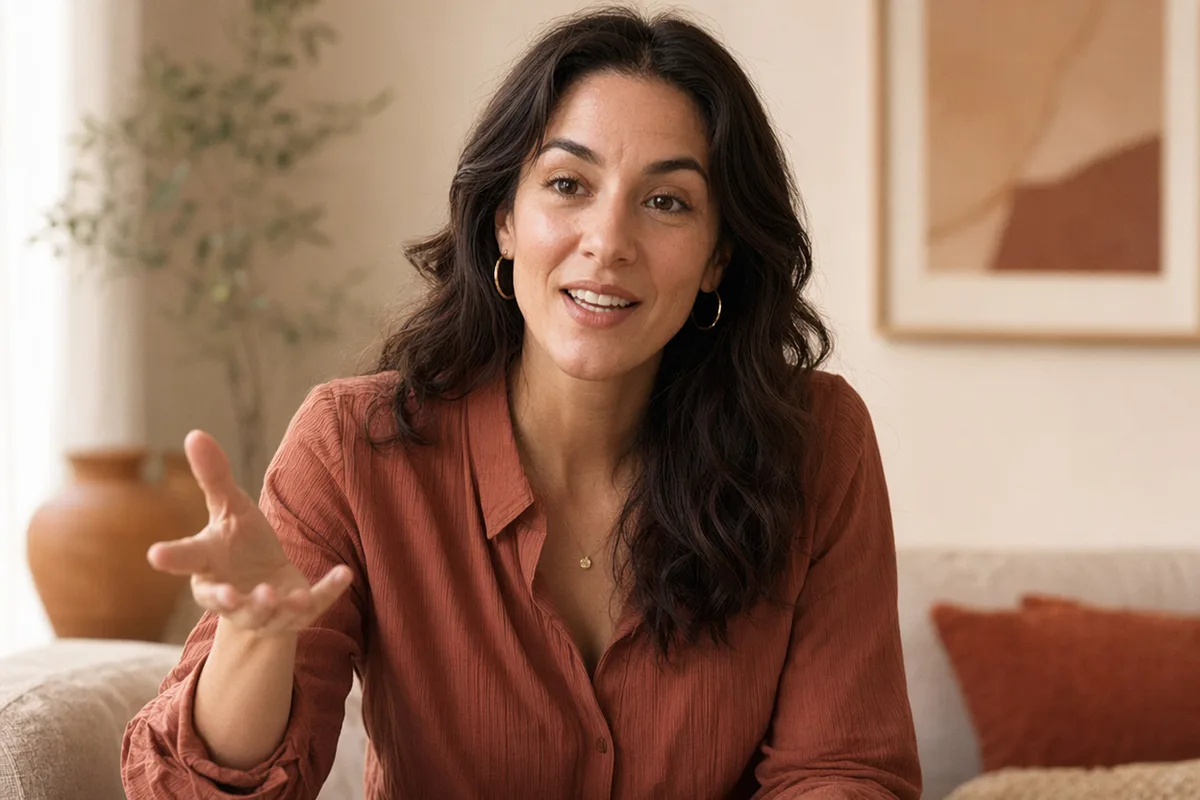
OmniHuman 1.5 能夠解讀音訊的節奏、韻律和意義,從而驅動頭部動作、姿勢和手勢,並實現精準的唇形同步,同時保留人物的身份特徵和光照效果。最終呈現的效果如同真人演講者一般生動自然,而非僅僅是一張嘴巴會動的靜態肖像。
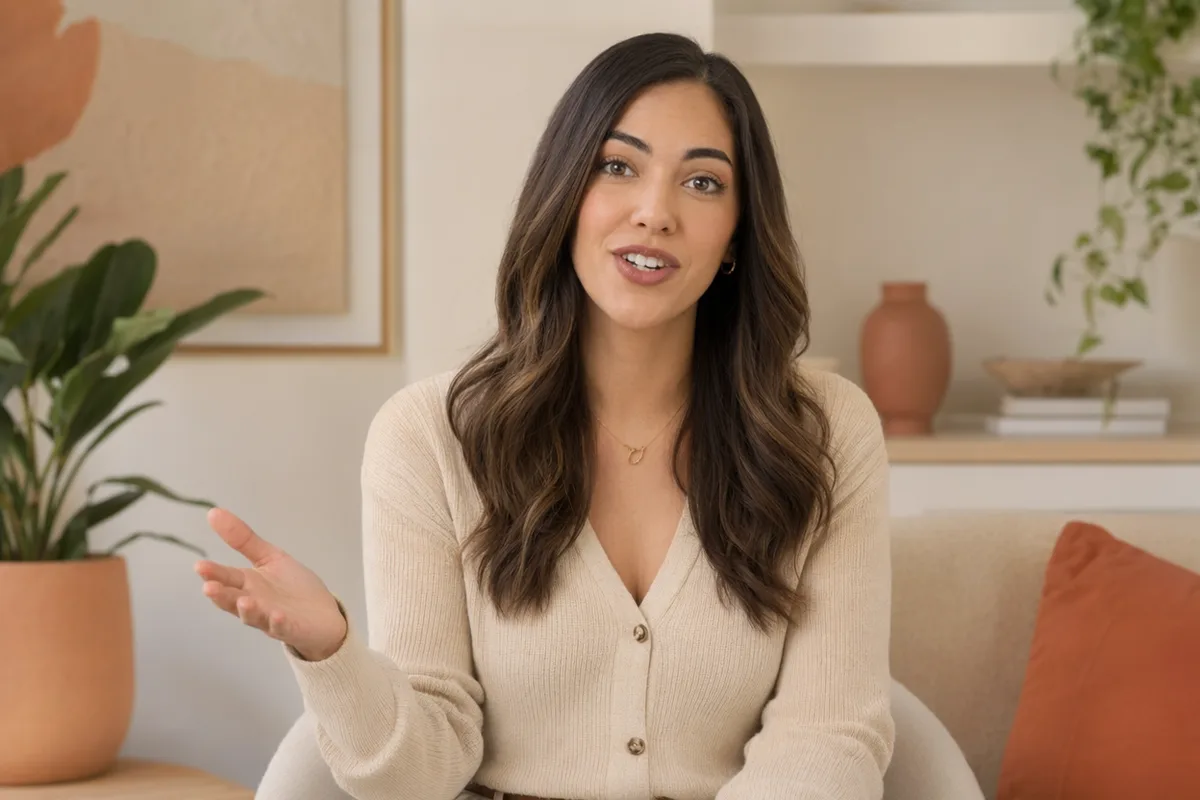
您可以快速製作用於廣告和落地頁的發言人視頻、用於培訓的旁白課程和入門教程、用於社交媒體的真人出鏡視頻,或者同一信息的多種語言版本。每一代內容及其輸入都會儲存到歷史記錄中,因此您可以快速迭代並產生各種版本。
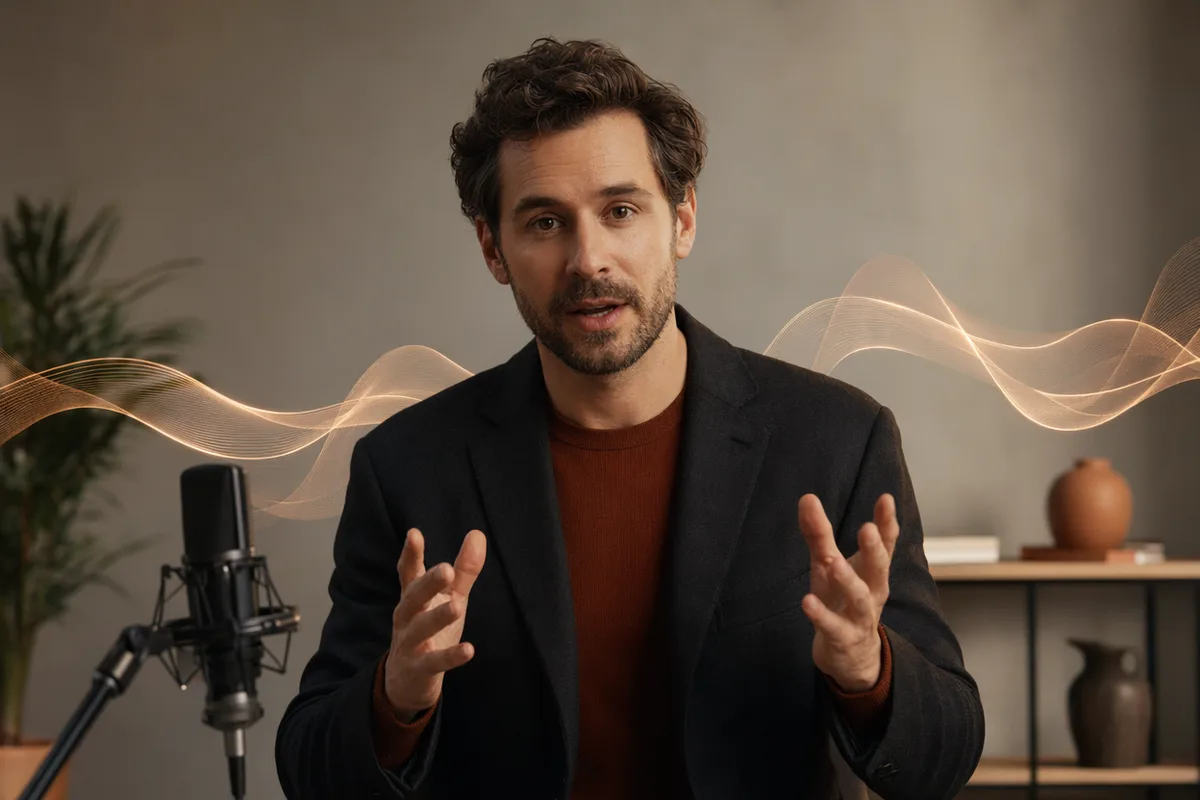
在 CreateVision AI 上生成的主播風格人像——只要加上音訊,其中任何一張都能驅動一段會說話的數字人影片。
本頁的對嘴、表情與肢體動作,由 OmniHuman 1.5 驅動。
| 輸入 | 一張人像照片,再加上一個上傳的音訊檔案或一段打好的腳本。 |
|---|---|
| 誰的照片 | 你自己的,或已經授權給你的人的。照片和聲音都必須是你有權使用的。 |
| 人像照片建議 | 正面、光線充足、整張臉完整可見且對焦清楚。墨鏡和濃重陰影會降低對嘴的準確度。 |
| 音訊長度 | 每次生成最長 35 秒——大約 85 個口說字詞。 |
| 音色庫 | 內建 60 種音色,涵蓋 10 種語言,生成前可先試聽。 |
| 模型 | OmniHuman 1.5,負責驅動對嘴、臉部表情,以及自然的頭部與身體動作。 |
| 費用 | 和其他影片生成一樣,按輸出秒數計費;生成前會先顯示。 |
| 輸出 | 一段可下載的影片,連同原始人像與腳本一起存進你的歷史紀錄。 |
你的照片,你的話,一支影片。
清晰的正面照效果最好:手機自拍、大頭照,或影片裡截的一格都行。會說話照片 AI 只憑這一格讀取你的臉。
自己錄一段上傳,或輸入台詞並從 60 個內建聲音裡挑一個。音訊最長 35 秒。
模型會把嘴型、表情和自然的頭部動作對齊到音訊上。留著同一張照片,需要時隨時生成新台詞,不用補拍。
這裡沒有圖像提示詞——幹活的是人像和音訊。你寫的是腳本,而腳本上的取捨決定了成果看起來自不自然。
開頭寫短一點。第一秒是對嘴最容易被看清楚的地方。
嘿——簡單跟你說一件事。
句子控制在大約 15 個字以內。過長的子句會產生不自然的停頓。
這瓶精華只有兩種成分。整個配方就這樣。
逗號和句號會變成換氣。你真的會停頓的地方,就打上標點。
它有效——而且只要十秒鐘。
大約每秒 2.5 個字。照你想要的片段長度來寫。
35 秒的片段約需 85 個字
我們這款革命性產品運用尖端科技,為追求卓越的挑剔顧客交付無與倫比的成果。
這就是大家一直在問的那部分。兩種成分,沒有填充料。大概一週你就能看出差別。
第一段是一個 19 個字的抽象長句——虛擬人唸出來是平板、上氣不接下氣的單調語調,因為根本沒有可以換氣的地方。第二段是三個短句,有自然的重音點,這才是讓唸白聽起來像真人的原因。
大家好,歡迎來到我們的頻道,今天我們要討論的是關於保養流程你需要知道的五件最重要的事情。
關於保養的五件事。第一件,是大多數人都做錯的。
又長又不斷句的開場,是對嘴最容易走鐘的地方,因為模型沒有標點可以對齊。一句簡短的開場鉤子能給它乾淨的重音點,也更抓得住注意力。
會說話的虛擬人只是其中一種產出。圖片與影片生成都在同一個帳號裡運作。
會說話照片影片和其他影片輸出一樣按秒計費。新帳號註冊送 200 點數,可以先試試。
年繳 · $240/year
AI 會說話的照片,也叫 AI 數位人或虛擬分身,是用一張照片和一段聲音生成的人物說話影片。你不用拍攝,只需提供一張人像和音訊(或台詞 + 聲音),模型就會生成一段逼真的說話表演,可用作數位主播、代言人或旁白。
一張清晰的正面人像照片,加上一段音訊(mp3/wav格式),或者——在文字模式下——你想朗讀的腳本以及從內建庫中選擇一個聲音。這就足以產生一個會說話的虛擬形象影片。
是的。上傳自己的錄音,虛擬形象就會自動進行口型同步。如果您沒有錄音,請切換到文字模式,然後從文字轉語音庫中選擇一個語音。
每代最多可錄製 35 秒音訊。如果腳本較長,請將其分割成多個片段。預估時長會在您輸入時顯示,音訊按秒計費。
常見用途包括產品說明和廣告、課程和新用戶引導旁白、社交媒體訪談片段、公告以及訊息的多種語言版本——任何需要拍攝主持人的場合。
CreateVision AI 使用了位元組跳動的 OmniHuman 1.5,它能夠根據音訊驅動唇形同步、頭部動作和手勢。有關技術細節,請參閱 OmniHuman 1.5 模型頁面。
光線充足、面向鏡頭、整張臉完整清晰的人像。墨鏡、臉上的濃重陰影、極端角度,或臉在畫面中佔比太小,都會降低對嘴的準確度。
不用。你可以直接打字寫台詞,再從內建音色庫裡挑一個聲音,庫裡有涵蓋 10 種語言的 60 個音色。如果你比較想用自己的錄音,也支援上傳。
可以,這也是最常見的用法。上傳一張你自己的照片,然後要麼錄自己的聲音,要麼輸入台詞並選一個聲音庫裡的聲音。結果就是你本人在說你的話,不需要架相機。很多創作者留著一張好照片,每週都用它生成新的短片。
可以。根據 CreateVision AI 服務條款,你生成的內容可用於個人和商業用途,在合適的場合註明由 CreateVision AI 生成即可。你需要自行確保對上傳的照片和聲音擁有使用權,並遵守發布平台關於 AI 內容標示的規則。
目標一樣,原理不同。這裡你的照片就是身分,音訊或台詞驅動說話,所以產出是一支對嘴同步的出鏡短片,而不是把你放進某個場景。它只需要任意一張照片,不用錄影登記,也不依賴別的應用程式是否還在。