自己出镜,或者打造一个数字代言人
不用拍摄,不用演员,不用绿幕。上传一张清晰的自拍,你就是念台词的出镜人,用你自己的声音或音色库里的声音都可以。也可以用一位已经授权给你的人的照片,打造一个可反复使用的数字主持人,用于产品讲解、课程开场、公告和广告。随时重新生成新台词,无需补拍。
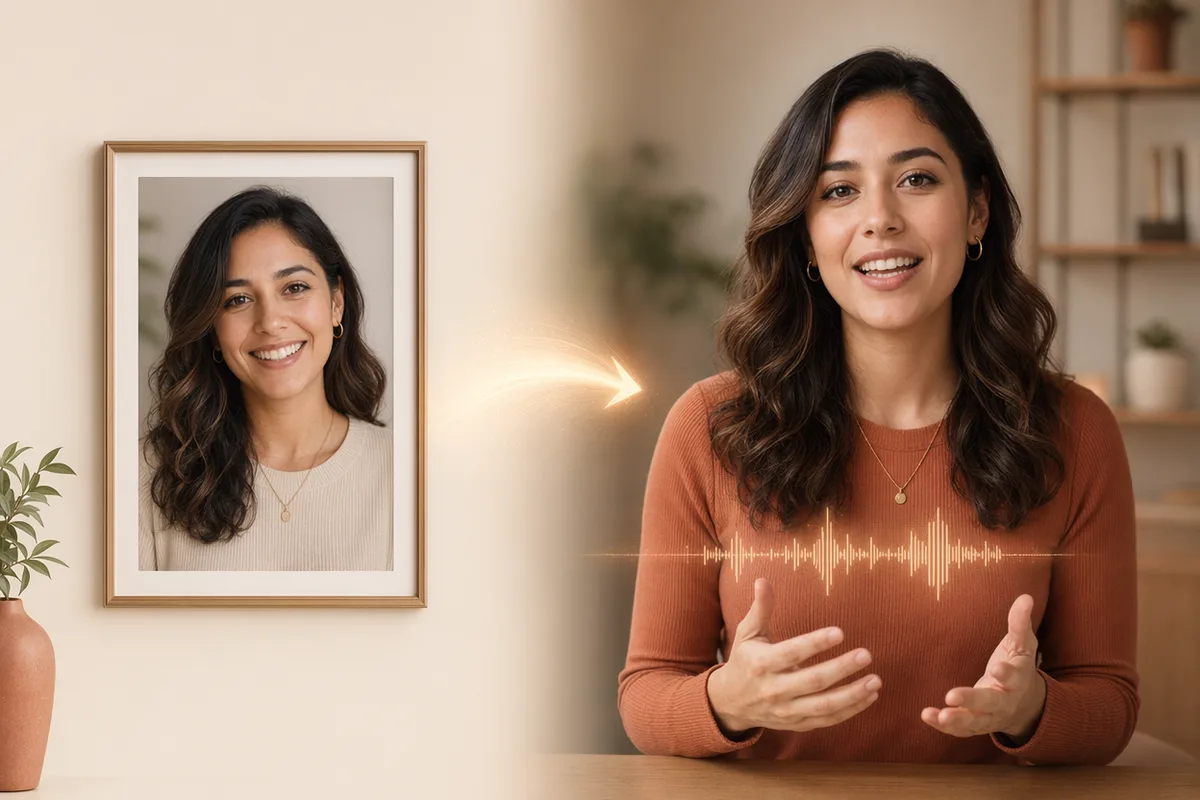
上传一张肖像和一段音频(最长 35 秒),或者输入台词并挑一个音色,OmniHuman 1.5 就会把照片变成口型同步、动作自然的说话视频。用你自己的照片,自己出镜。
一张人像加一段脚本,就变成栩栩如生的代言人——口型、表情、手势同步。无需相机、无需摄影棚。
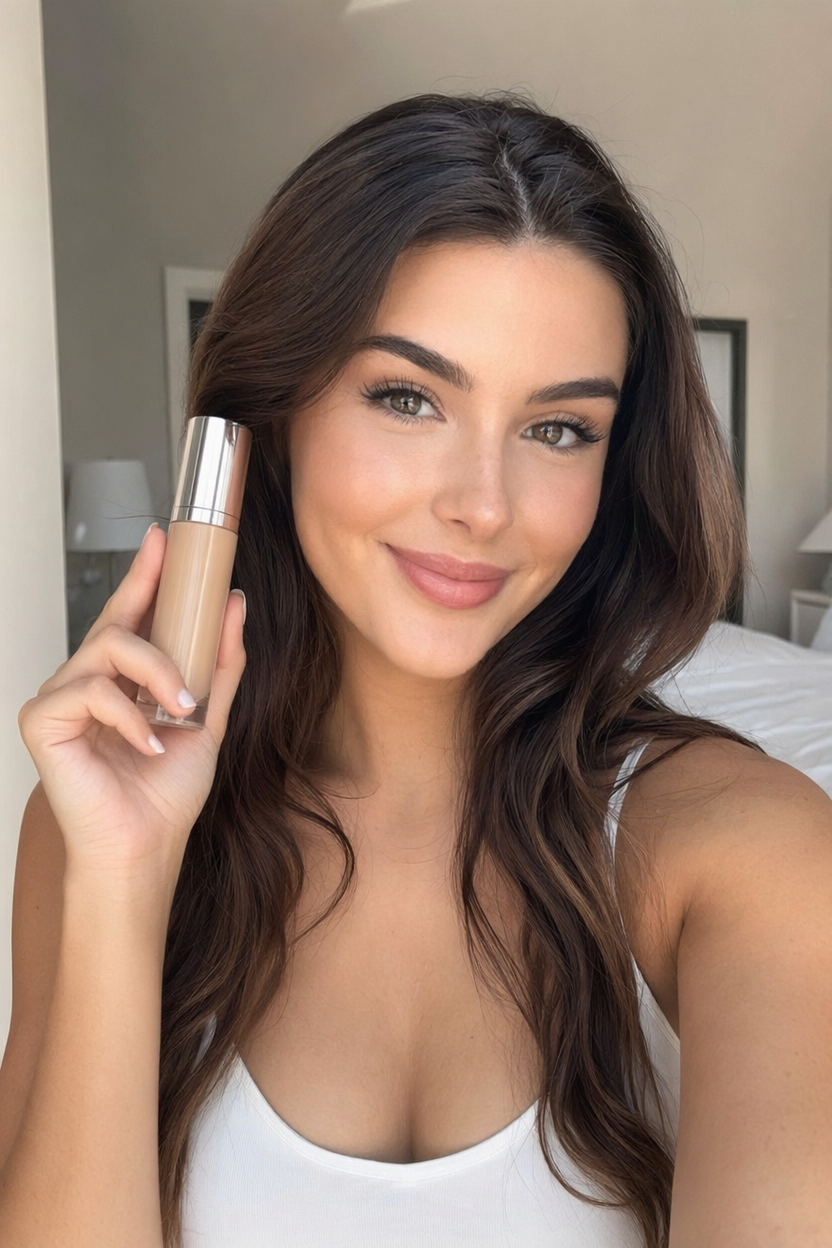
Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.
一个完整的 AI 会说话照片(数字人)生成器:上传一张肖像和一段音频,或者输入台词并挑一个音色,就能得到口型同步、表情自然、带手势的逼真说话视频。用你自己的照片当出镜人。由字节跳动 OmniHuman 1.5 驱动,不需要相机、演员或摄影棚。
不用拍摄,不用演员,不用绿幕。上传一张清晰的自拍,你就是念台词的出镜人,用你自己的声音或音色库里的声音都可以。也可以用一位已经授权给你的人的照片,打造一个可反复使用的数字主持人,用于产品讲解、课程开场、公告和广告。随时重新生成新台词,无需补拍。
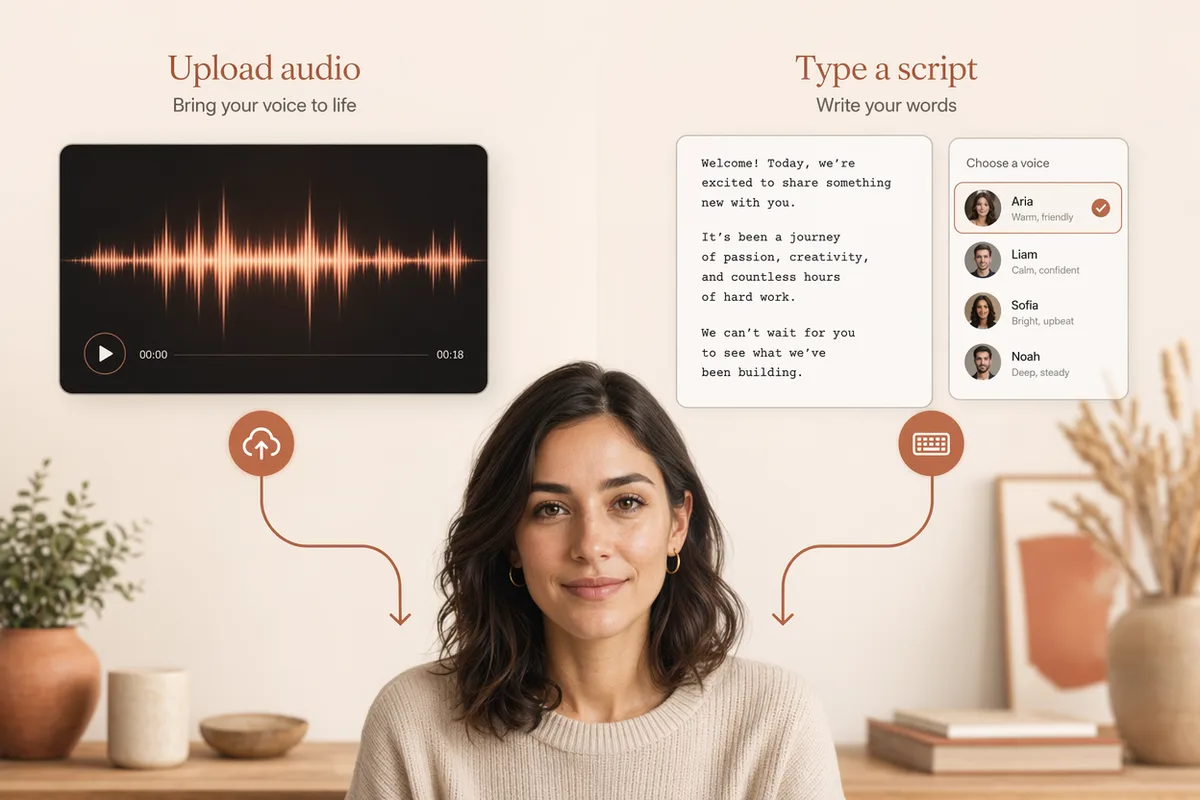
已经有录音了?上传后,虚拟形象会自动进行口型同步。没有音频?切换到文本模式——输入虚拟形象应该说的话,从内置的文本转语音库中选择一个语音,系统会自动将脚本合成到驾驶语音中。生成前会显示预计时长和所需积分。
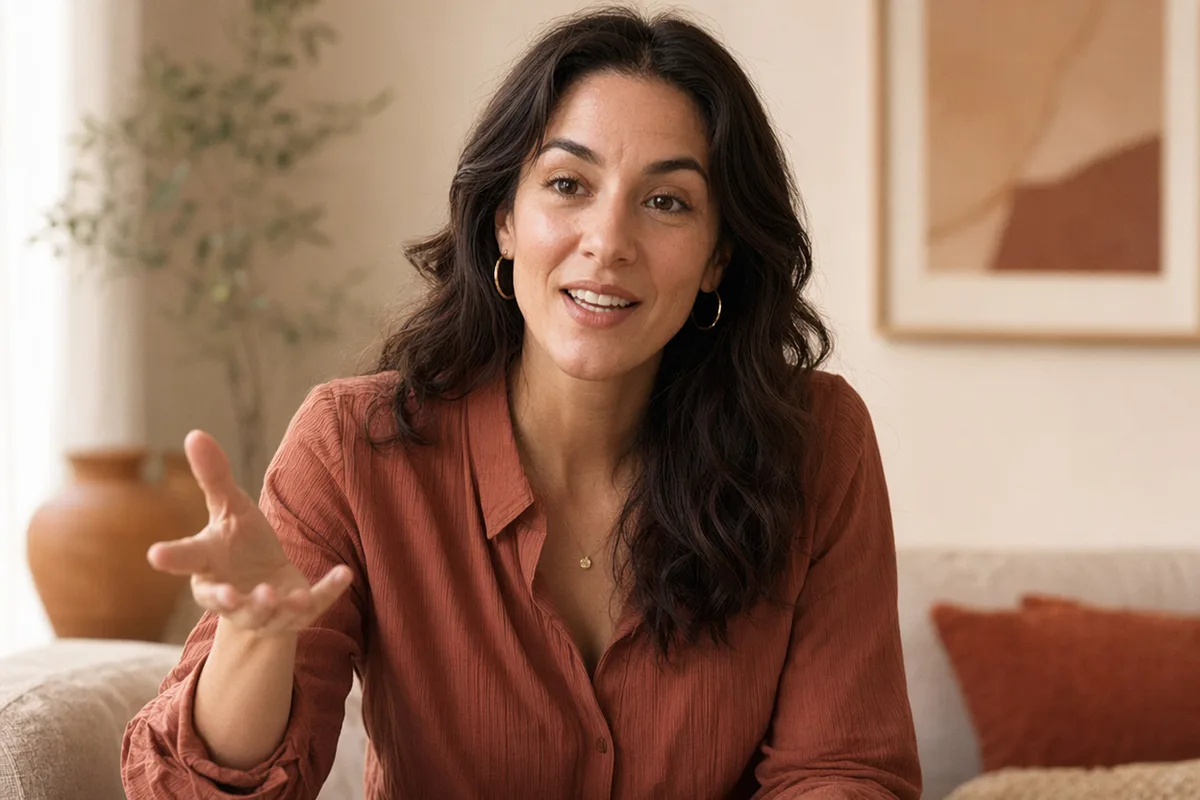
OmniHuman 1.5 能够解读音频的节奏、韵律和含义,从而驱动头部动作、姿势和手势,并实现精准的唇形同步,同时保留人物的身份特征和光照效果。最终呈现的效果如同真人演讲者一般生动自然,而非仅仅是一张嘴巴会动的静态肖像。
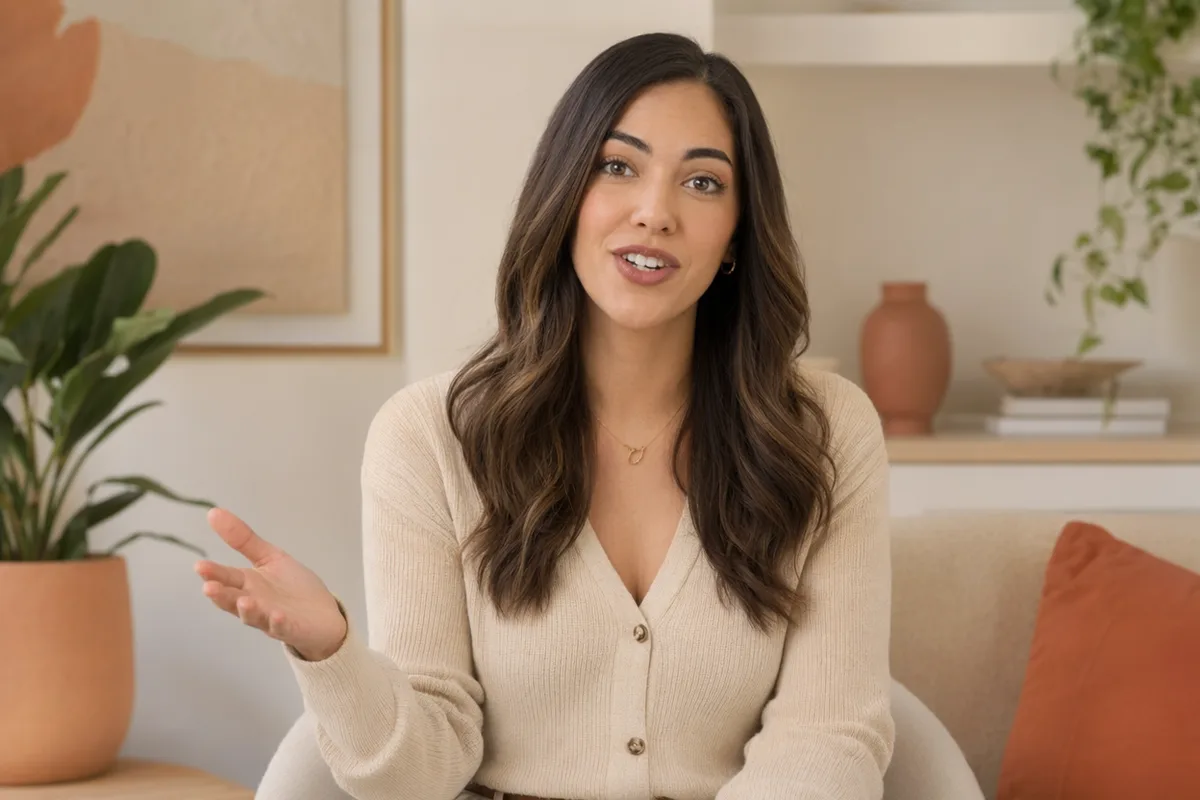
您可以快速制作用于广告和落地页的发言人视频、用于培训的旁白课程和入门教程、用于社交媒体的真人出镜视频,或者同一信息的多种语言版本。每一代内容及其输入都会被保存到历史记录中,因此您可以快速迭代并生成各种版本。
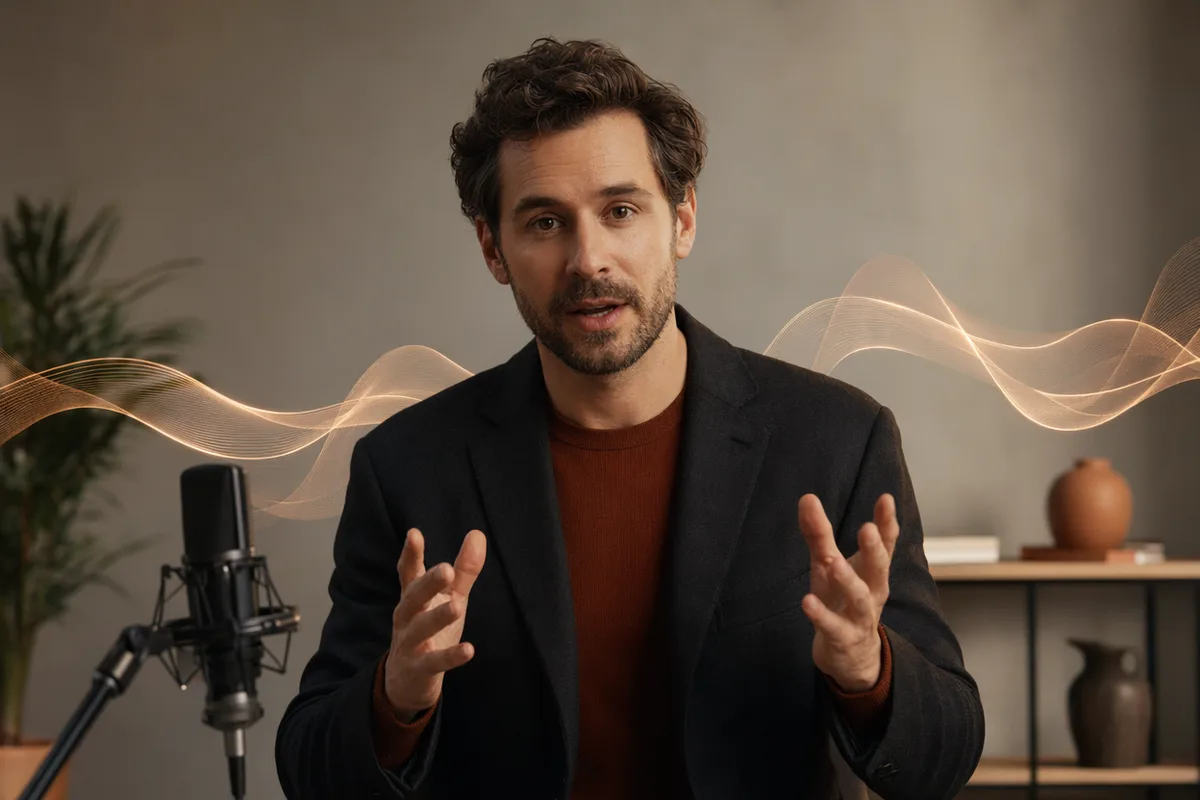
在 CreateVision AI 上生成的主播风格人像——只要加上音频,其中任何一张都能驱动一段会说话的数字人视频。
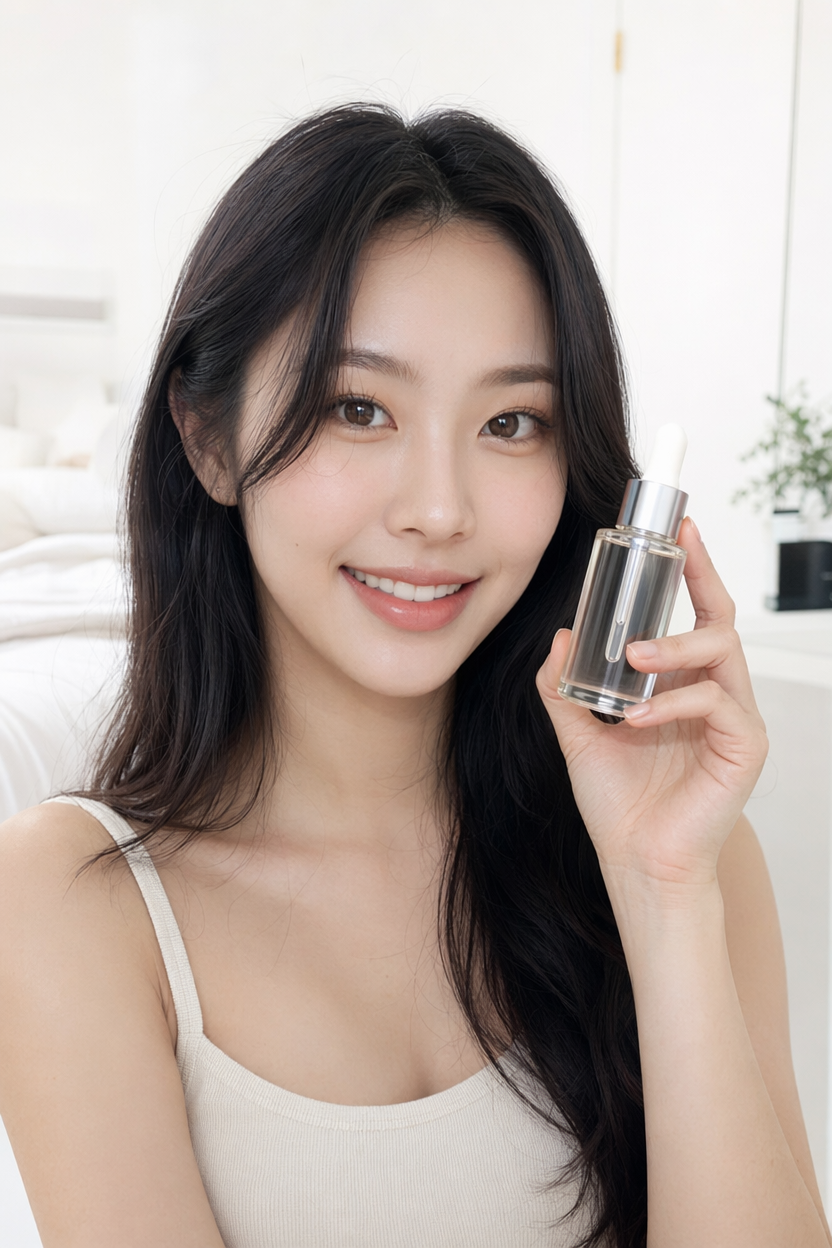
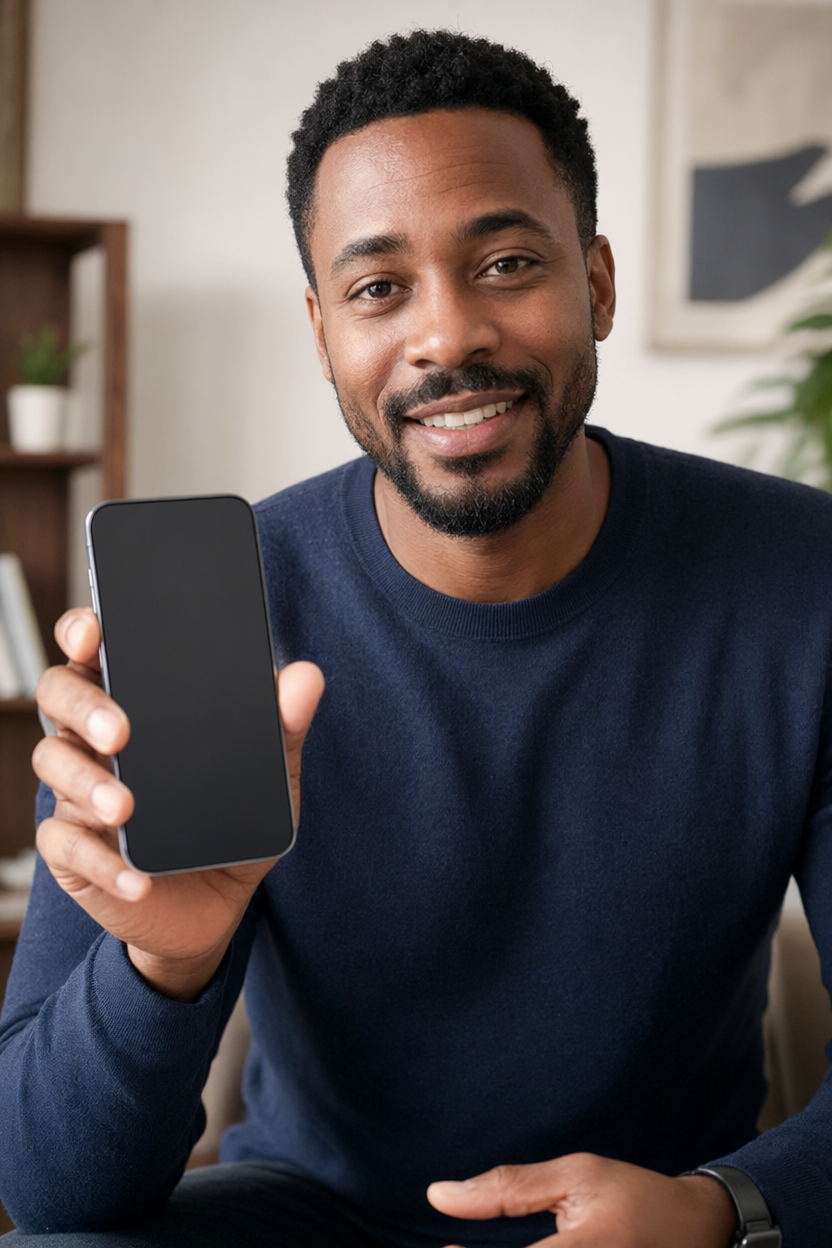
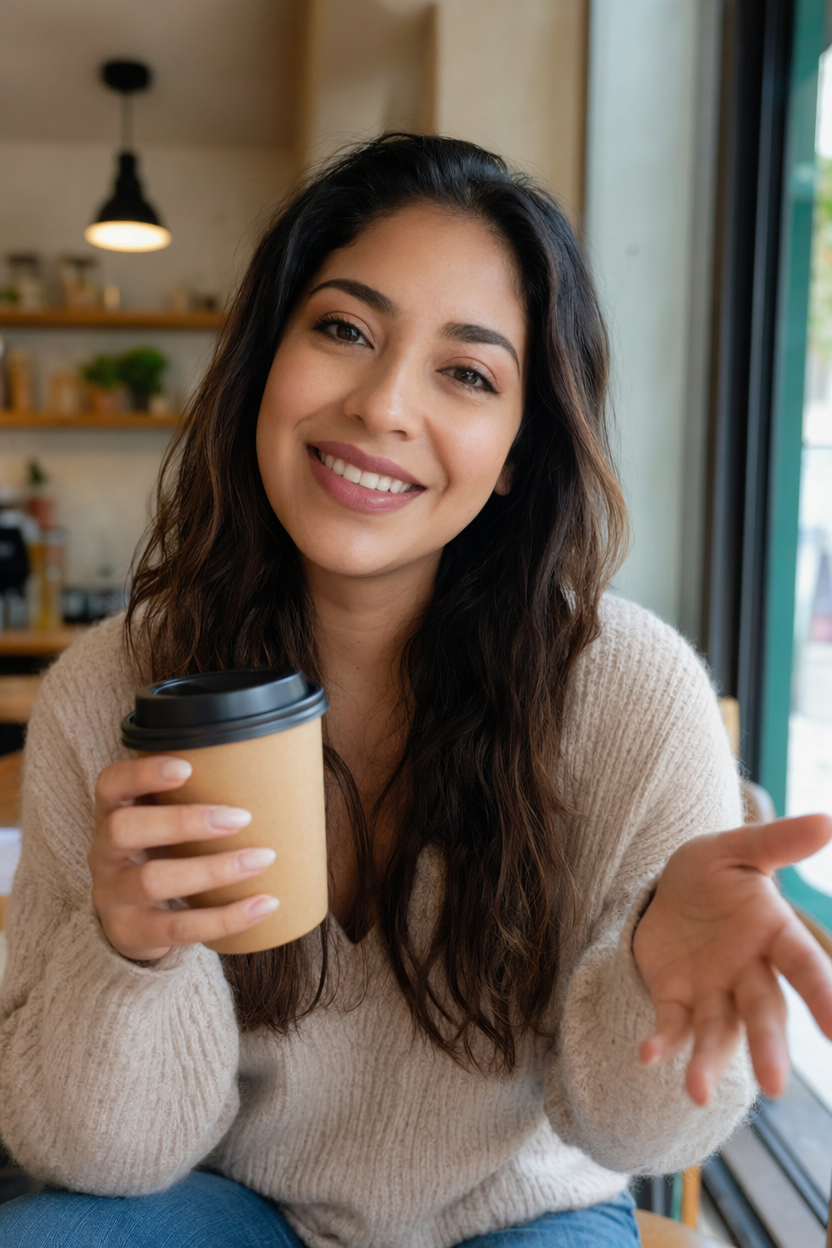
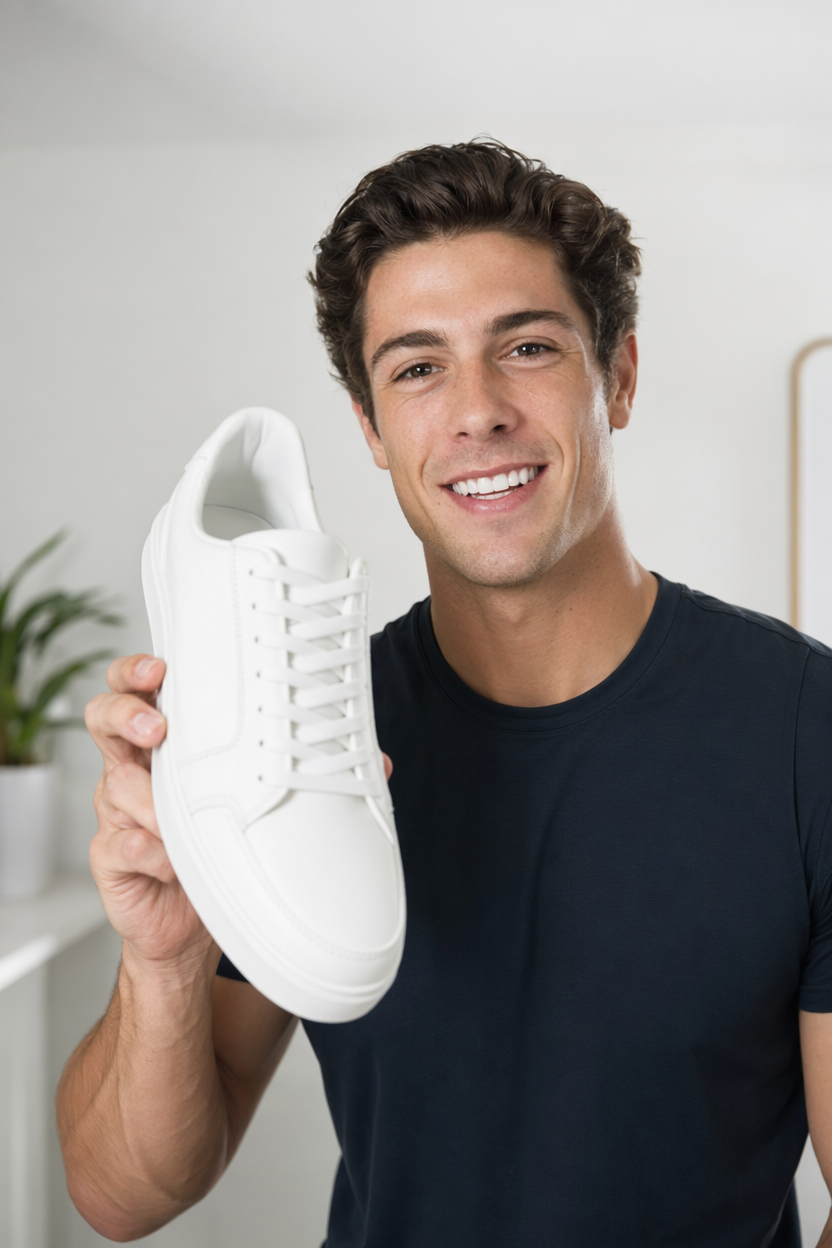
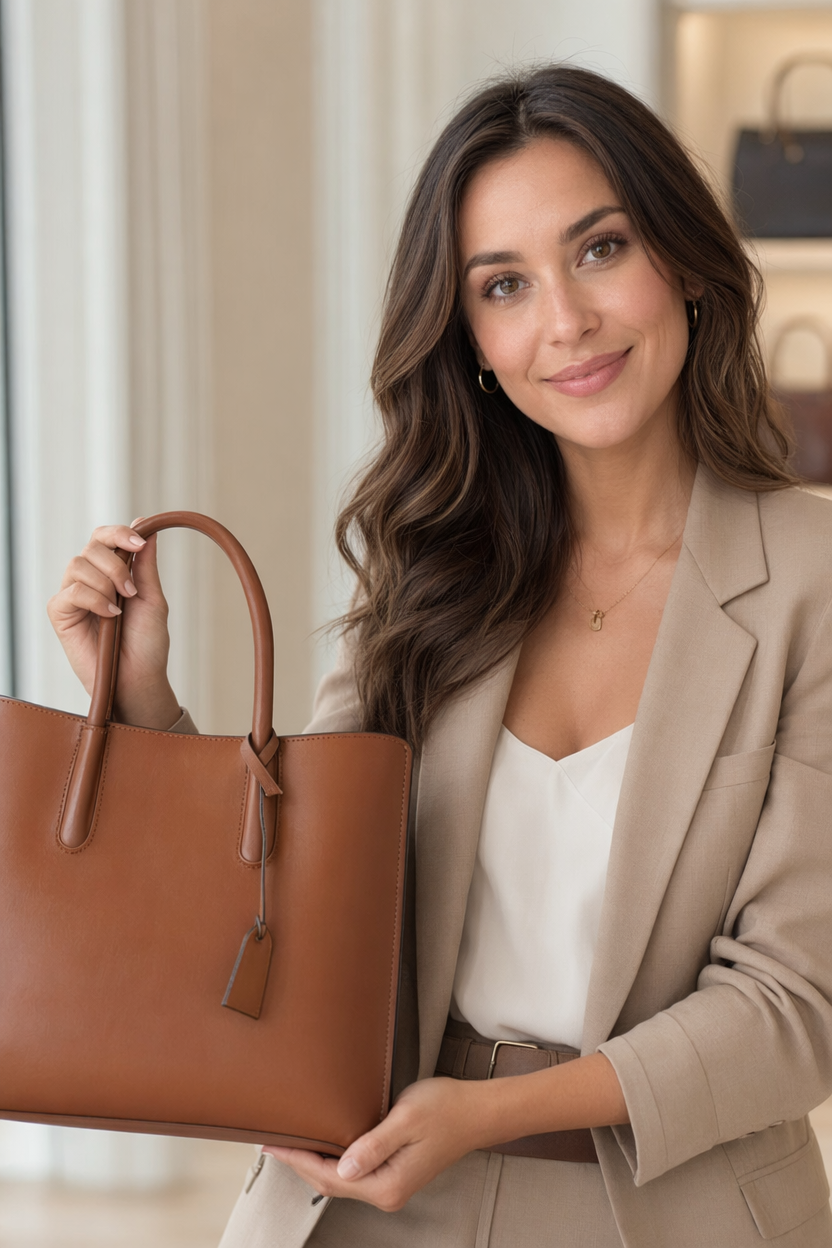
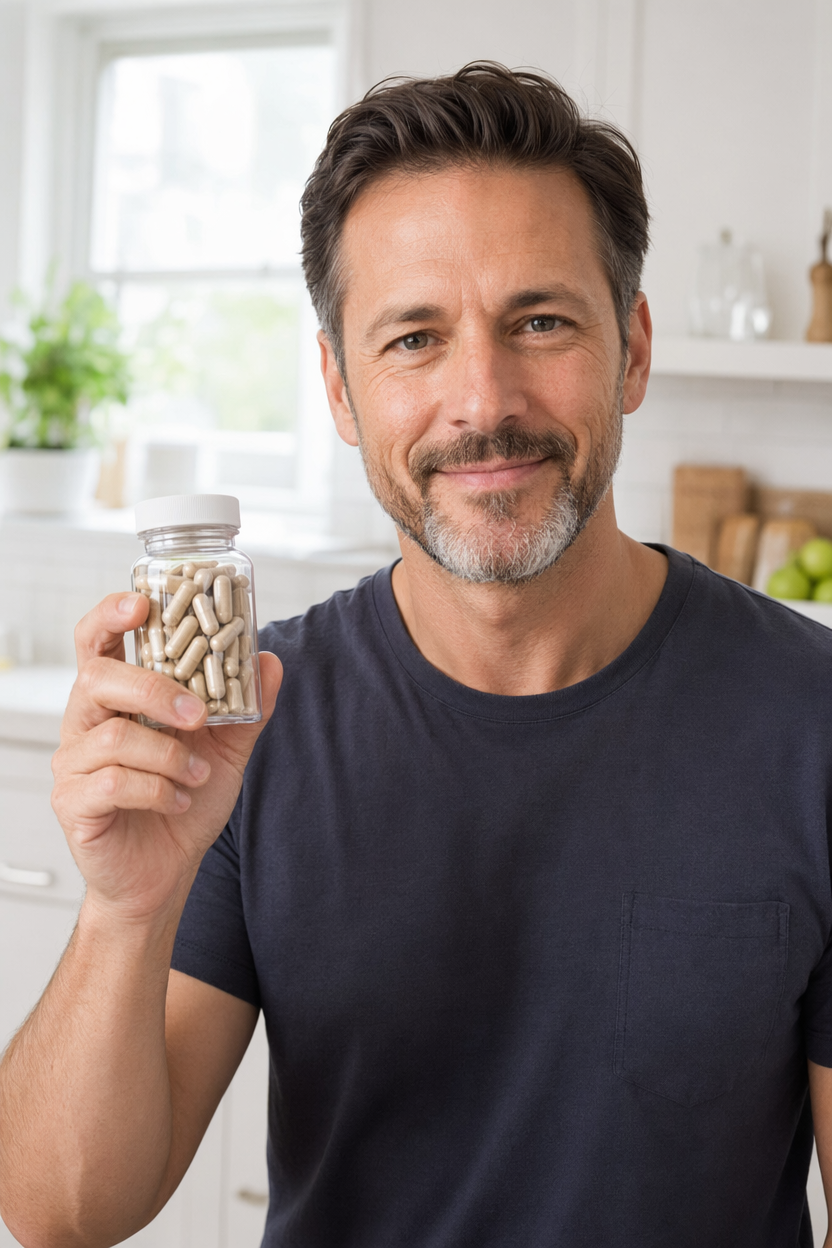
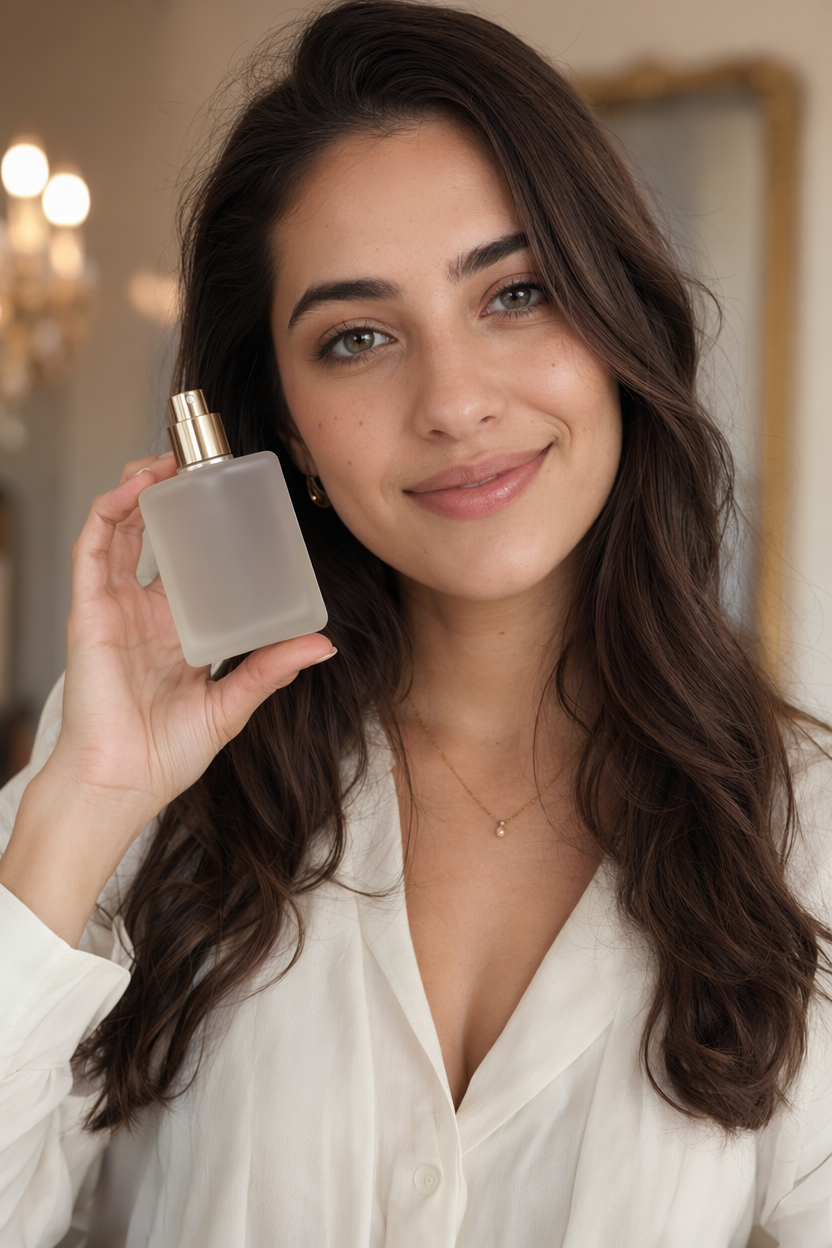
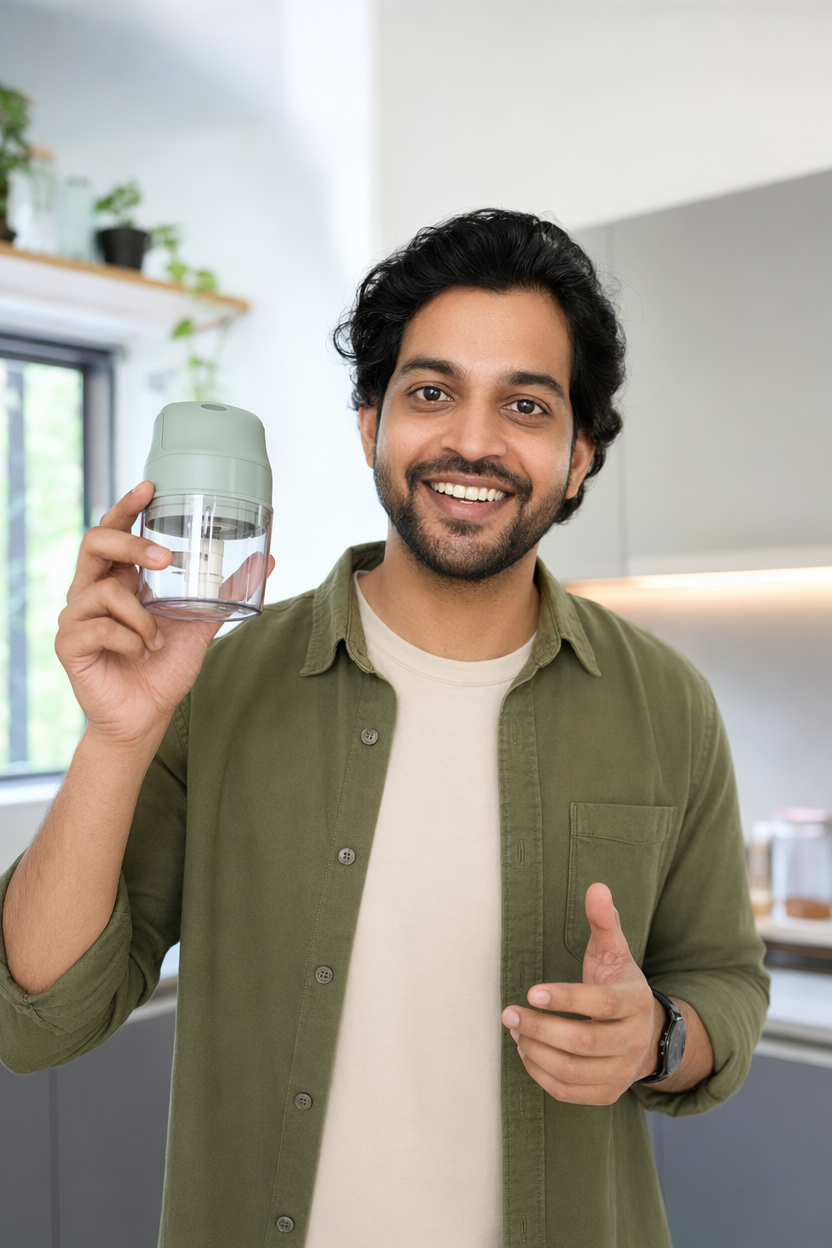
本页的口型同步、表情和肢体动作,由 OmniHuman 1.5 驱动。
| 输入 | 一张人像照片,外加一个上传的音频文件或一段手打的脚本。 |
|---|---|
| 谁的照片 | 你自己的,或者已经授权给你的人的。照片和声音都必须是你有权使用的。 |
| 人像照片建议 | 正面、光线充足、整张脸完整可见且清晰对焦。墨镜和浓重阴影会降低口型同步的准确度。 |
| 音频时长 | 每次生成最长 35 秒——大约 85 个口播词。 |
| 音色库 | 内置 60 个音色,覆盖 10 种语言,生成前可试听。 |
| 模型 | OmniHuman 1.5,负责驱动口型同步、面部表情,以及自然的头部和身体动作。 |
| 费用 | 和其他视频生成一样按输出秒数计费;生成前会先显示。 |
| 输出 | 一段可下载的视频,连同原始人像和脚本一起存进你的历史记录。 |
你的照片,你的话,一条视频。
清晰的正面照效果最好:手机自拍、证件式头像,或者视频里截的一帧都行。会说话照片 AI 只凭这一帧读取你的脸。
自己录一段上传,或者输入台词并从 60 个内置音色里挑一个。音频最长 35 秒。
模型会把口型、表情和自然的头部动作对齐到音频上。留着同一张照片,需要时随时生成新台词,不用补拍。
这里没有图像提示词——干活的是人像和音频。你写的是脚本,而脚本上的取舍决定了成片看起来自不自然。
开头写短一点。第一秒是口型最容易被看清的地方。
嘿——简单跟你说一件事。
句子控制在 15 个词左右以内。长从句会带出不自然的停顿。
这瓶精华只有两种成分。整个配方就这些。
逗号和句号会变成换气。你真正会停顿的地方,就打上标点。
它有效——而且只要十秒钟。
大约每秒 2.5 个词。按你想要的片段时长来写。
35 秒的片段约需 85 个词
我们这款革命性产品运用前沿科技,为追求卓越的挑剔客户交付无与伦比的成果。
这就是大家总在问的那部分。两种成分,没有填充料。大概一周你就能看出差别。
第一条是一个 19 个词的抽象长句——数字人念出来是平板、上气不接下气的单调线,因为根本没有可以换气的地方。第二条是三个短句,带自然的重音点,这才是让念白听起来像真人的原因。
大家好,欢迎来到我们的频道,今天我们要讨论的是关于护肤流程你需要知道的五件最重要的事情。
关于护肤的五件事。第一件,是大多数人都做错的。
又长又不断句的开场,是口型最容易失准的地方,因为模型没有标点可以对齐。一句短钩子能给它干净的重音点,也更抓得住注意力。
会说话的数字人只是其中一种产出。图片和视频生成都在同一个账号里跑。
照片说话视频和其他视频一样按秒计费。新账户注册送 200 积分,可以先试试。
按年计费 · $240/year
AI 会说话的照片,也叫 AI 数字人或虚拟形象,是用一张照片和一段声音生成的人物说话视频。你不用拍摄,只需提供一张肖像和音频(或台词 + 音色),模型就会生成一段逼真的说话表演,可用作数字主播、代言人或旁白。
一张清晰的正面人像照片,加上一段音频(mp3/wav格式),或者——在文本模式下——你想朗读的脚本以及从内置库中选择一个声音。这就足以生成一个会说话的虚拟形象视频。
是的。上传您自己的录音,虚拟形象就会自动进行口型同步。如果您没有录音,请切换到文本模式,然后从文本转语音库中选择一个语音。
每代最多可录制 35 秒音频。如果脚本较长,请将其分割成多个片段。预估时长会在您输入时显示,音频按秒计费。
常见用途包括产品说明和广告、课程和新用户引导旁白、社交媒体访谈片段、公告以及信息的多种语言版本——任何需要拍摄主持人的场合。
CreateVision AI 使用了字节跳动的 OmniHuman 1.5,它能够根据音频驱动唇形同步、头部动作和手势。有关技术细节,请参阅 OmniHuman 1.5 模型页面。
光线充足、面向镜头、整张脸完整清晰的肖像。墨镜、脸上的浓重阴影、极端角度,或人脸在画面中占比过小,都会降低口型同步的准确度。
不用。你可以直接打字写台词,再从内置音色库里挑一个声音,库里有覆盖 10 种语言的 60 个音色。如果你更想用自己的录音,也支持上传。
可以,这也是最常见的用法。上传一张你自己的照片,然后要么录自己的声音,要么输入台词并选一个音色库里的声音。结果就是你本人在说你的话,不需要架相机。很多创作者留着一张好照片,每周都用它生成新的短片。
可以。根据 CreateVision AI 服务条款,你生成的内容可用于个人和商业用途,在合适的场合注明由 CreateVision AI 生成即可。你需要自行确保对上传的照片和声音拥有使用权,并遵守发布平台关于 AI 内容标注的规则。
目标一样,原理不同。这里你的照片就是身份,音频或台词驱动说话,所以产出是一条口型同步的出镜短片,而不是把你放进某个场景。它只需要任意一张照片,不用录视频登记,也不依赖别的应用是否还在。