点击上传拖入图片或点击
JPG · PNG · WebP
一个人、正面朝向镜头、嘴巴可见。也可以跳过,直接在下方选一个预设表演者。
预览
AI 说唱视频生成器 是什么?
AI 说唱视频生成器 可将照片变成短 AI 视频,内置场景模板,注重隐私处理,并适合直接分享。
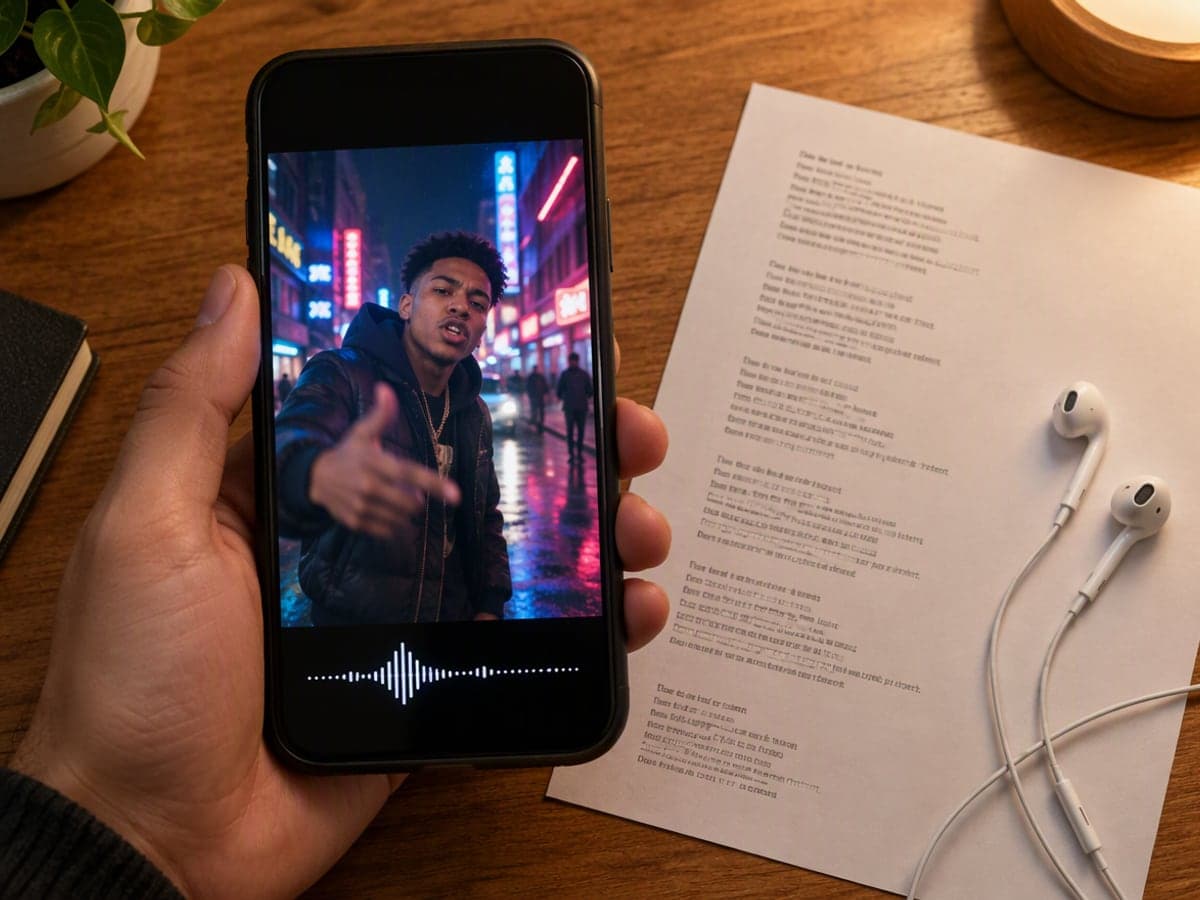
一段音轨 + 一张照片,生成说唱视频
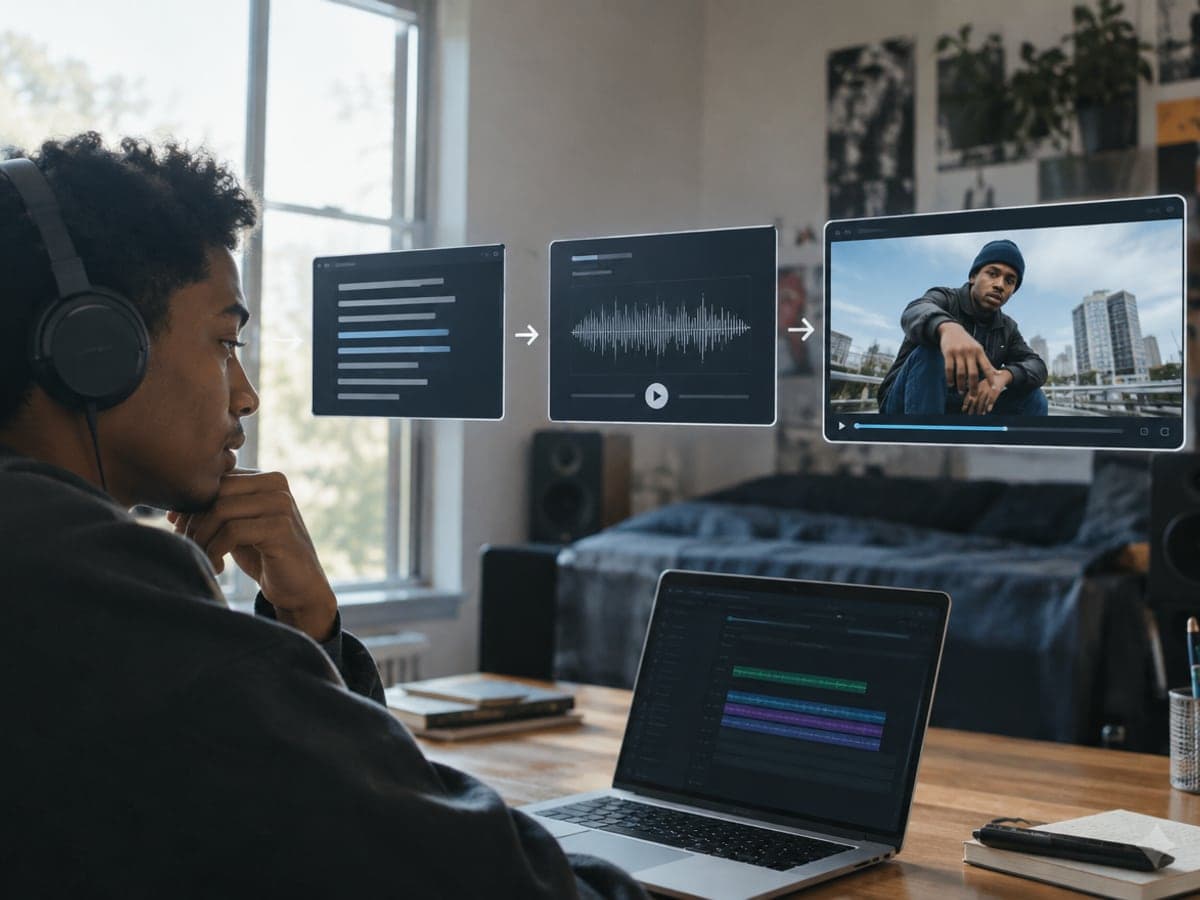
从你在 AI 说唱生成器里做的歌或上传的文件中选 15 秒人声,再选一位预设表演者或上传你自己的照片。表演者会在你选的场景里对着镜头把这段说唱表演出来。
为什么音乐人都用我们的 AI 说唱视频生成器
面向普通用户设计,不需要剪辑经验。
嘴型跟着你的词走
表演者唱的是你给的人声:嘴型对上音节,点头卡在节拍上,而不是随便剪进波形的通用画面。
你自己或虚拟角色来唱
上传一张照片,视频会保留你的脸、发型和衣服。不想出镜,就从八个预设表演者里选一个。
保留你的原声人声
你的 15 秒人声片段会混回成片,歌听起来就是你录的样子。所有套餐下载都不带水印。
AI 说唱视频生成器能帮你做什么
适合真实生活场景,生成后即可分享。
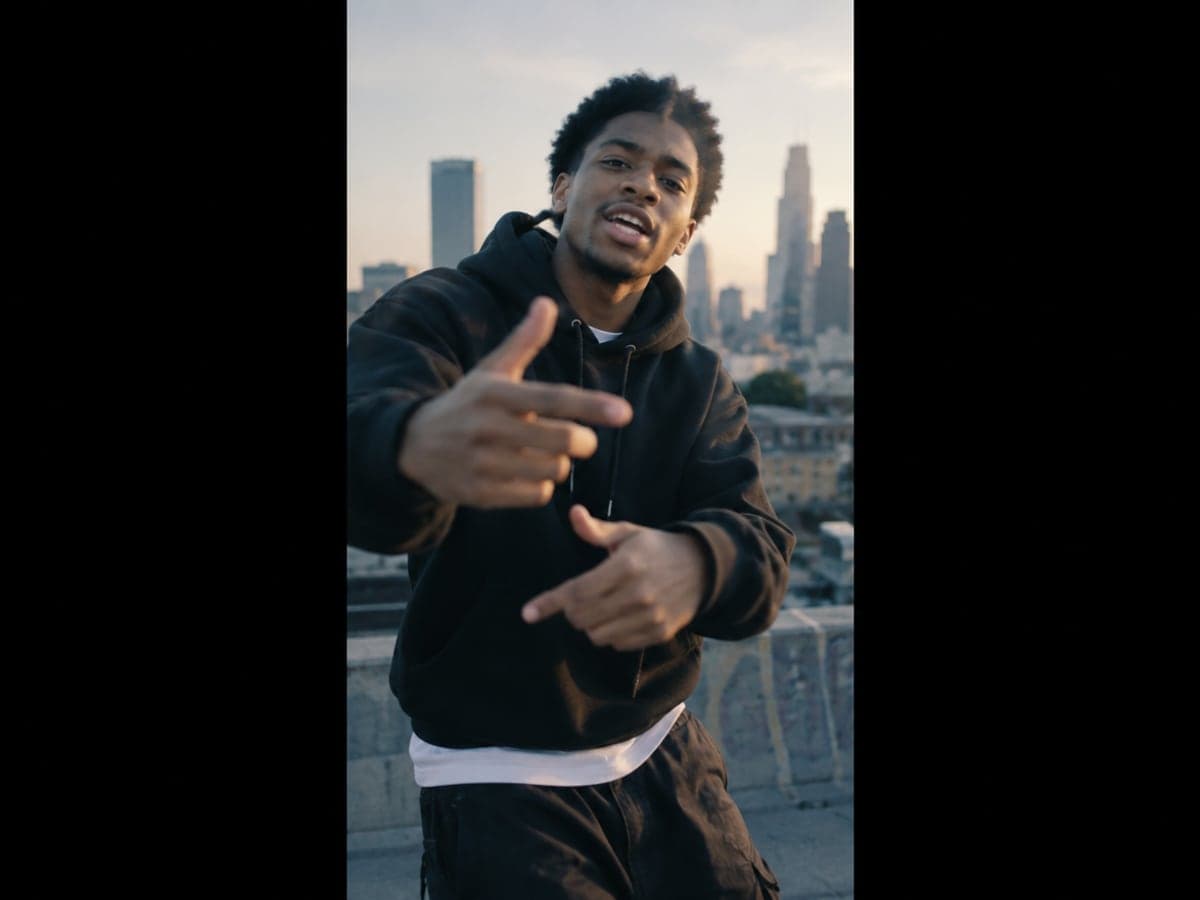
发一条为短视频而生的说唱片段
15 秒、9:16 竖屏、自带声音。这正是 TikTok、Reels 或 Shorts 的尺寸,你可以直接把歌的副歌发出去。 做一首说唱歌
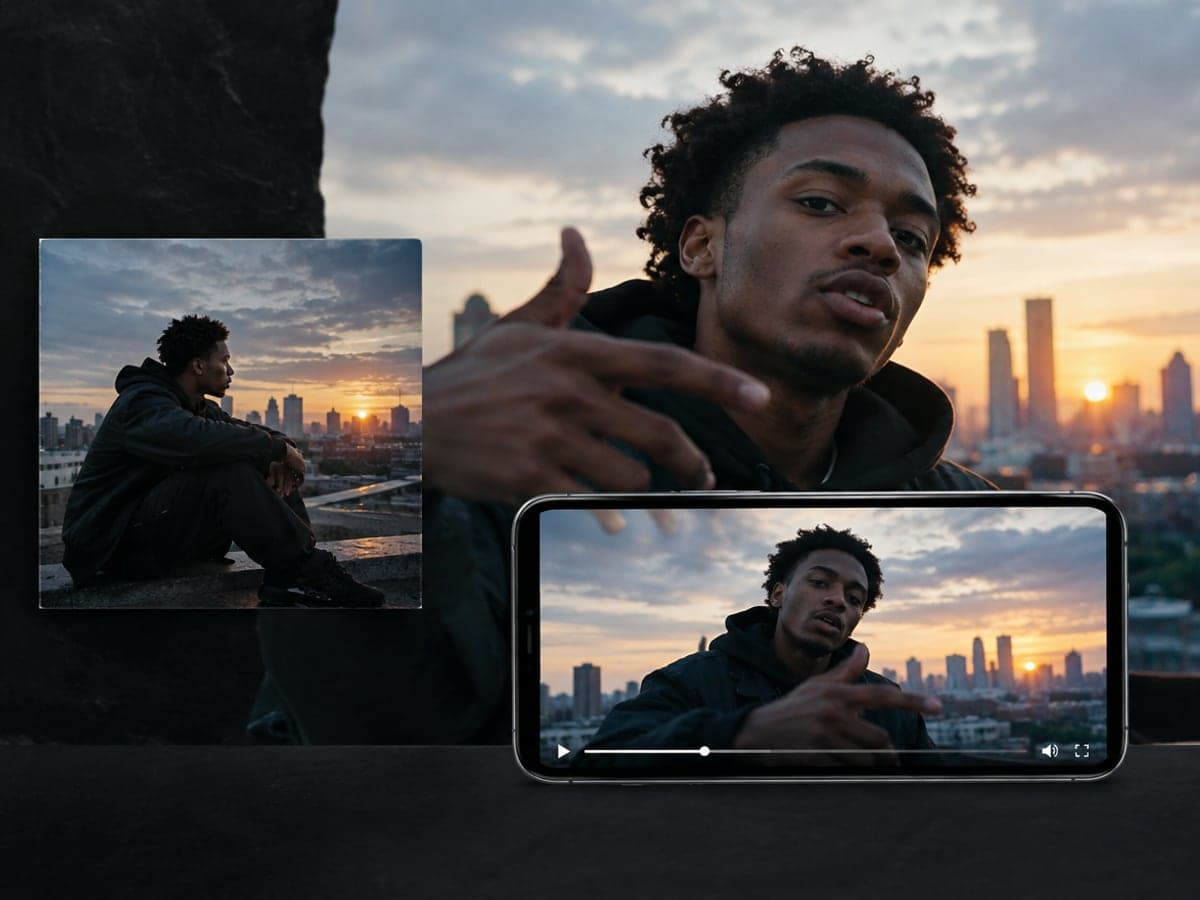
给你的单曲配上表演画面
不用拍摄,用你的照片、你的人声和一个契合歌曲的场景就行。再配上相应的封面,你的作品在哪里看都很完整。 设计你的专辑封面
做一条群聊反复重播的片段
来一首怼室友的 diss、一段生日说唱,或者让猫咪吉祥物开口飙词。15 秒就足够让整个群笑翻,再求你来一条。 让你的宠物开口说话
谁在用 AI 说唱视频生成器
大家每周都在用的四种玩法
不约拍摄也能发表演视频
把每段副歌都变成竖屏短视频
听到自己的词,也看到它被唱出来
做一段全群重播的生日说唱
如何用 CreateVision 制作说唱视频
上传照片,选择场景,下载可分享的视频。
添加 15 秒人声
从 AI 说唱生成器里选一首你最近的歌,或上传 MP3/WAV。拖动 15 秒窗口,对准你想表演的主歌或副歌。
选择表演者和场景
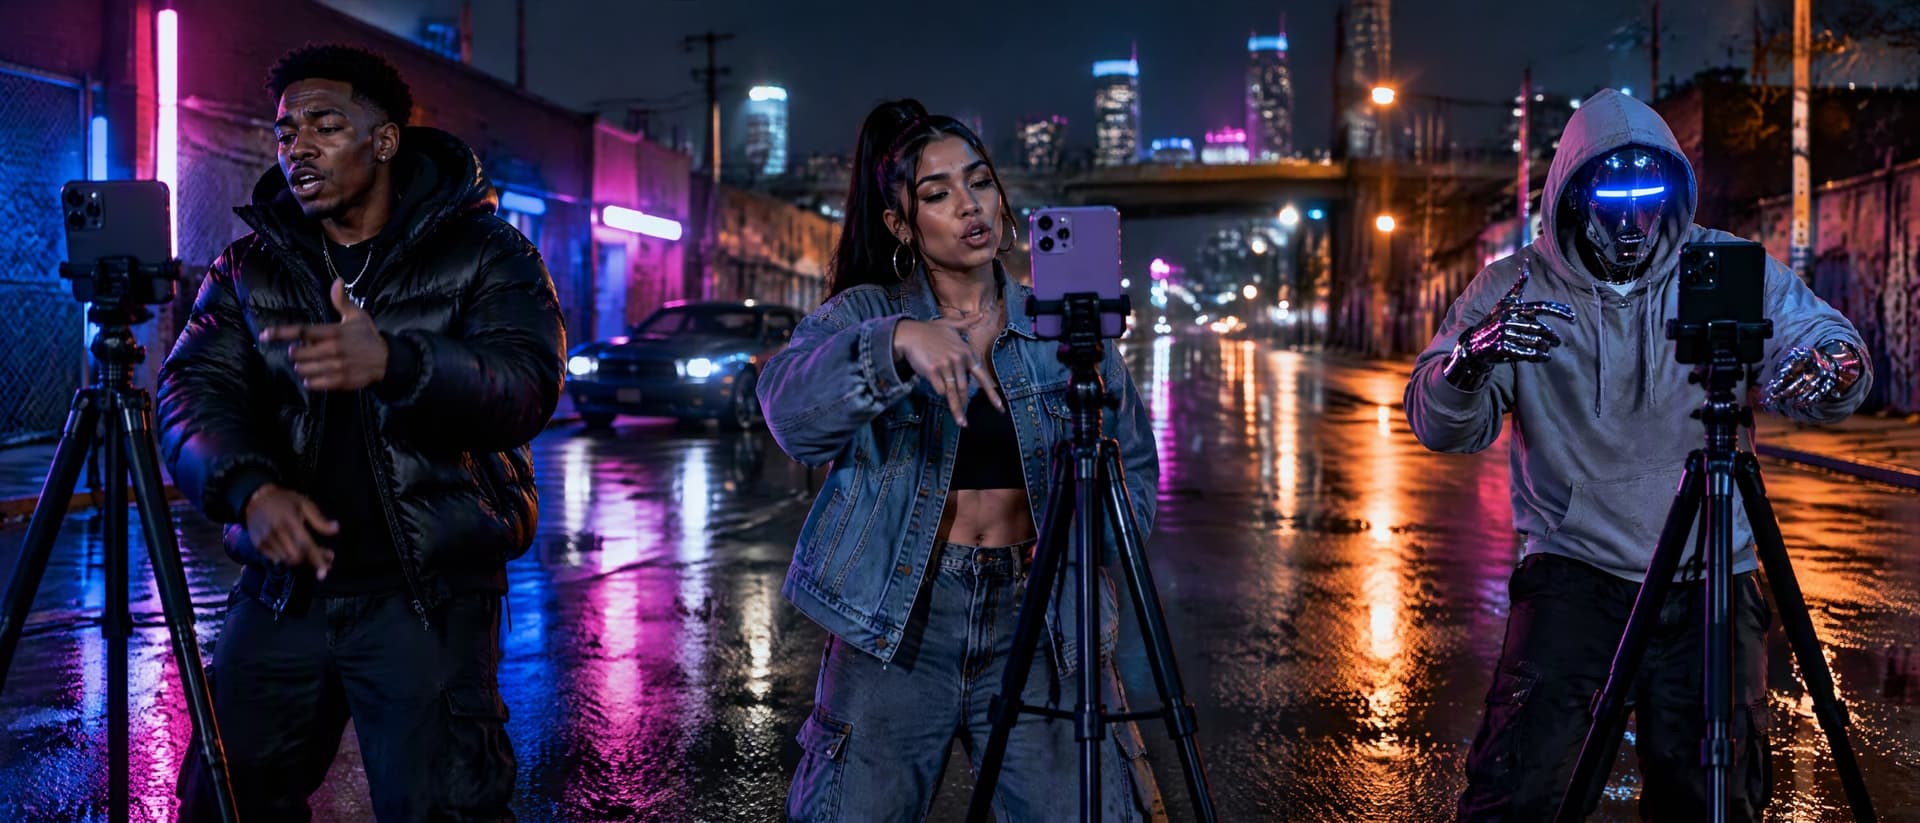
上传一张要说唱的那个人的清晰照片,或从八个预设角色里选一个。然后选场景:夜晚街头、录音棚、天台、动漫、Lo-Fi 卧室或豪车。
生成并下载
选一个引擎,点「生成」,就能得到一段演唱你人声的 15 秒竖屏 MP4,通常需要两到四分钟。下载它,或换个场景再来一条。
一站式 AI 创作平台
一个账号搞定图片、视频、替你干活的 AI 智能体、专家级 AI 导师,还有 80+ 现成工具。
190K+ 位创作者
正在用 CreateVision 创作和分享
AI 说唱视频生成器常见问题
它能把一小段说唱人声变成表演视频。你给它 15 秒人声、一个表演者和一个场景,视频模型就会让表演者踩着节拍说唱。在 CreateVision 上,你的原声人声片段会混回 9:16 成片里。
CreateVision 的 AI 说唱视频生成器围绕你自己的歌打造。表演者的嘴型跟着你的人声走,你的原始音频会混回片段里,你可以用自己的脸,也可以用八个预设角色之一。你还能在同一个网站写词、做歌,从起步 135 积分的三种引擎里选择,所有套餐下载都不带水印。
你给它三样东西:15 秒人声、一个表演者(你上传的照片或预设角色)和一个场景。视频模型会让表演者在你选的场景里唱出这段人声,嘴、头和手都卡在节拍上。然后把你的原声人声片段混回去,你会得到一段 15 秒的竖屏 MP4。
用你在 AI 说唱生成器里做的歌,它会出现在「我最近的歌曲」里,或者上传 MP3/WAV。只会用到你选中的那 15 秒。想用自己的脸,就上传一张面对镜头、嘴部可见的清晰照片。只使用你自己或已同意出镜的人的照片。
一段 15 秒 480p 的片段:用 Grok(默认,每秒 9 积分)135 积分,用 Seedance 2.0 Mini 225 积分,用 Seedance 2.0 Fast 525 积分。Seedance 2.5 的价格显示在「生成」按钮上。用 Google 注册即送 200 免费积分,可以直接上手。视频生成失败会退回积分。
视频归你下载和发布,所有套餐都不带水印。如果人声来自 AI 说唱生成器,这些 AI 生成歌曲的商业发行条款还在最终确定中,目前请只用于个人和社交媒体。你的照片、音频和视频仅你的账户可见,不会用于训练,随时可以从历史记录中删除。
嘴部动作是视频模型根据你的人声生成的,所以它会紧跟节奏和大部分音节,但不能保证每个字都逐帧对上。又快又密的 flow 比清晰的副歌更难。某条不对时,用同样的素材再生成一次、换个场景,或切到 Seedance 2.0 Fast 获得最贴合的口型。
把你的歌变成说唱视频
添加 15 秒人声,选一个表演者和场景,得到一段保留你原声的竖屏片段。