Sprechendes KI-Foto

Laden Sie ein Porträt und eine Audiospur hoch (bis zu 35s), oder geben Sie ein Skript ein und wählen Sie eine Stimme, und OmniHuman 1.5 verwandelt das Foto in ein sprechendes Video mit synchronisierten Lippen und natürlicher Bewegung. Verwenden Sie Ihr eigenes Foto, um selbst die Hauptrolle zu spielen.

0 / 2,000
130 cr/s · ≤35s

Von einem Foto zum sprechenden Video

Ein einzelnes Porträt plus Skript wird zum lebensechten Sprecher – synchrone Lippen, Mimik und Gesten. Keine Kamera, kein Studio.

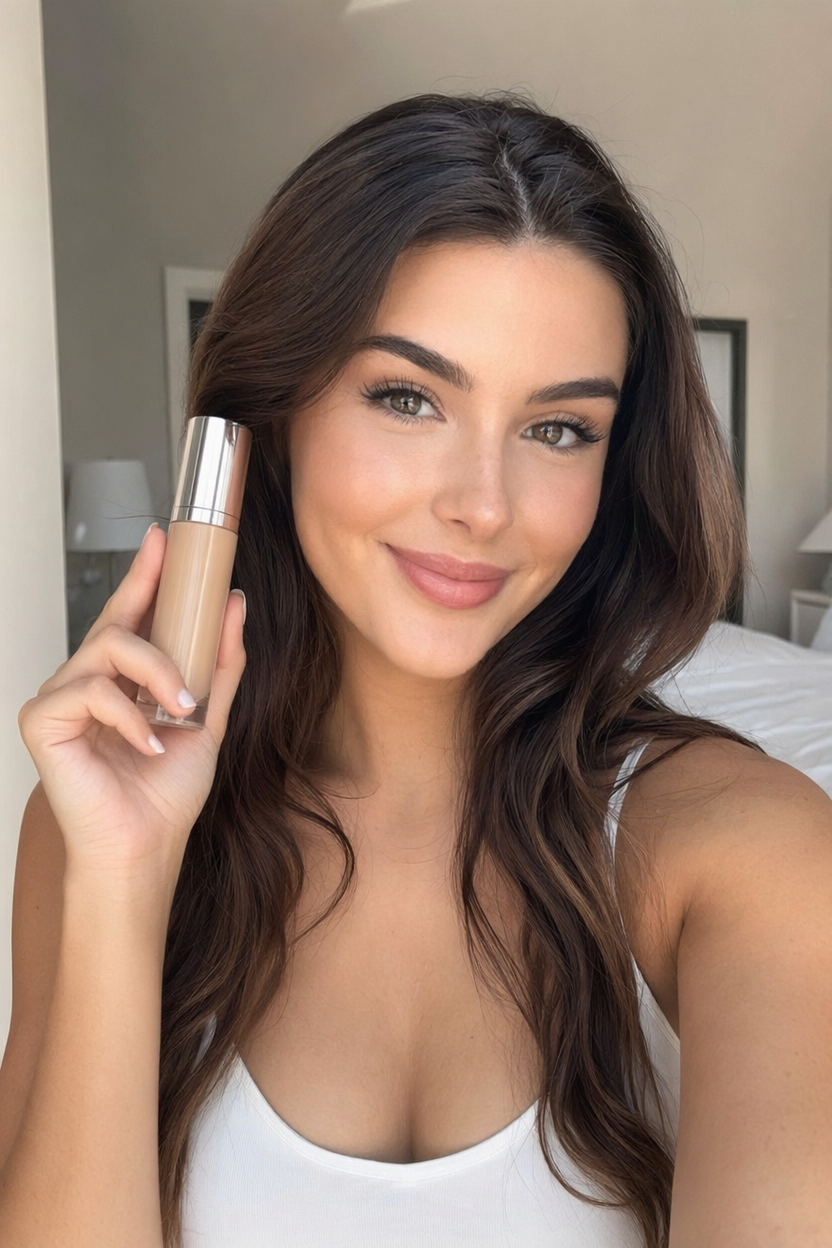
OriginalbildOriginal portrait photo of a beauty creator holding a skincare product
Skript

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

KI-Avatar-Video

Lassen Sie jedes Foto sprechen, auch Ihr eigenes

Ein vollständiger Generator für KI-Talking-Fotos (digitale Menschen): Laden Sie ein Porträt und einen Audioclip hoch oder tippen Sie ein Skript und wählen Sie eine Stimme, und erhalten Sie ein lebensechtes sprechendes Video mit synchronisierten Lippen, natürlichen Ausdrücken und Gesten. Verwenden Sie ein Foto von sich selbst, um der Präsentator zu sein. Angetrieben von ByteDance OmniHuman 1.5, keine Kamera, kein Schauspieler und kein Studio erforderlich.

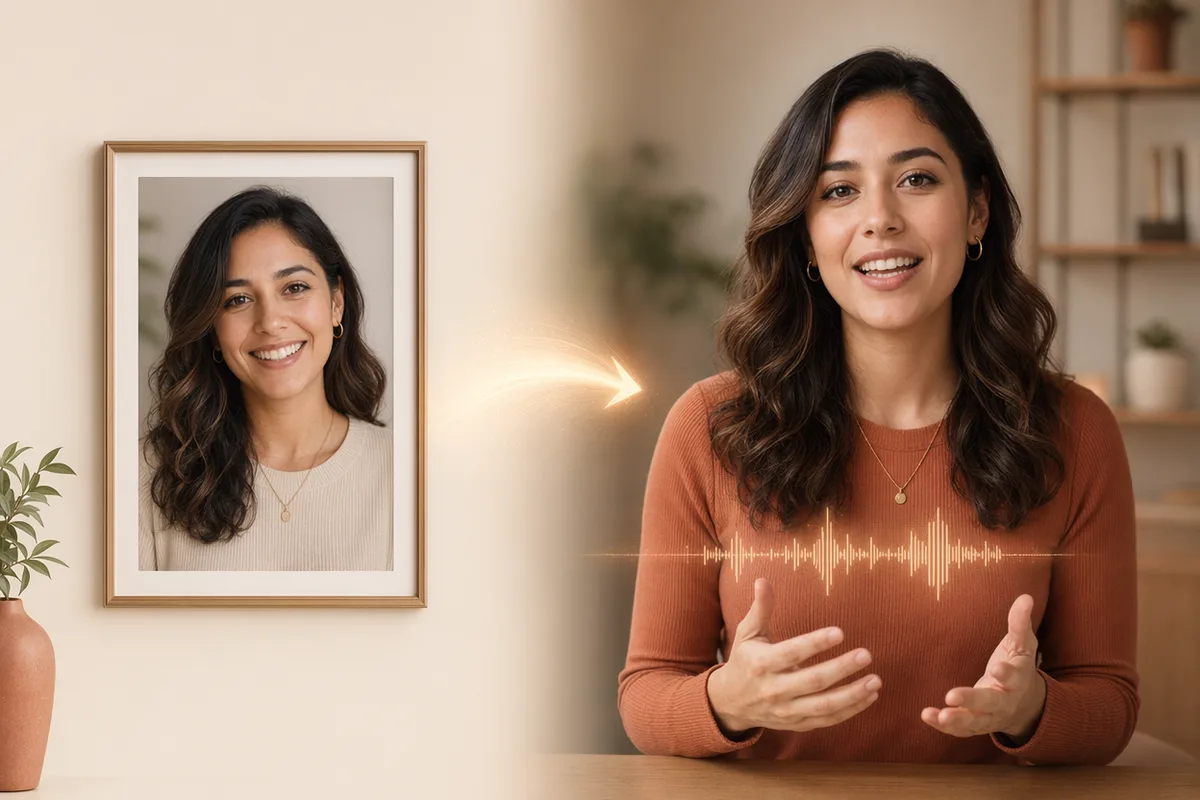
Ein gerahmtes Porträtfoto, das sich in einen sprechenden KI-Avatar derselben Frau verwandelt, mit einer Audiowellenform dazwischen

Spielen Sie selbst die Hauptrolle oder erstellen Sie einen digitalen Sprecher

Kein Filmen, kein Schauspieler, kein Greenscreen. Laden Sie ein klares Foto von sich hoch, und Sie werden zum Präsentator, der Ihr Skript vorliest, mit Ihrer eigenen Stimme oder einer Bibliotheksstimme. Oder verwenden Sie ein Foto einer Person, die Ihnen die Erlaubnis gegeben hat, und erstellen Sie einen wiederverwendbaren digitalen Moderator für Produkterklärungen, Kurseinführungen, Ankündigungen und Werbung. Generieren Sie jederzeit neue Zeilen, ohne neu zu drehen.
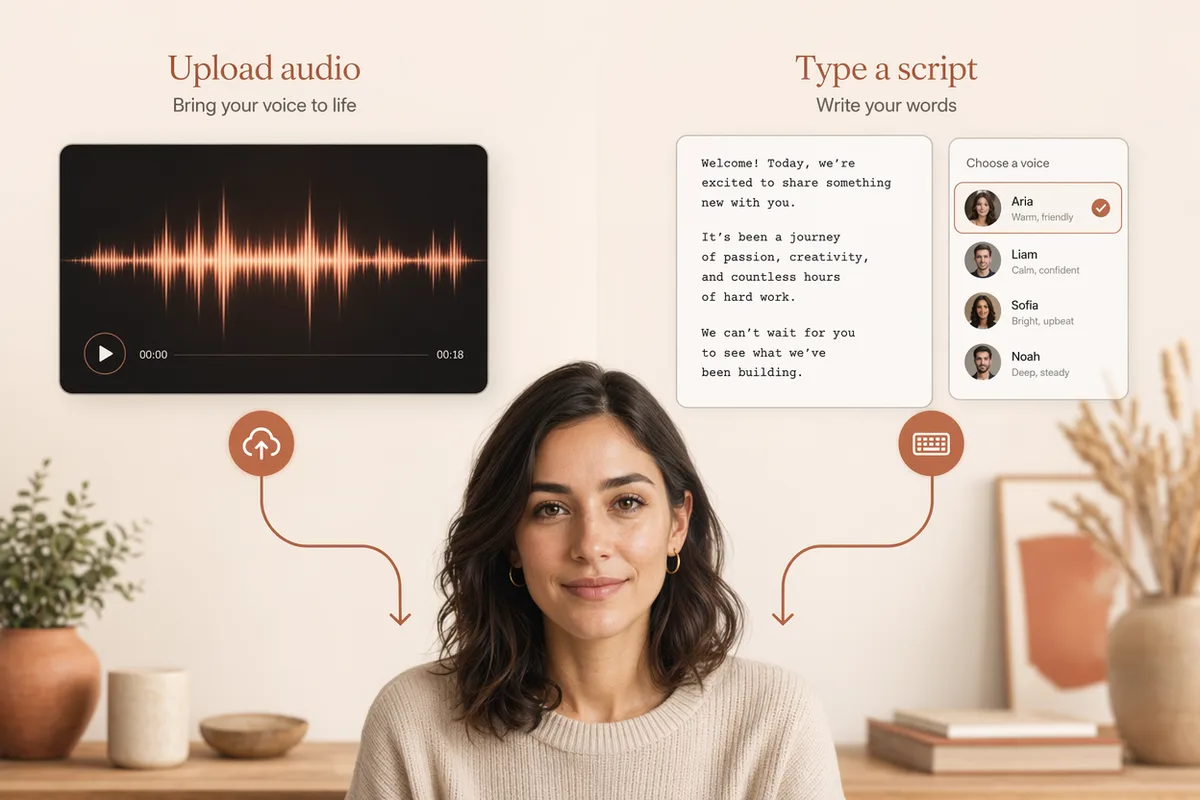
Zwei Eingaben für ein KI-Talking-Foto: eine hochgeladene Audiowellenform und ein getipptes Skript mit Stimmauswahl

Es gibt zwei Möglichkeiten: Audio hochladen oder ein Skript eingeben.

Sie haben bereits eine Sprachaufnahme? Laden Sie sie hoch, und Ihr Avatar synchronisiert die Lippen dazu. Kein Ton? Wechseln Sie in den Textmodus: Geben Sie ein, was Ihr Avatar sagen soll, wählen Sie eine Stimme aus der integrierten Sprachausgabebibliothek, und der Text wird automatisch in die Fahrsequenz umgewandelt. Die geschätzte Länge und die Kosten werden Ihnen vor der Generierung angezeigt.

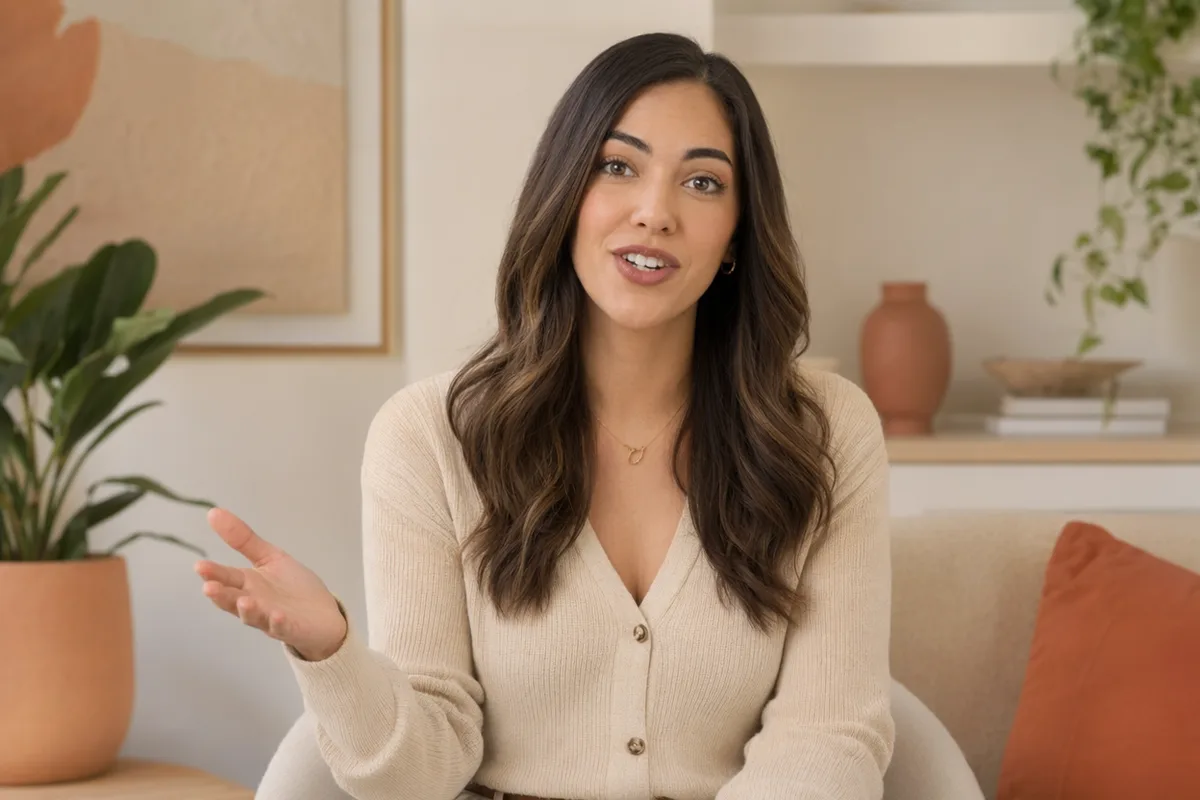
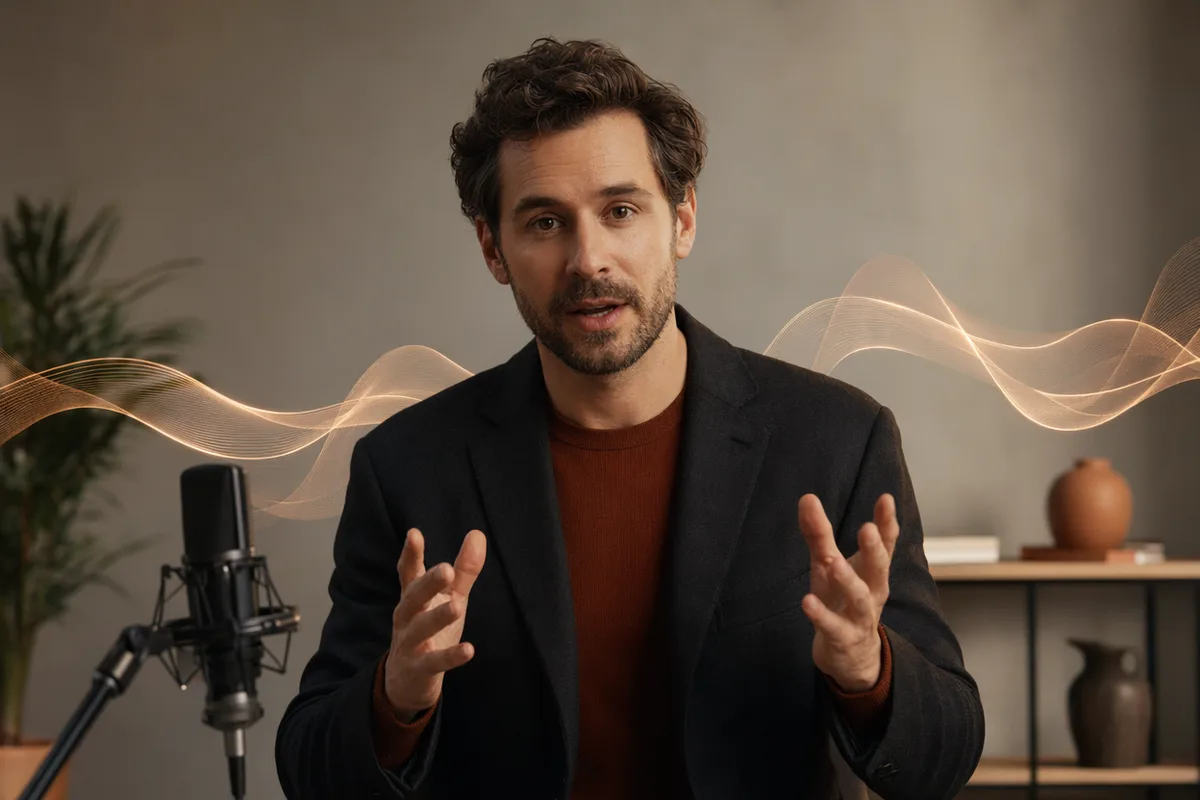
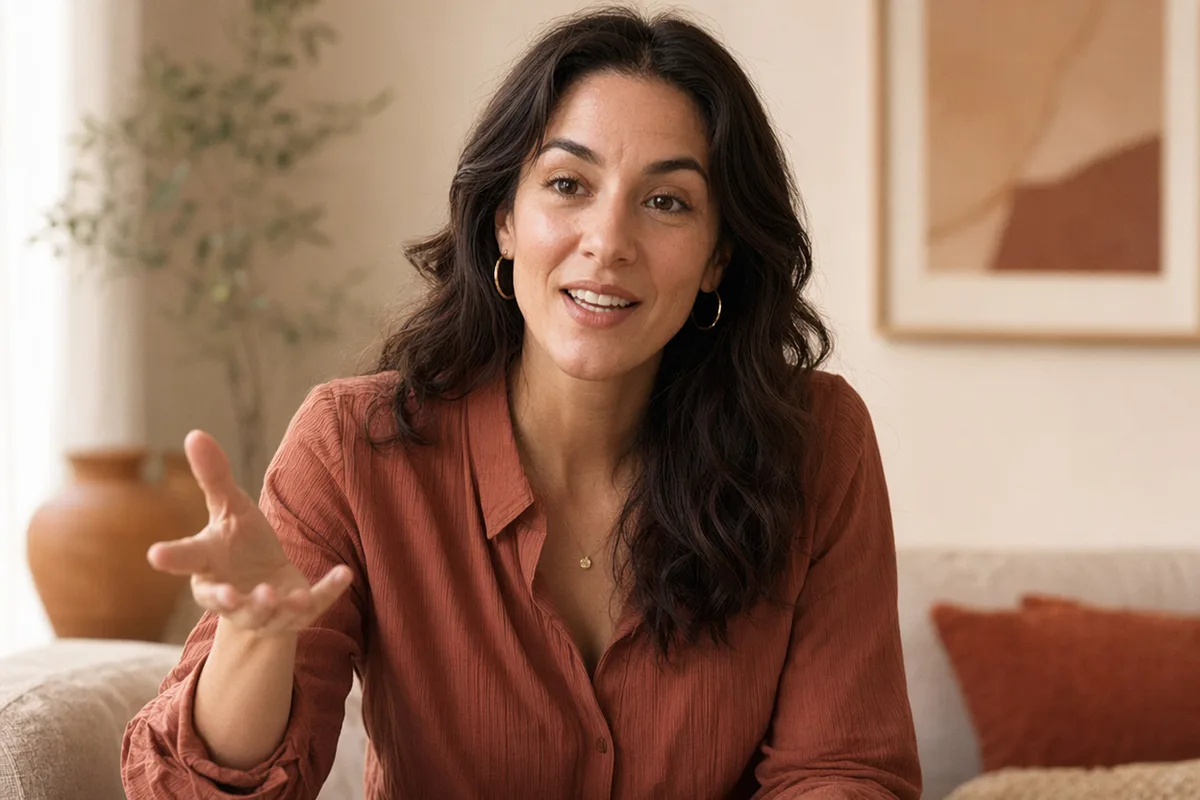
KI-Talking-Foto-Standbild einer Frau, die mit natürlichen Handgesten in die Kamera spricht

Lebensecht – nicht nur ein sich bewegender Mund

OmniHuman 1.5 analysiert Rhythmus, Prosodie und Bedeutung des Audiomaterials, um Kopfbewegungen, Körperhaltung und Handgesten präzise zu steuern und gleichzeitig die Lippenbewegungen exakt zu synchronisieren. Dabei bleiben die Identität und die Beleuchtung der Person erhalten. Das Ergebnis wirkt wie ein echter Moderator und nicht wie ein statisches Porträt mit animiertem Mund.

KI-Talking-Foto-Präsentator in einem Wohnzimmer, der einen kurzen Social-Clip vorträgt

Entwickelt für Marketing, Schulung und soziale Medien

Erstellen Sie im Handumdrehen Sprecherclips für Anzeigen und Landingpages, vertonte Schulungslektionen und Onboarding-Videos, Social-Media-Posts mit sprechenden Köpfen oder mehrsprachige Versionen derselben Nachricht. Jede Version wird mit ihren Eingaben gespeichert, sodass Sie schnell iterieren und Variationen erstellen können.

Porträts, bereit für KI-Talking-Foto

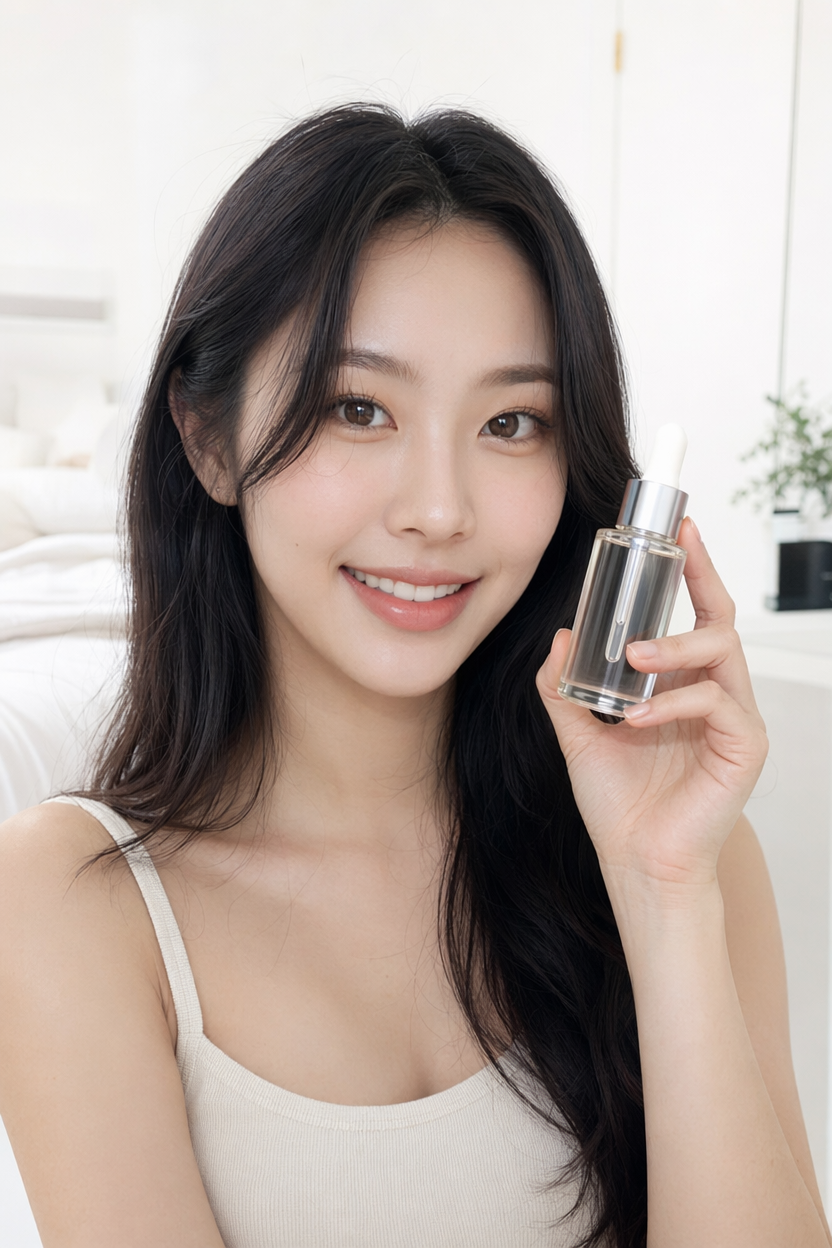
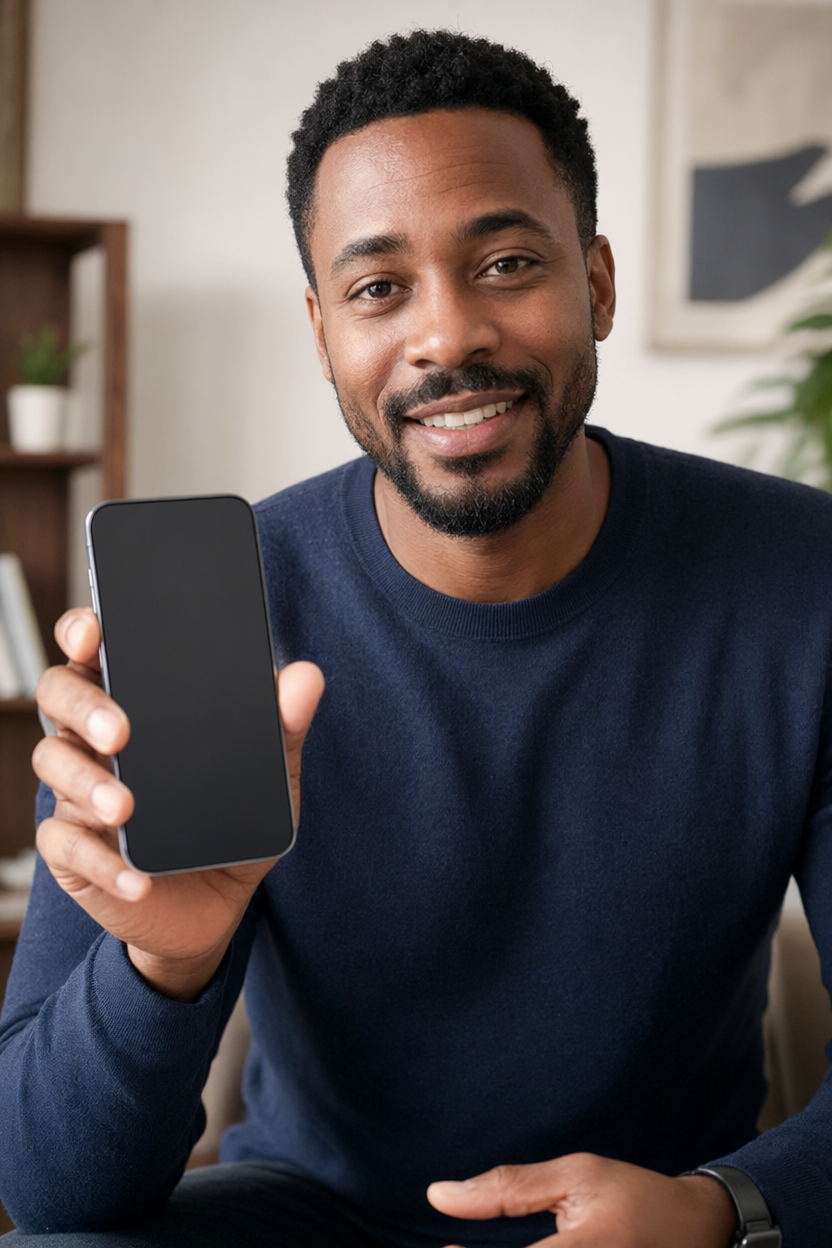
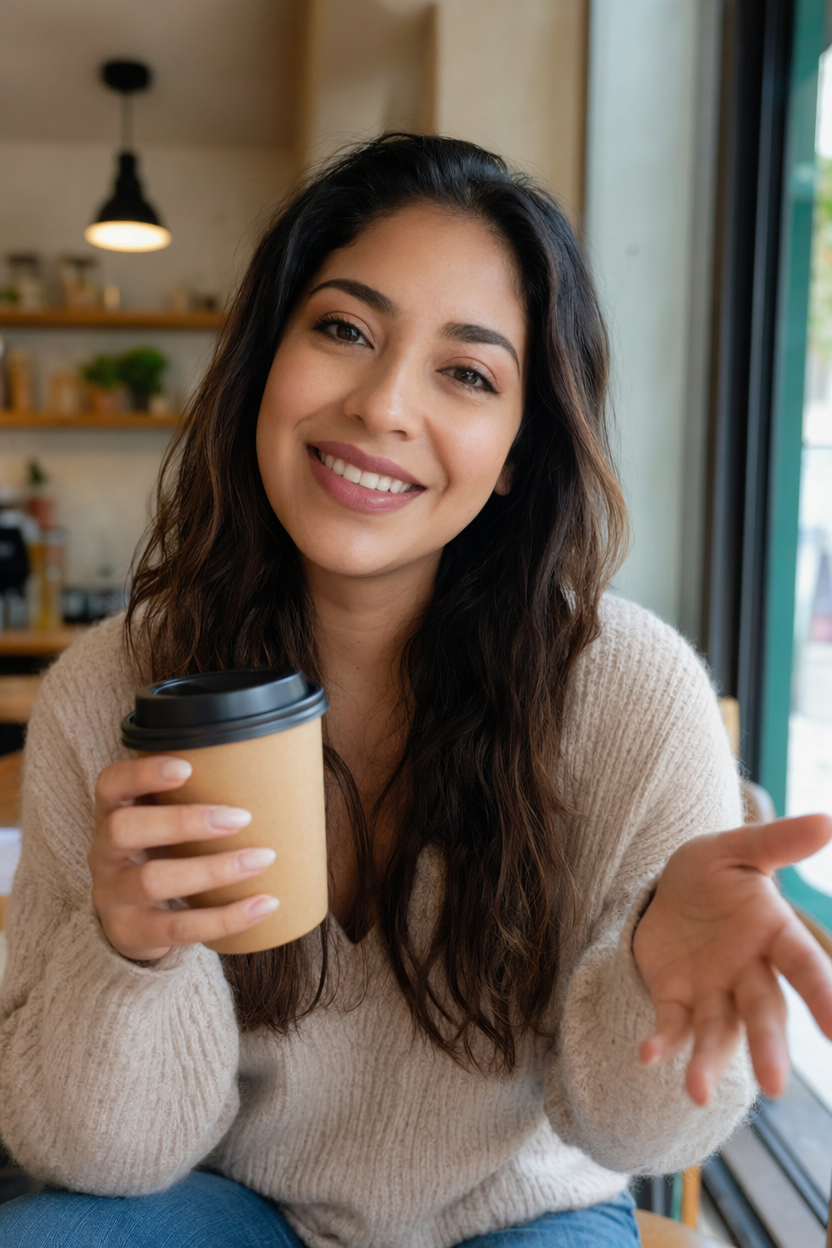
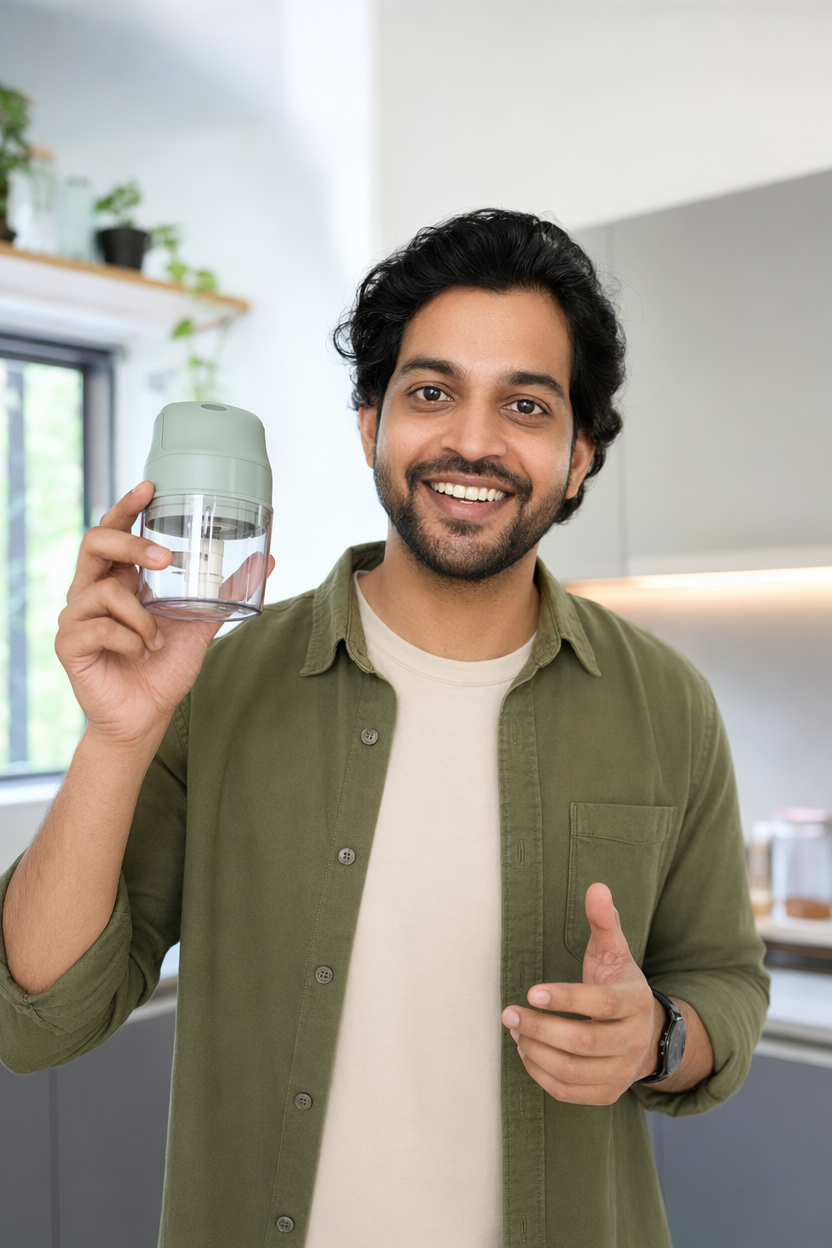
Porträts im Moderatorenstil, erzeugt auf CreateVision AI – jedes davon kann ein sprechendes Avatar-Video antreiben, sobald du Audio hinzufügst.

KI-Avatar einer Beauty-Influencerin präsentiert ein Hautpflege-Serum
KI-Avatar eines Technik-Rezensenten, der ein Smartphone vorstellt
KI-Avatar eines Lifestyle-Creators mit einer Kaffeetasse
KI-Avatar eines Sneaker-Rezensenten, der einen Schuh präsentiert
KI-Avatar einer Modedesignerin mit Handtasche
KI-Avatar eines Wellness-Influencers, der Nahrungsergänzungsmittel präsentiert
KI-Avatar einer Kosmetikdesignerin mit einem Parfümflakon
KI-Avatar eines Hobbykochs mit einem Küchengerät

Das Modell hinter diesem KI-Talking-Foto-Generator

OmniHuman 1.5 steuert Lippensynchronität, Mimik und Körperbewegung auf dieser Seite.

KI-Talking-Foto-Spezifikationen

EingabeEin Porträtfoto plus entweder eine hochgeladene Audiodatei oder ein eingetipptes Skript.
Wessen FotoIhr eigenes oder das einer Person, die Ihnen die Erlaubnis gegeben hat. Sowohl das Foto als auch die Stimme müssen Ihnen zur Verwendung zur Verfügung stehen.
Hinweise zum PorträtFrontal, gut ausgeleuchtet, ganzes Gesicht sichtbar und scharf. Sonnenbrillen und harte Schatten verringern die Genauigkeit der Lippensynchronisation.
AudiolängeBis zu 35 Sekunden pro Generierung – rund 85 gesprochene Wörter.
Stimmenbibliothek60 integrierte Stimmen in 10 Sprachen, mit Hörproben vor der Generierung.
ModellOmniHuman 1.5 – steuert Lippensynchronisation, Mimik sowie natürliche Kopf- und Körperbewegung.
KostenAbrechnung pro Sekunde Output wie bei jeder anderen Videogenerierung; wird vor der Generierung angezeigt.
AusgabeEin Clip zum Herunterladen, in deinem Verlauf gespeichert – mit Ausgangsporträt und Skript.

So spielen Sie in Ihrem eigenen KI-Talking-Foto die Hauptrolle

Ihr Foto, Ihre Worte, ein Clip.

  1. 1

    Laden Sie ein Foto von sich hoch

    Ein klares Frontalfoto funktioniert am besten: ein Handy-Selfie, eine Porträtaufnahme oder ein Einzelbild aus einem Video. Die Talking-Foto-KI liest Ihr Gesicht aus diesem einen Bild.

  2. 2

    Fügen Sie Ihre Stimme hinzu

    Nehmen Sie sich selbst auf und laden Sie das Audio hoch, oder tippen Sie Ihr Skript und wählen Sie eine von 60 integrierten Stimmen. Das Audio kann bis zu 35 Sekunden lang sein.

  3. 3

    Generieren Sie und verwenden Sie sich selbst erneut

    Das Modell synchronisiert Lippen, Mimik und natürliche Kopfbewegungen mit dem Audio. Behalten Sie dasselbe Foto und generieren Sie neue Zeilen, wann immer Sie sie brauchen, ganz ohne Neuaufnahme.

So schreiben Sie ein Skript für ein KI-Talking-Foto

Hier gibt es keinen Bild-Prompt – das Porträt und das Audio erledigen die Arbeit. Was du schreibst, ist das Skript, und die Skriptentscheidungen bestimmen, ob das Ergebnis natürlich wirkt.

1

Einstiegssatz

Fang mit etwas Kurzem an. In der ersten Sekunde fällt die Lippensynchronisation am stärksten auf.

Hey – ganz kurz was für dich.

2

Satzlänge

Halte Sätze unter etwa 15 Wörtern. Lange Satzgefüge erzeugen unnatürliche Pausen.

Dieses Serum hat zwei Inhaltsstoffe. Das ist die ganze Formel.

3

Interpunktion

Kommas und Punkte werden zu Atempausen. Setz sie dort, wo du wirklich eine Pause machen würdest.

Es wirkt – und dauert zehn Sekunden.

4

Längenbudget

Rund 2,5 Wörter pro Sekunde. Schreib auf die Cliplänge hin, die du haben willst.

~85 Wörter für einen 35-Sekunden-Clip

Vage

Unser revolutionäres Produkt nutzt modernste Technologie, um anspruchsvollen Kundinnen und Kunden, die nach Exzellenz streben, unvergleichliche Ergebnisse zu liefern.

Konkret

Das ist der Teil, nach dem immer alle fragen. Zwei Inhaltsstoffe, keine Füller. Den Unterschied siehst du nach etwa einer Woche.

Warum es funktioniert

Der erste ist ein einziger Satz aus 19 Wörtern voller Abstraktionen – der Avatar trägt ihn in einem flachen, atemlosen Monoton vor, weil es keine Stelle zum Pausieren gibt. Der zweite besteht aus drei kurzen Sätzen mit natürlichen Betonungspunkten, und genau das lässt den Vortrag menschlich wirken.

Vage

Hallo und herzlich willkommen auf unserem Kanal, auf dem wir heute die fünf wichtigsten Dinge besprechen werden, die du über Hautpflegeroutinen wissen musst.

Konkret

Fünf Dinge über Hautpflege. Nummer eins machen die meisten falsch.

Warum es funktioniert

Lange, ununterbrochene Einstiege sind die Stelle, an der die Lippensynchronisation am stärksten abdriftet, weil das Modell keine Satzzeichen hat, an denen es sich festhalten kann. Ein kurzer Aufhänger gibt ihm saubere Betonungspunkte – und hält die Aufmerksamkeit besser.

Angewohnheiten, die du ablegen solltest

  • Ein Porträt verwenden, auf dem das Gesicht klein, schräg oder teilweise verschattet ist. Die Genauigkeit der Lippensynchronisation hängt direkt davon ab, wie deutlich der Mund im Ausgangsbild zu sehen ist.
  • Über das Audiolimit hinaus schreiben. Die Generierung ist auf 35 Sekunden Audio begrenzt – ein längeres Skript wird abgeschnitten. Teil es also in Segmente auf und verwende dasselbe Porträt erneut.
  • Dichte Fachsprache. Zahlen, Abkürzungen und lange Produktnamen sind die Stellen, an denen eine synthetische Stimme am deutlichsten synthetisch klingt. Schreib sie so, wie du sie laut sagen würdest.

Über den KI-Avatar-Videogenerator hinaus

Sprechende Avatare sind eine Ausgabeform. Bild- und Videogenerierung laufen über dasselbe Konto.

Nützliche Ressourcen zu KI-Avatar-Videos

KI-Talking-Foto – Preise und kostenlose Credits

Sprechende-Foto-Videos werden wie andere Videos pro Sekunde abgerechnet. Registriere dich kostenlos und probiere es aus.

Kostenlos

$0

Perfekt für den Einstieg

  • Kostenlose Registrierung
  • Z Image Turbo entwirft zu 0 Credits
  • Standard-Generierungsgeschwindigkeit
  • Generierungsverlauf inklusive
Loslegen

Premium

Am beliebtesten
$29/month

Jährliche Abrechnung · 240 $/Jahr

  • 8.000 Credits/Monat, keine Tageslimits
  • Alle Premium-Modelle — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • 5x schnellere Generierung, Prioritäts-Warteschlange
  • KI-Prompt-Verbesserung
Upgrade auf Premium

Ultimate

$59/month

Jährliche Abrechnung · 468 $/Jahr

  • 18.000 Credits/Monat, keine Tageslimits
  • HD-Generierung bis zu 4K-Auflösung
  • Priorisierter Support
  • Schnellste Warteschlange und früher Zugang zu neuen Modellen
Upgrade auf Ultimate

KI-Talking-Foto – Häufig gestellte Fragen

1

Was ist ein KI-Talking-Foto?

Ein KI-Talking-Foto, auch KI-Avatar oder digitaler Mensch genannt, ist ein generiertes sprechendes Video einer Person, das aus einem einzigen Foto und einer Stimme erstellt wird. Statt zu filmen, stellen Sie ein Porträt und Audio (oder ein Skript + Stimme) bereit, und das Modell animiert eine lebensechte Sprechperformance – verwendet als digitaler Präsentator, Sprecher oder Erzähler.

2

Was benötige ich, um einen zu erstellen?

Ein klares Porträtfoto von vorn, plus entweder eine Audiodatei (mp3/wav) oder – im Textmodus – der gewünschte Text und eine Stimme aus der integrierten Bibliothek. Das genügt, um ein Video mit einem sprechenden Avatar zu erstellen.

3

Kann ich meine eigene Stimme benutzen?

Ja. Laden Sie Ihre eigene Audioaufnahme hoch, und der Avatar synchronisiert die Lippenbewegungen dazu. Falls Sie keine Aufnahme haben, wechseln Sie in den Textmodus und wählen Sie stattdessen eine Stimme aus der Sprachausgabebibliothek.

4

Wie lang darf das Avatar-Video sein?

Bis zu 35 Sekunden Audio pro Generierung. Längere Texte bitte in mehrere Clips aufteilen. Die geschätzte Dauer wird während der Eingabe angezeigt, die Abrechnung erfolgt sekundengenau.

5

Wofür kann ich KI-Avatare verwenden?

Typische Anwendungsbereiche sind Produkterklärungen und -anzeigen, Kurs- und Onboarding-Kommentare, Social-Media-Clips mit sprechenden Köpfen, Ankündigungen und mehrsprachige Versionen einer Nachricht – überall dort, wo Sie sonst einen Moderator filmen müssten.

6

Welches Modell liegt dem KI-Avatar zugrunde?

CreateVision AI nutzt ByteDances OmniHuman 1.5, das Lippensynchronisation, Kopfbewegungen und Gesten anhand des Audiosignals steuert. Technische Details finden Sie auf der Produktseite von OmniHuman 1.5.

7

Welches Foto funktioniert in einem KI-Avatar-Videogenerator am besten?

Ein gut ausgeleuchtetes Porträt von vorn, auf dem das ganze Gesicht sichtbar und scharf ist. Sonnenbrillen, harte Schatten im Gesicht, extreme Blickwinkel oder ein sehr kleines Gesicht im Bild verschlechtern die Lippensynchronität.

8

Muss ich meine eigene Stimme aufnehmen?

Nein. Du kannst ein Skript eintippen und eine Stimme aus der integrierten Bibliothek wählen, die 60 Stimmen in 10 Sprachen umfasst. Eine eigene Aufnahme hochzuladen wird ebenfalls unterstützt, wenn du die lieber verwendest.

9

Kann ich selbst im Video die Hauptrolle spielen?

Ja, und es ist die häufigste Anwendung. Laden Sie ein Foto von sich hoch und nehmen Sie dann entweder Ihre eigene Stimme auf oder tippen Sie ein Skript und wählen Sie eine Bibliotheksstimme. Das Ergebnis sind Sie, der Ihre Worte spricht, ganz ohne Kamera-Setup. Viele Creator behalten ein gutes Foto und generieren jede Woche neue Clips daraus.

10

Kann ich ein KI-Talking-Foto kommerziell nutzen?

Ja. Gemäß den Nutzungsbedingungen von CreateVision AI dürfen von Ihnen generierte Inhalte für private und kommerzielle Zwecke verwendet werden, mit einer Nennung von CreateVision AI, wo angemessen. Sie sind dafür verantwortlich, die Rechte an dem Foto und der Stimme zu besitzen, die Sie hochladen, sowie für etwaige KI-Kennzeichnungspflichten der Plattform, auf der Sie veröffentlichen.

11

Ich habe mich früher mit Sora selbst in Videos eingefügt. Ist das dasselbe?

Gleiches Ziel, andere Mechanik. Hier ist Ihr Foto die Identität, und Ihr Audio oder Skript steuert die Sprache, sodass das Ergebnis ein Talking-Head-Clip mit Lippensynchronisation ist und keine Szene, in die Sie hineinversetzt werden. Es funktioniert mit jedem einzelnen Foto, erfordert keine Video-Registrierung und hängt nicht davon ab, dass eine andere App verfügbar bleibt.

Erstellen Sie Ihr erstes sprechendes KI-Foto

Jetzt erstellen