직접 주인공이 되거나, 디지털 대변인을 만드세요
촬영도, 배우도, 그린 스크린도 필요 없습니다. 자신의 선명한 사진 한 장만 업로드하면 당신이 대본을 읽어 주는 발표자가 됩니다. 당신의 목소리로, 또는 라이브러리 목소리로요. 또는 사용 허락을 받은 사람의 사진을 사용해 제품 설명, 강좌 소개, 공지, 광고에 재사용할 수 있는 디지털 진행자를 만들 수 있습니다. 재촬영 없이 언제든 새로운 대사를 다시 생성할 수 있습니다.
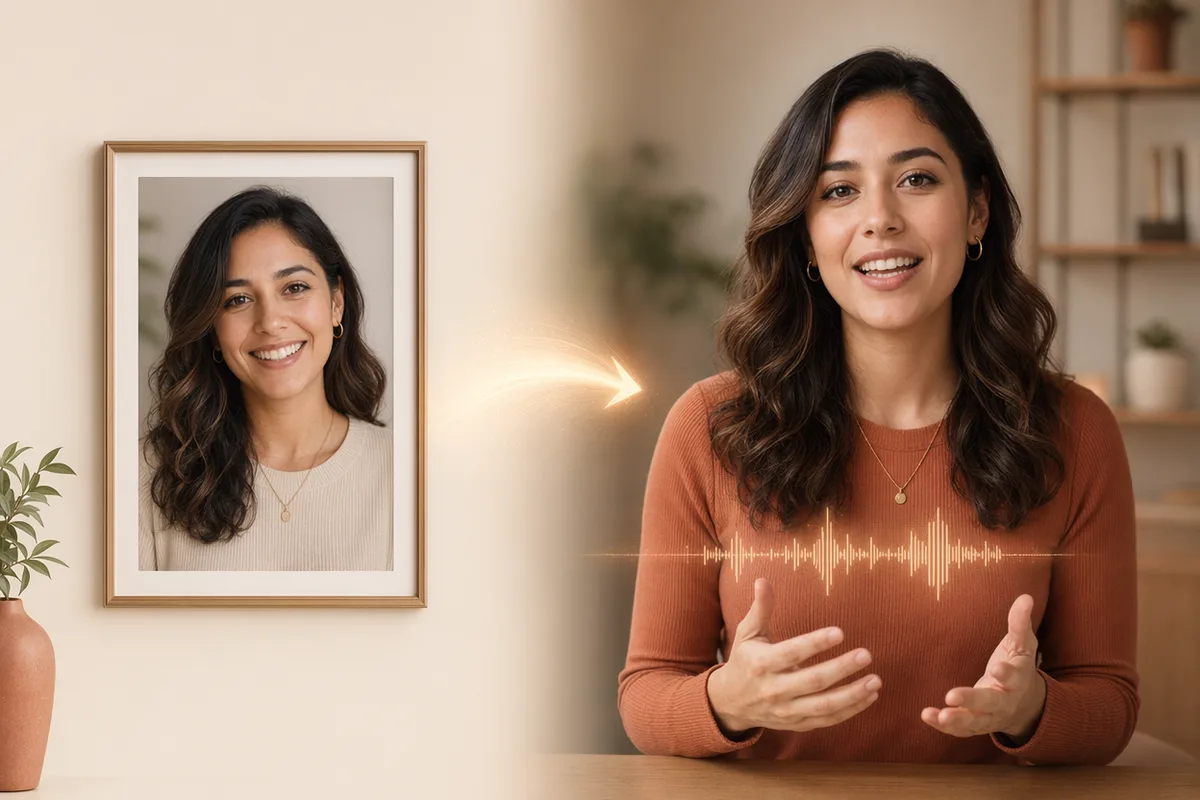
초상화와 오디오 트랙(최대 35s)을 업로드하거나 대본을 입력하고 음성을 선택하면, OmniHuman 1.5가 사진을 입술이 동기화되고 자연스러운 움직임이 있는 토킹 영상으로 바꿉니다. 본인 사진으로 직접 주인공이 되어보세요.
인물 사진 한 장과 대본만으로 생생한 발표자가 됩니다 — 입 모양·표정·제스처가 동기화. 카메라도 스튜디오도 필요 없습니다.
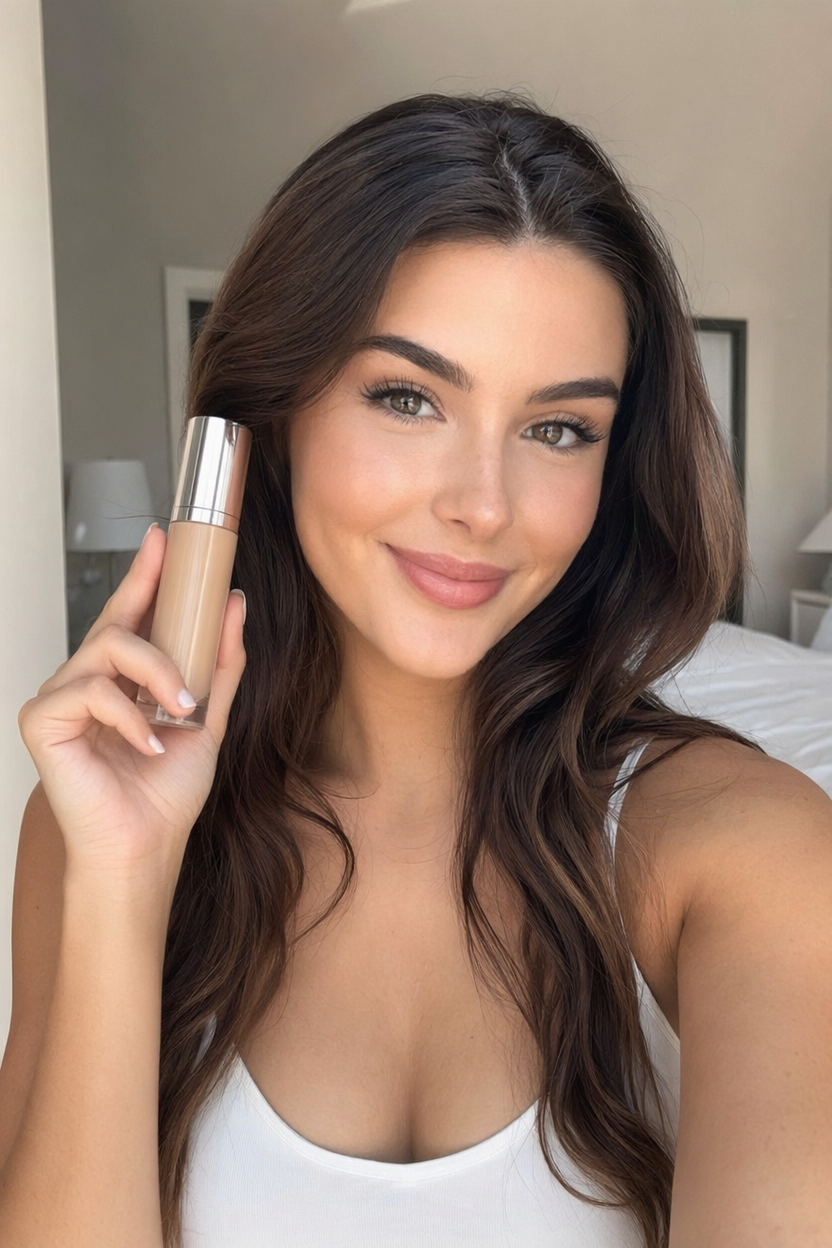
Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.
완전한 AI 말하는 사진(디지털 휴먼) 생성기: 인물 사진과 오디오 클립을 업로드하거나, 대본을 입력하고 목소리를 선택하면, 입술이 동기화되고 자연스러운 표정과 제스처가 담긴 실감 나는 말하는 영상을 받을 수 있습니다. 자신의 사진을 사용해 직접 발표자가 될 수 있습니다. ByteDance OmniHuman 1.5 기반으로, 카메라도, 배우도, 스튜디오도 필요 없습니다.
촬영도, 배우도, 그린 스크린도 필요 없습니다. 자신의 선명한 사진 한 장만 업로드하면 당신이 대본을 읽어 주는 발표자가 됩니다. 당신의 목소리로, 또는 라이브러리 목소리로요. 또는 사용 허락을 받은 사람의 사진을 사용해 제품 설명, 강좌 소개, 공지, 광고에 재사용할 수 있는 디지털 진행자를 만들 수 있습니다. 재촬영 없이 언제든 새로운 대사를 다시 생성할 수 있습니다.
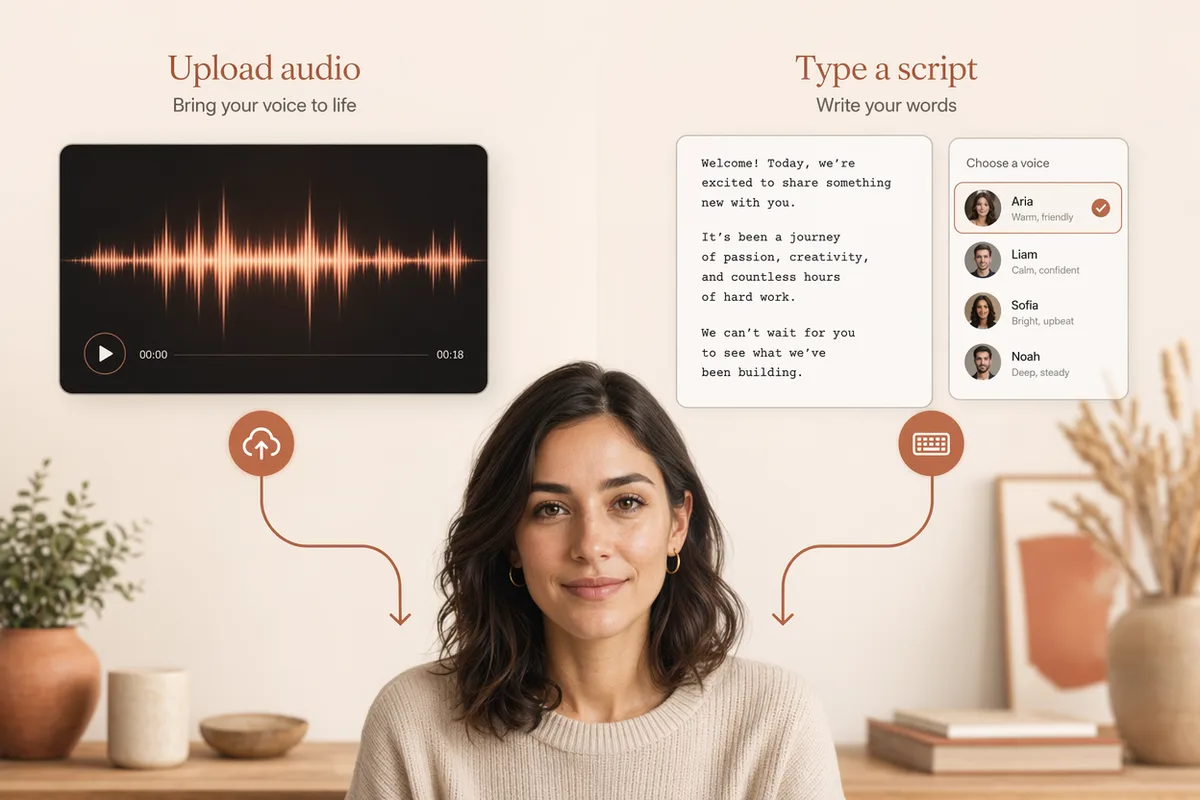
이미 음성 녹음 파일이 있으신가요? 업로드하시면 아바타가 음성에 맞춰 립싱크합니다. 음성 파일이 없으신가요? 텍스트 모드로 전환하여 아바타가 말할 내용을 입력하고 내장된 음성 라이브러리에서 음성을 선택하면 입력한 내용이 주행 오디오로 변환됩니다. 생성하기 전에 예상 소요 시간과 크레딧 비용을 확인할 수 있습니다.
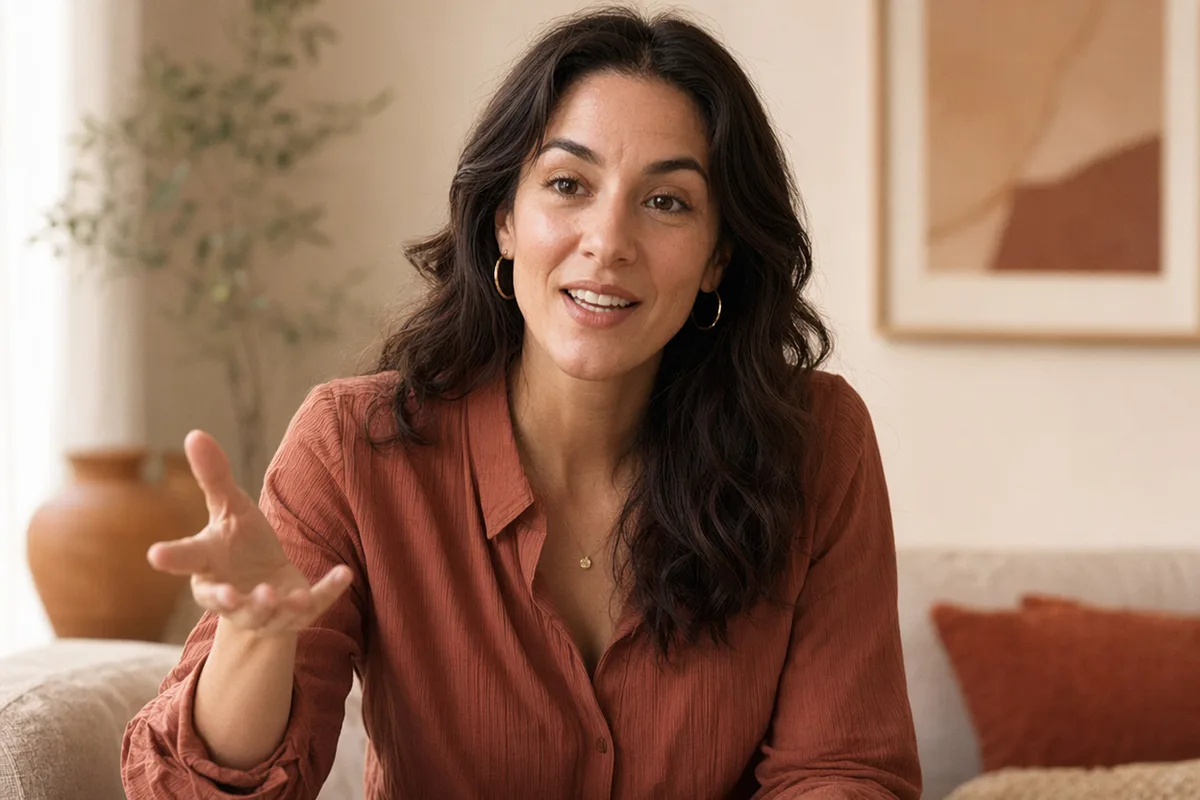
OmniHuman 1.5는 오디오의 리듬, 운율, 의미를 읽어 머리 움직임, 자세, 손동작을 정확한 립싱크와 함께 구현하는 동시에 인물의 신원과 조명도 유지합니다. 그 결과, 입만 움직이는 정적인 초상화가 아닌 실제 발표자처럼 자연스러운 모습을 연출합니다.
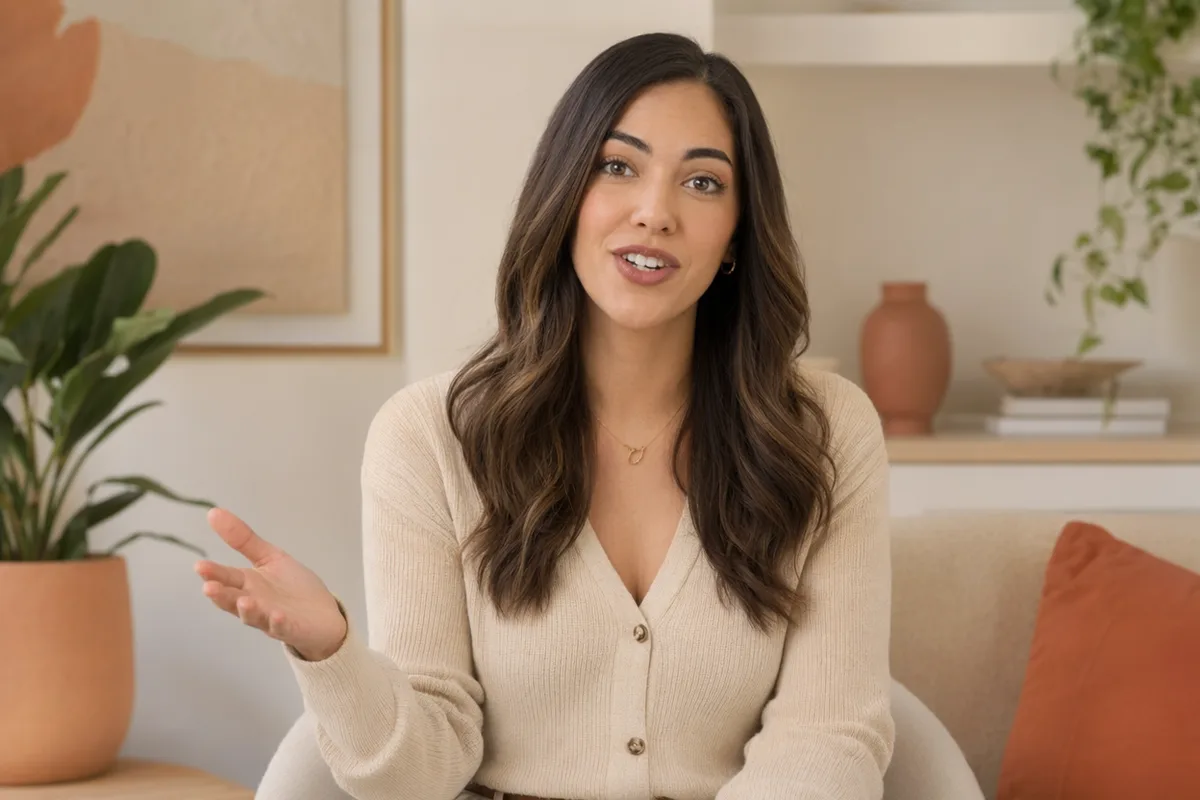
광고 및 랜딩 페이지용 대변인 영상 클립, 교육용 내레이션 강의 및 온보딩 콘텐츠, 소셜 미디어용 인터뷰 영상, 또는 동일 메시지의 다국어 버전 등을 제작해 보세요. 모든 제작 과정은 입력 내용과 함께 기록으로 저장되므로, 반복 작업을 통해 다양한 버전을 빠르게 만들어낼 수 있습니다.
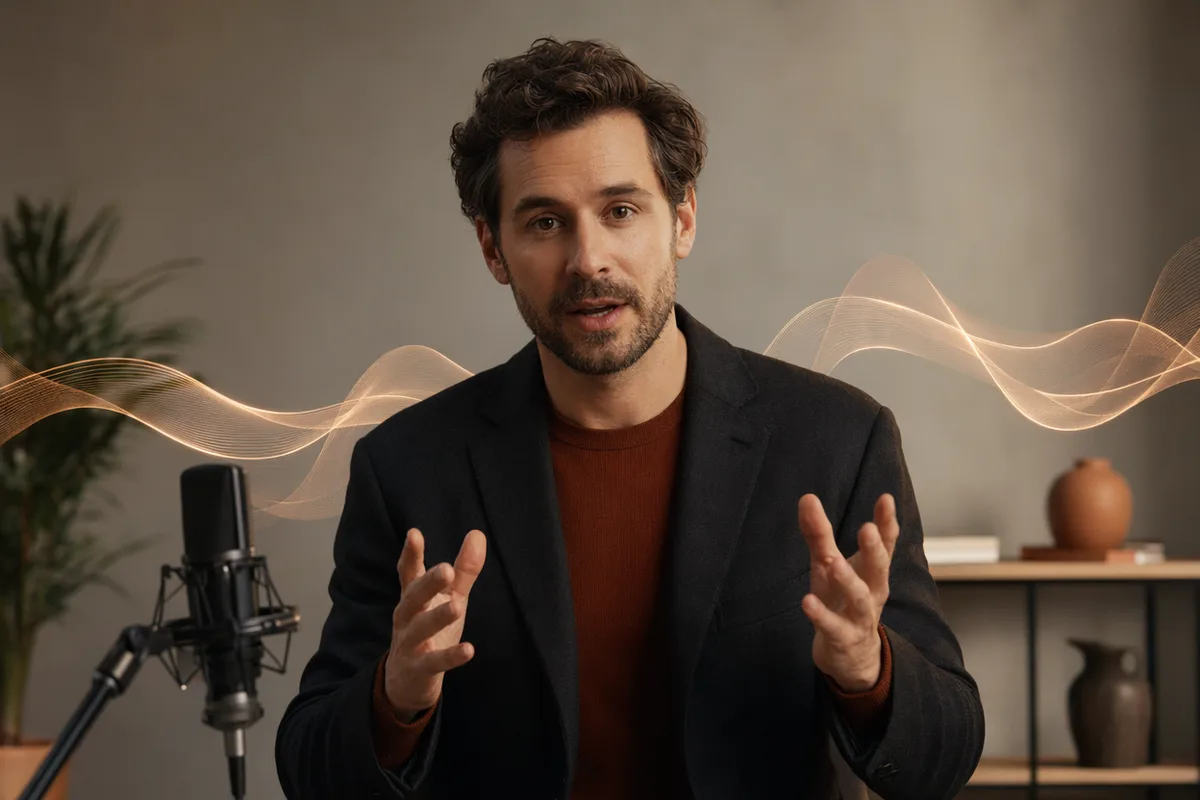
CreateVision AI에서 생성한 발표자 스타일 인물 사진입니다 — 오디오만 더하면 어느 것이든 말하는 아바타 영상으로 움직일 수 있습니다.
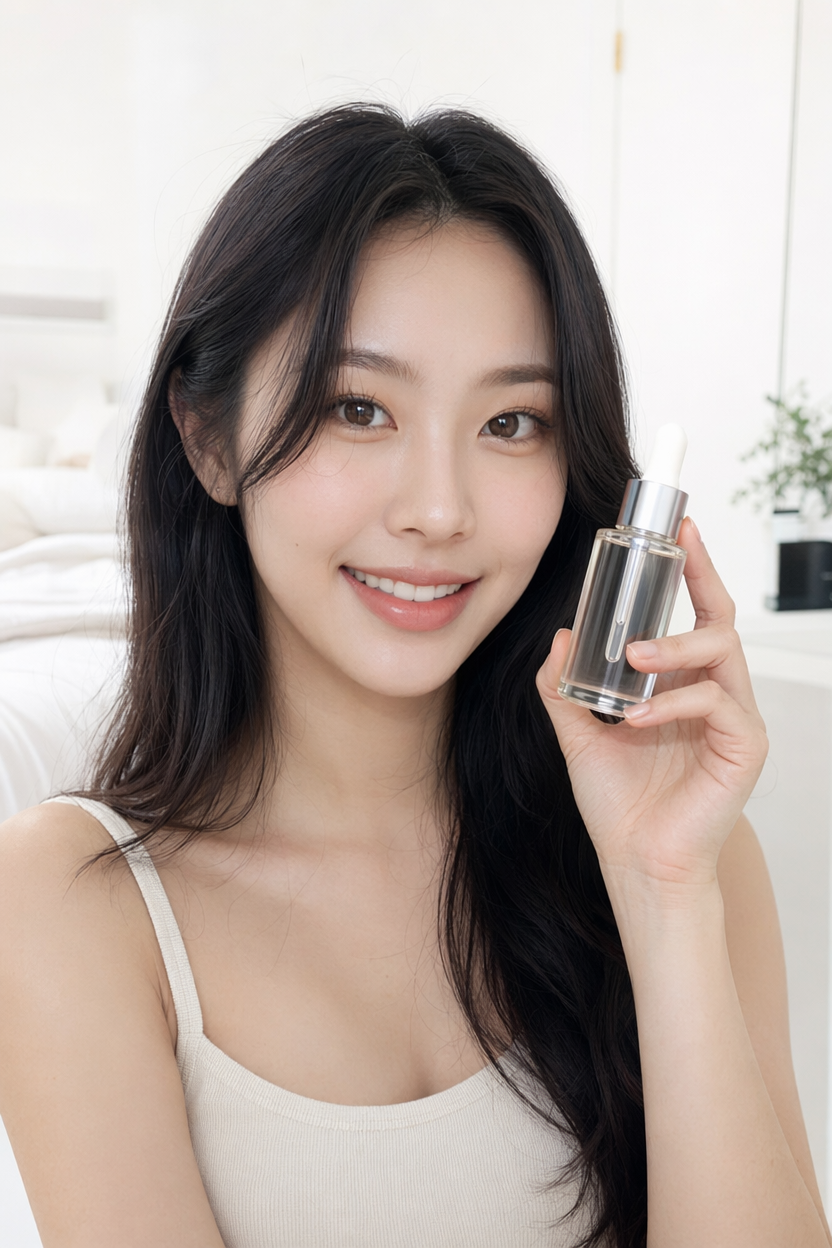
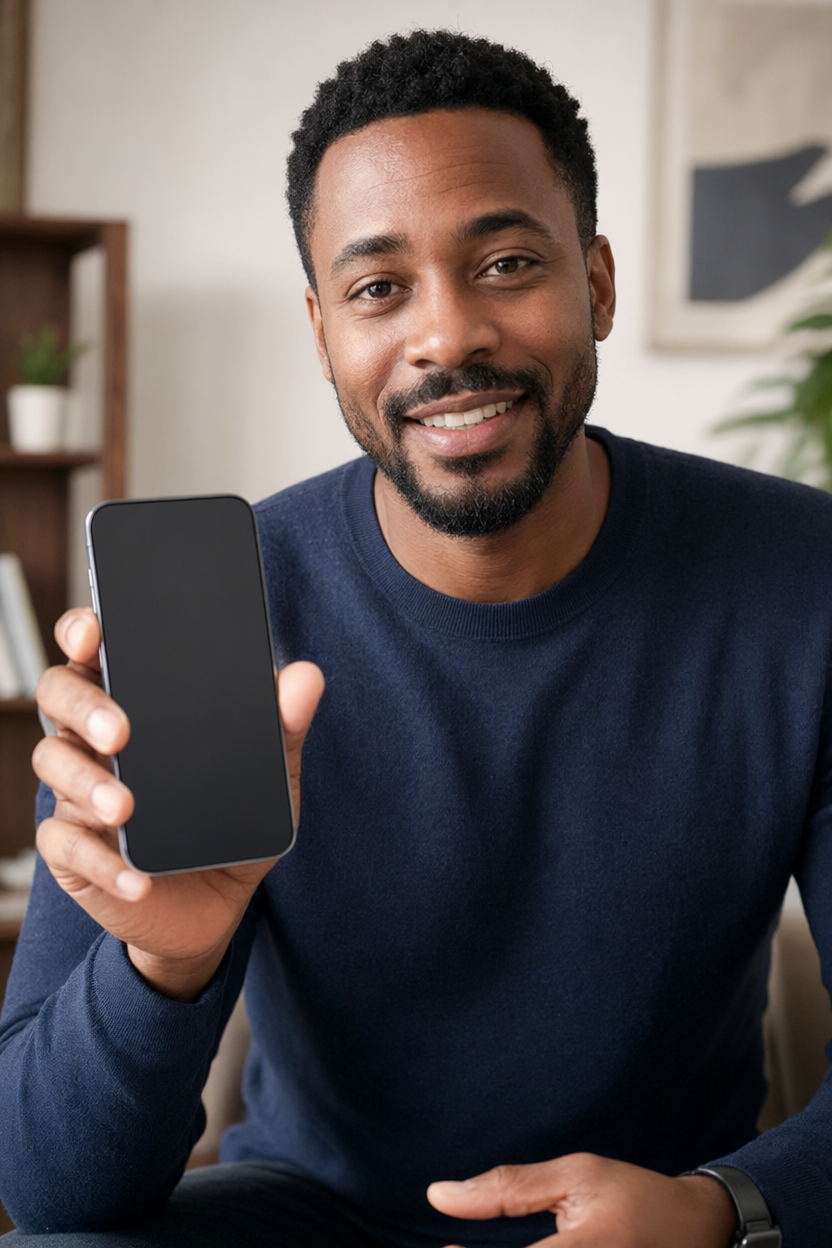
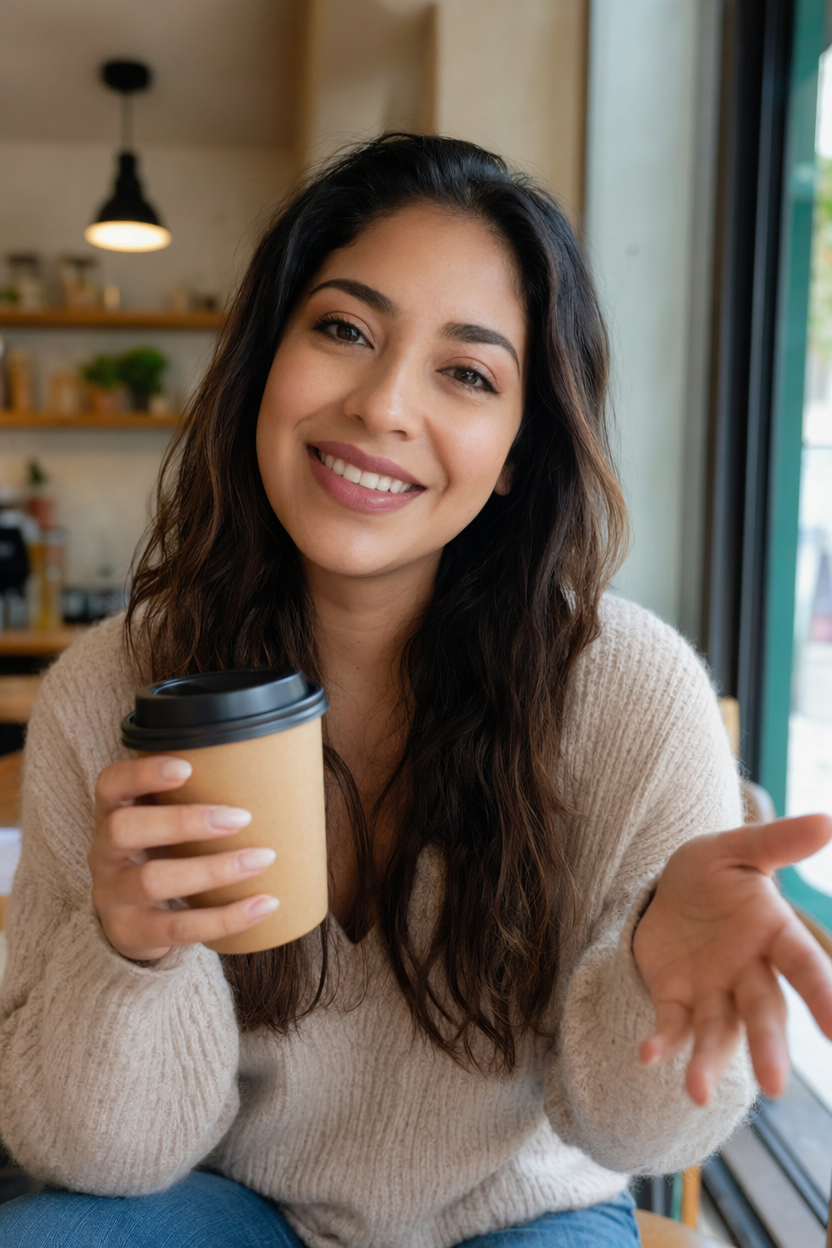
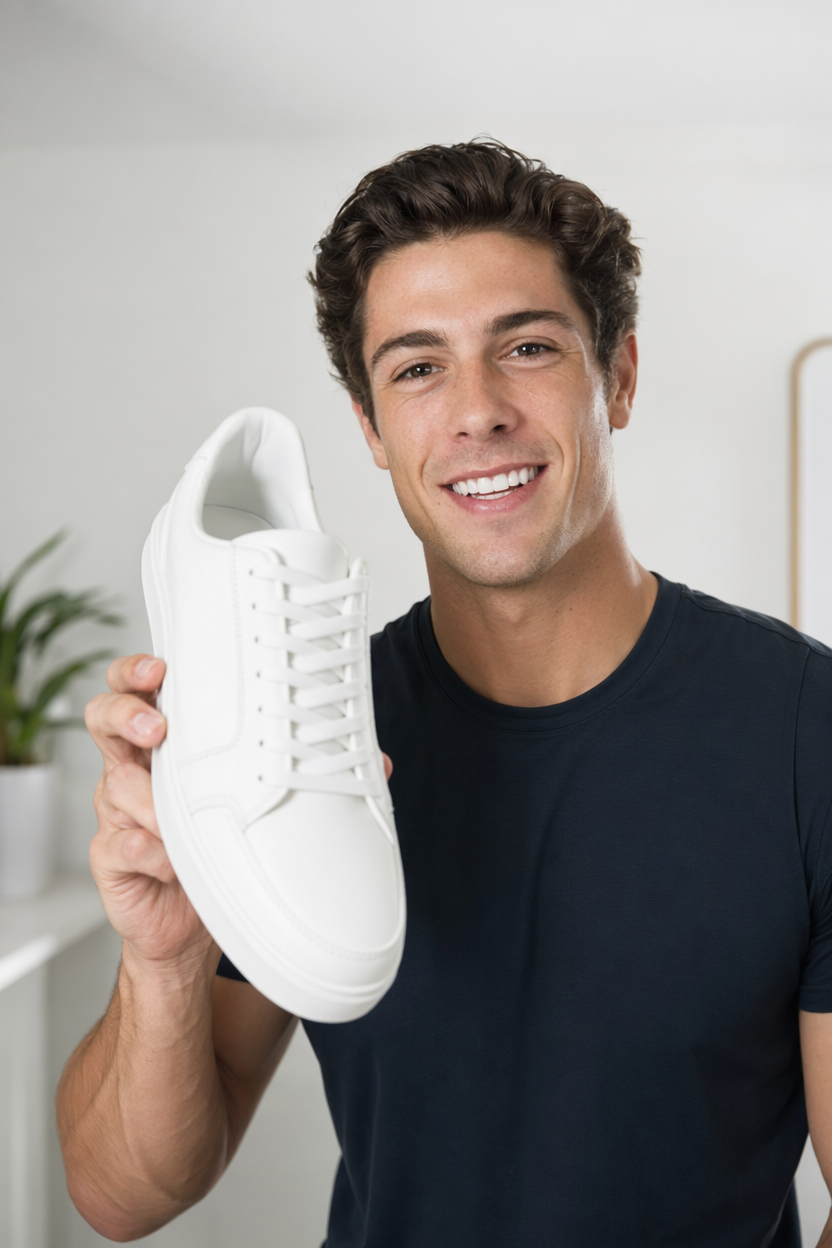
이 페이지의 립싱크, 표정, 몸동작은 OmniHuman 1.5가 구동합니다.
| 입력 | 인물 사진 한 장과, 업로드한 오디오 파일 또는 직접 입력한 대본 중 하나. |
|---|---|
| 누구의 사진 | 본인 사진이거나, 사용 허락을 받은 사람의 사진이어야 합니다. 사진과 목소리 모두 사용 권한이 당신에게 있어야 합니다. |
| 인물 사진 가이드 | 정면, 충분한 조명, 얼굴 전체가 보이고 초점이 맞을 것. 선글라스와 짙은 그림자는 립싱크 정확도를 떨어뜨립니다. |
| 오디오 길이 | 생성 1회당 최대 35초 — 말로 대략 85 단어입니다. |
| 보이스 라이브러리 | 10개 언어에 걸친 60종의 내장 보이스, 생성 전에 미리 들어볼 수 있습니다. |
| 모델 | OmniHuman 1.5. 립싱크, 표정, 그리고 자연스러운 머리와 몸의 움직임을 담당합니다. |
| 비용 | 다른 영상 생성과 마찬가지로 출력 초 단위 과금이며, 생성 전에 표시됩니다. |
| 출력 | 다운로드할 수 있는 영상. 원본 인물 사진과 대본이 함께 기록에 저장됩니다. |
당신의 사진, 당신의 말, 클립 하나.
선명한 정면 사진이 가장 좋습니다: 휴대폰 셀카, 증명사진, 또는 영상에서 캡처한 프레임. 말하는 사진 AI는 이 한 장의 프레임에서 당신의 얼굴을 읽어 냅니다.
직접 녹음해서 오디오를 업로드하거나, 대본을 입력하고 60개의 내장 목소리 중 하나를 선택하세요. 오디오는 최대 35초까지 가능합니다.
모델이 입술, 표정, 자연스러운 고개 움직임을 오디오에 맞춰 동기화합니다. 같은 사진을 유지한 채 필요할 때마다 새로운 대사를 생성하세요. 재촬영은 없습니다.
여기에는 이미지 프롬프트가 없습니다 — 일은 인물 사진과 오디오가 합니다. 당신이 쓰는 건 대본이고, 대본 선택이 결과가 자연스러워 보일지를 결정합니다.
짧은 문장으로 시작하세요. 립싱크가 가장 잘 보이는 건 첫 1초입니다.
안녕하세요, 짧게 하나만 알려드릴게요.
문장은 15 단어 안팎으로 유지하세요. 긴 절은 부자연스러운 멈춤을 만듭니다.
이 세럼은 성분이 두 개입니다. 그게 처방의 전부예요.
쉼표와 마침표는 숨쉬기가 됩니다. 실제로 쉴 자리에 찍으세요.
효과가 있습니다 — 그리고 10초면 됩니다.
대략 초당 2.5 단어. 원하는 클립 길이에 맞춰 쓰세요.
35초 클립에 약 85 단어
저희의 혁신적인 제품은 최첨단 기술을 활용하여 탁월함을 추구하는 안목 있는 고객에게 비할 데 없는 결과를 제공합니다.
다들 늘 물어보시는 부분이죠. 성분은 두 개, 채우는 건 없습니다. 일주일쯤이면 차이가 보입니다.
첫 번째는 추상어로만 된 19단어짜리 한 문장이라, 아바타가 쉴 곳이 없어 밋밋하고 숨 가쁜 단조로 읽습니다. 두 번째는 자연스러운 강세점이 있는 짧은 세 문장이고, 그래서 읽는 것이 사람처럼 들립니다.
안녕하세요, 저희 채널에 오신 것을 환영합니다. 오늘은 스킨케어 루틴에 대해 여러분이 알아야 할 가장 중요한 다섯 가지에 대해 이야기해 보려고 합니다.
스킨케어에 관한 다섯 가지. 첫 번째는 다들 틀리게 알고 있는 것.
길게 늘어지는 도입부는 립싱크가 가장 크게 어긋나는 자리입니다. 모델이 기댈 문장 부호가 없기 때문입니다. 짧은 훅은 깔끔한 강세점을 주고 집중도 더 잘 붙듭니다.
말하는 아바타는 결과물 중 하나일 뿐입니다. 이미지 생성과 영상 생성도 같은 계정에서 돌아갑니다.
말하는 사진 영상은 다른 영상 출력과 마찬가지로 초 단위로 과금됩니다. 신규 계정은 200 무료 크레딧을 받아 체험해 볼 수 있습니다.
연간 청구 · $240/year
연간 청구 · $468/년
AI 아바타 또는 디지털 휴먼이라고도 불리는 AI 말하는 사진은, 사진 한 장과 목소리로 만들어지는 사람의 말하는 영상입니다. 촬영하는 대신, 인물 사진과 오디오(또는 대본 + 목소리)를 제공하면 모델이 실감 나는 말하는 연기를 애니메이션으로 만들어 냅니다 — 디지털 발표자, 대변인, 또는 내레이터로 활용됩니다.
선명한 정면 인물 사진과 오디오 클립(mp3/wav) 또는 텍스트 모드에서는 음성으로 들려줄 스크립트와 내장 라이브러리에서 선택한 음성만 있으면 말하는 아바타 비디오를 만들 수 있습니다.
네. 직접 녹음한 음성 파일을 업로드하면 아바타가 해당 음성에 맞춰 입을 움직입니다. 녹음 파일이 없는 경우, 텍스트 모드로 전환하여 텍스트 음성 변환 라이브러리에서 음성을 선택하세요.
한 번에 최대 35초 분량의 오디오를 생성할 수 있습니다. 긴 스크립트의 경우 여러 클립으로 나누어 사용하세요. 입력하는 동안 예상 소요 시간이 표시되며, 오디오 사용량(초)에 따라 요금이 부과됩니다.
일반적인 활용 사례로는 제품 설명 및 광고, 교육 과정 및 온보딩 내레이션, 소셜 미디어용 인터뷰 영상, 공지사항, 다국어 버전 메시지 등 발표자를 촬영해야 하는 모든 곳에서 사용할 수 있습니다.
CreateVision AI는 ByteDance의 OmniHuman 1.5를 사용하여 오디오에서 입술 움직임, 머리 움직임 및 제스처를 동기화합니다. 기술 세부 정보는 OmniHuman 1.5 모델 페이지를 참조하십시오.
조명이 충분하고 얼굴 전체가 또렷하게 보이는 정면 인물 사진. 선글라스, 얼굴을 덮는 짙은 그림자, 극단적인 각도, 화면에서 얼굴이 너무 작은 경우는 모두 립싱크 정확도를 떨어뜨립니다.
아닙니다. 대본을 입력하고 내장 라이브러리에서 목소리를 고르면 됩니다. 라이브러리에는 10개 언어, 60가지 음성이 준비되어 있습니다. 직접 녹음한 파일을 쓰고 싶다면 업로드도 지원합니다.
네, 그리고 가장 일반적인 사용 방식입니다. 자신의 사진을 업로드한 다음, 직접 목소리를 녹음하거나 대본을 입력하고 라이브러리 목소리를 선택하세요. 카메라 장비 없이도 당신의 말을 하는 당신이 결과물이 됩니다. 많은 크리에이터가 좋은 사진 한 장을 보관해 두고 매주 그 사진으로 새 클립을 생성합니다.
네. CreateVision AI 서비스 약관에 따라, 귀하가 생성한 콘텐츠는 개인적 및 상업적 목적으로 사용할 수 있으며, 적절한 경우 CreateVision AI에 출처를 표기해야 합니다. 업로드하는 사진과 음성에 대한 권리를 보유할 책임, 그리고 게시하는 플랫폼의 AI 공개 규정을 준수할 책임은 귀하에게 있습니다.
목표는 같지만 작동 방식이 다릅니다. 여기서는 사진이 정체성이 되고 오디오나 대본이 말하기를 구동하므로, 결과물은 씬 안에 들어가는 것이 아니라 립싱크가 적용된 토킹헤드 클립입니다. 사진 한 장만 있으면 되고, 영상 등록이 필요 없으며, 다른 앱이 계속 이용 가능해야 한다는 조건도 없습니다.