Foto parlante IA

Carica un ritratto e una traccia audio (fino a 35s), oppure scrivi un copione e scegli una voce, e OmniHuman 1.5 trasforma la foto in un video parlante con labbra sincronizzate e movimento naturale. Usa la tua foto per esserne il protagonista.

0 / 2,000
130 cr/s · ≤35s

Da una foto a un video parlante

Un solo ritratto più un copione diventa un portavoce realistico: labbra, espressioni e gesti sincronizzati. Niente telecamera, niente studio.

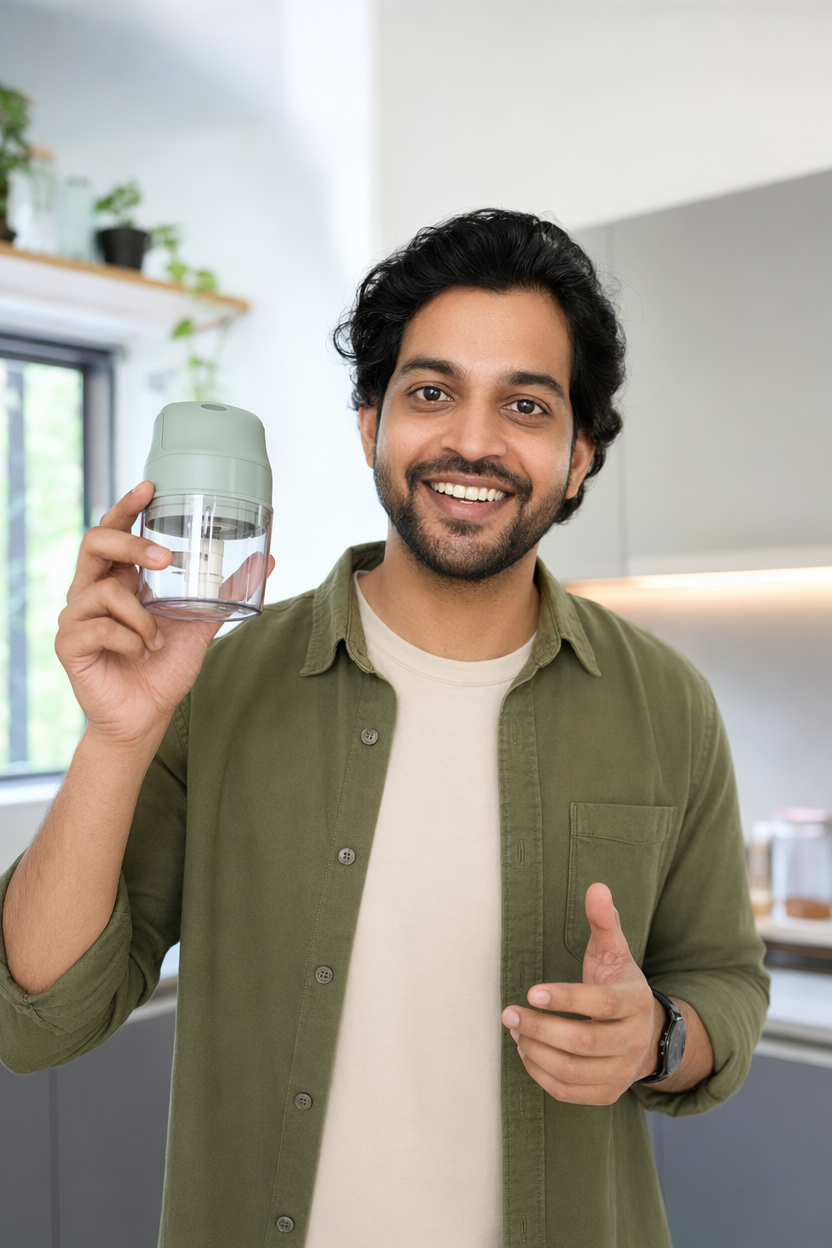
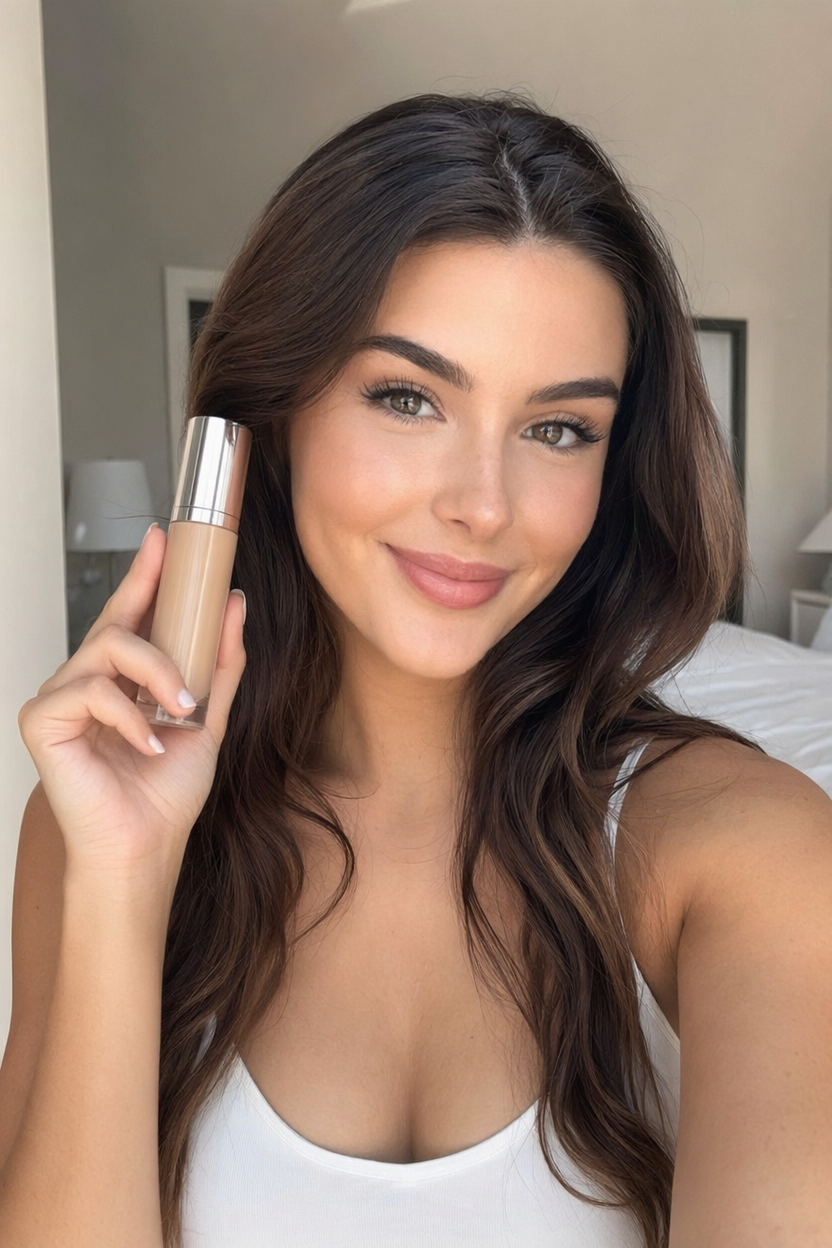
Immagine originaleOriginal portrait photo of a beauty creator holding a skincare product
Copione

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

Video avatar IA

Fai parlare qualsiasi foto, compresa la tua

Un generatore completo di foto parlanti AI (umani digitali): carica un ritratto e una clip audio, oppure scrivi un copione e scegli una voce, e ottieni un video parlato realistico con labbra sincronizzate, espressioni naturali e gesti. Usa una tua foto per essere tu il presentatore. Basato su ByteDance OmniHuman 1.5, senza bisogno di telecamera, attore o studio.

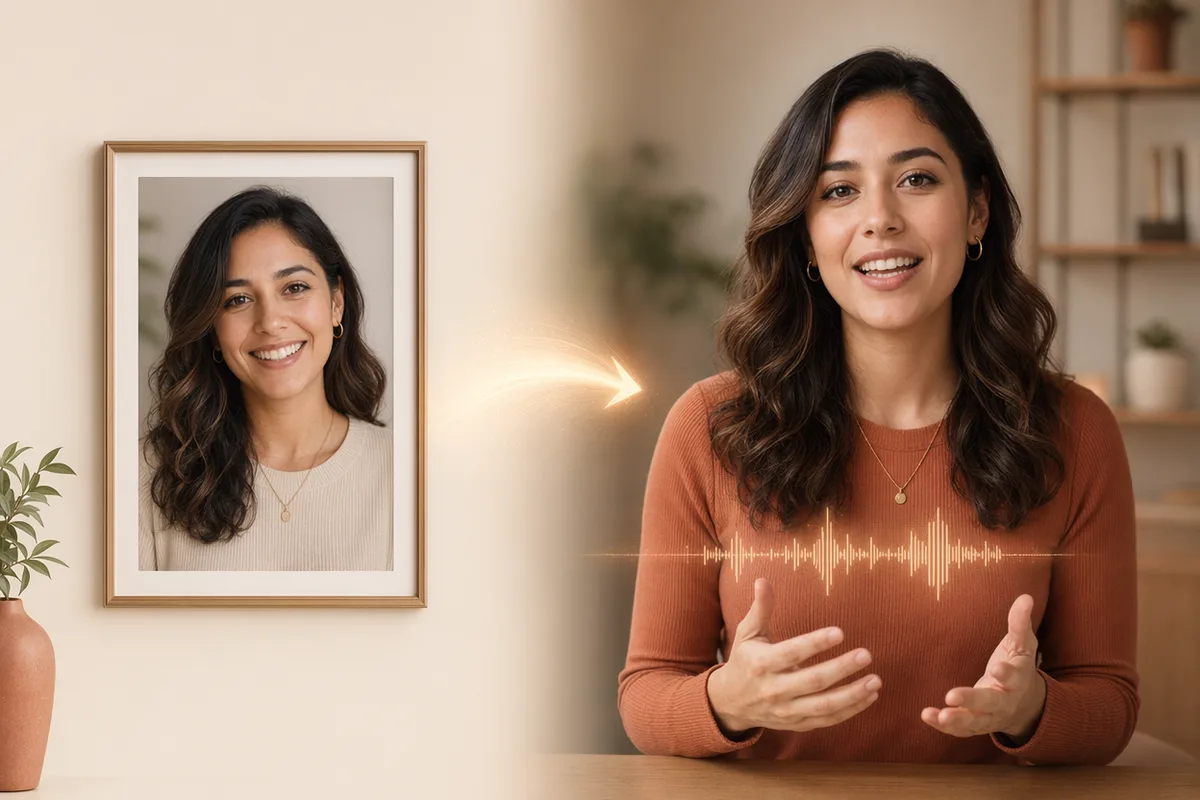
Un ritratto incorniciato che si trasforma in un avatar parlante AI della stessa donna, con una forma d'onda audio tra i due

Protonista tu stesso, oppure crea un portavoce digitale

Niente riprese, niente attore, niente green screen. Carica una tua foto nitida e diventi il presentatore che legge il tuo copione, con la tua voce o con una voce della libreria. Oppure usa la foto di una persona che ti ha dato il permesso e crea un conduttore digitale riutilizzabile per spiegazioni di prodotti, introduzioni di corsi, annunci e pubblicità. Rigenera nuove battute in qualsiasi momento senza rigirare.
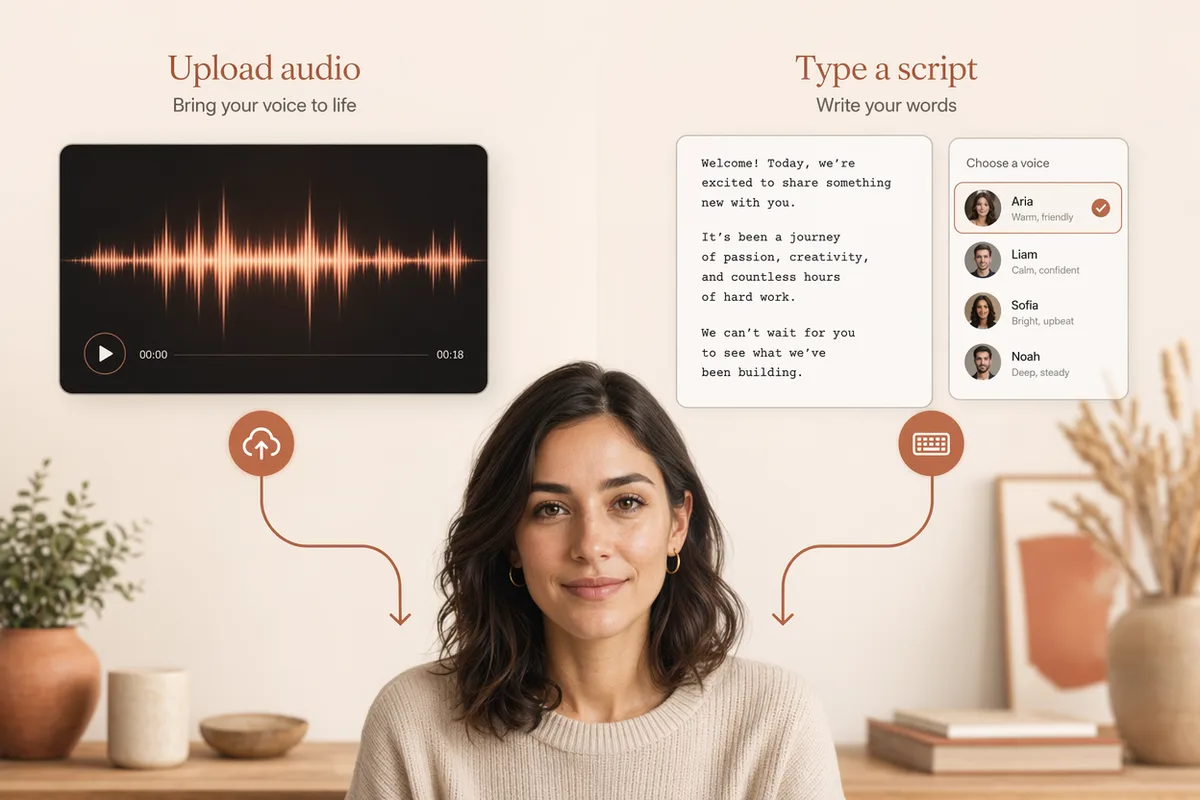
Due input per una foto parlante AI: una forma d'onda audio caricata e un copione scritto con un selettore di voce

Due modalità di accesso: caricare un file audio o scrivere una sceneggiatura.

Hai già una registrazione vocale? Caricala e l'avatar sincronizzerà le labbra con essa. Nessun audio? Passa alla modalità testo: digita ciò che l'avatar deve dire, scegli una voce dalla libreria di sintesi vocale integrata e il testo verrà sintetizzato automaticamente nell'audio di guida. La durata stimata e il costo in crediti vengono visualizzati prima della generazione.

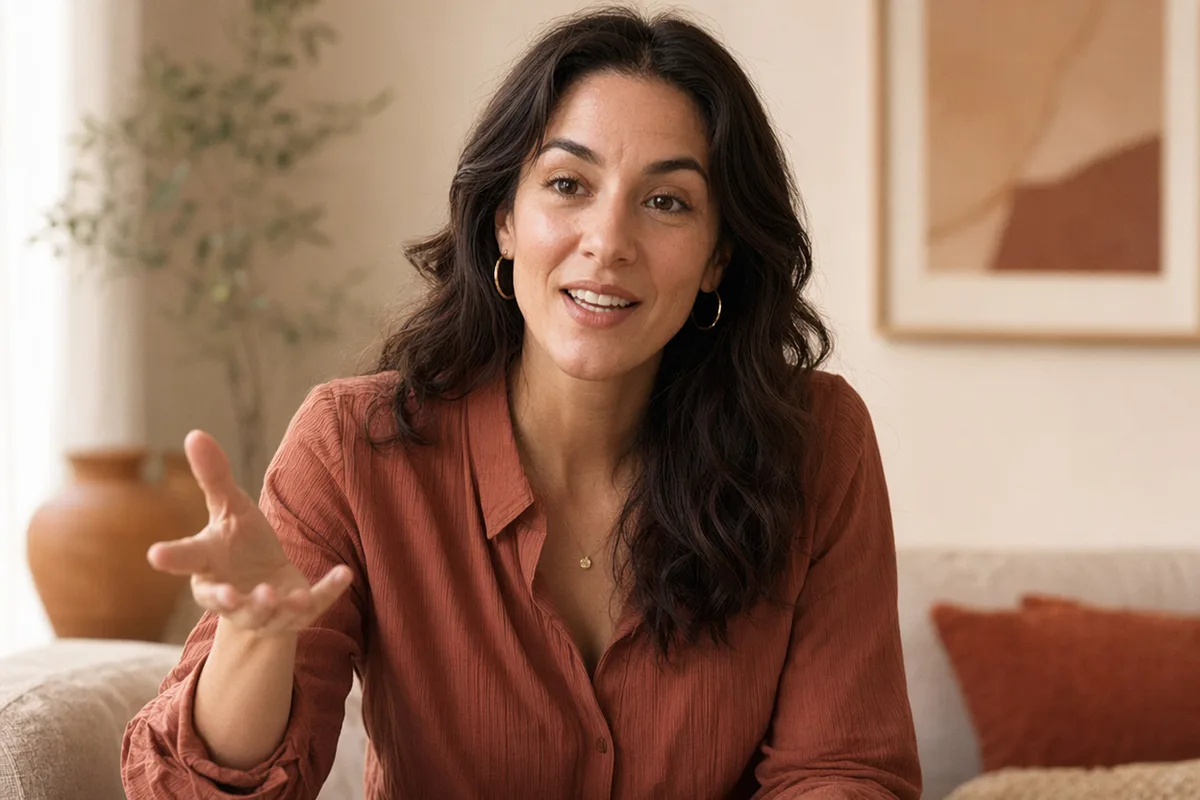
Fermo immagine di foto parlante AI di una donna che parla alla telecamera con gesti naturali delle mani

Realistico, non solo una bocca che si muove

OmniHuman 1.5 analizza il ritmo, la prosodia e il significato dell'audio per guidare i movimenti della testa, la postura e i gesti delle mani, garantendo al contempo una sincronizzazione labiale precisa e preservando l'identità e l'illuminazione della persona. Il risultato è un presentatore reale, non un ritratto statico con una bocca animata.

Presentatore di foto parlante AI in un soggiorno che presenta una breve clip social

Creato per il marketing, la formazione e i social

Crea clip con testimonial per annunci e landing page, lezioni narrate e video di onboarding per la formazione, post con presentatori per i social media o versioni multilingue dello stesso messaggio. Ogni generazione viene salvata nella cronologia con i relativi input, in modo da poter iterare e produrre rapidamente varianti.

Ritratti pronti per AI Talking Photo

Ritratti in stile presentatore generati su CreateVision AI: uno qualsiasi può animare un video di avatar parlante non appena aggiungi l'audio.

Avatar IA di una creatrice di prodotti di bellezza che presenta un siero per la cura della pelle.
Avatar IA di un recensore tecnologico che presenta uno smartphone
Avatar IA di un creatore di lifestyle con una tazza di caffè.
Avatar AI di un recensore di scarpe da ginnastica che presenta una scarpa
Avatar IA di una stilista con una borsetta
Avatar IA di un creatore di contenuti per il benessere che presenta integratori.
Avatar IA di una creatrice di prodotti di bellezza con una boccetta di profumo
Avatar IA di un creatore di ricette casalinghe con un utensile da cucina

Il modello dietro questo generatore di foto parlanti AI

OmniHuman 1.5 guida il sincronismo labiale, l'espressione e il movimento del corpo in questa pagina.

Specifiche di AI Talking Photo

InputUna foto ritratto più un file audio caricato oppure un copione scritto.
Di chi è la fotoTua, o di una persona che ti ha dato il permesso. Sia la foto che la voce devono essere tue per poterle usare.
Indicazioni sul ritrattoDi fronte, ben illuminato, volto intero visibile e a fuoco. Occhiali da sole e ombre marcate riducono la precisione del lip sync.
Durata dell'audioFino a 35 secondi per generazione — circa 85 parole parlate.
Libreria di voci60 voci integrate in 10 lingue, con anteprime disponibili prima di generare.
ModelloOmniHuman 1.5, che governa lip sync, espressione facciale e movimento naturale di testa e corpo.
CostoAddebitato al secondo di output come le altre generazioni video; mostrato prima di generare.
OutputUna clip scaricabile, salvata nella tua cronologia insieme al ritratto di partenza e al copione.

Come essere il protagonista della tua foto parlante AI

La tua foto, le tue parole, una clip.

  1. 1

    Carica una tua foto

    Una foto nitida e frontale funziona meglio: un selfie col telefono, un primo piano o un fotogramma di un video. L'AI della foto parlante legge il tuo volto da questo singolo fotogramma.

  2. 2

    Aggiungi la tua voce

    Registrati e carica l'audio, oppure scrivi il tuo copione e scegli una delle 60 voci integrate. L'audio può durare fino a 35 secondi.

  3. 3

    Genera, poi riutilizza te stesso

    Il modello sincronizza labbra, espressione e movimento naturale della testa con l'audio. Mantieni la stessa foto e genera nuove battute ogni volta che ti servono, senza nuove riprese.

Come scrivere un copione per una foto parlante AI

Qui non c'è un prompt di immagine — il ritratto e l'audio fanno il lavoro. Quello che scrivi è il copione, e le scelte del copione decidono se il risultato sembra naturale.

1

Frase di apertura

Parti con qualcosa di breve. Il primo secondo è dove il lip sync si nota di più.

Ehi — ci vuole un attimo.

2

Lunghezza delle frasi

Tieni le frasi sotto le 15 parole circa. Le subordinate lunghe producono pause innaturali.

Questo siero ha due ingredienti. È tutta qui la formula.

3

Punteggiatura

Le virgole e i punti diventano respiri. Mettili dove faresti davvero una pausa.

Funziona — e ti prende dieci secondi.

4

Budget di durata

Circa 2,5 parole al secondo. Scrivi puntando alla durata di clip che vuoi.

~85 parole per una clip da 35 secondi

Vago

Il nostro prodotto rivoluzionario utilizza tecnologia all'avanguardia per offrire risultati impareggiabili a una clientela esigente in cerca di eccellenza.

Specifico

Questa è la parte su cui mi chiedono sempre. Due ingredienti, nessun riempitivo. La differenza la vedi in circa una settimana.

Perché funziona

Il primo è una sola frase di 19 parole fatta di astrazioni — l'avatar la recita con un tono piatto e senza fiato, perché non c'è nessun punto in cui fermarsi. Il secondo è fatto di tre frasi brevi con appoggi naturali, ed è questo che rende la lettura umana.

Vago

Ciao e benvenuti sul nostro canale, dove oggi parleremo delle cinque cose più importanti che devi sapere sulle routine per la cura della pelle.

Specifico

Cinque cose sulla cura della pelle. La numero uno è quella che quasi tutti sbagliano.

Perché funziona

Le aperture lunghe e senza pause sono il punto in cui il lip sync si scolla di più, perché il modello non ha punteggiatura a cui ancorarsi. Un gancio breve gli dà appoggi chiari e tiene meglio l'attenzione.

Abitudini da abbandonare

  • Usare un ritratto in cui il volto è piccolo, di sbieco o parzialmente in ombra. La precisione del lip sync dipende direttamente da quanto chiaramente si vede la bocca nell'immagine di partenza.
  • Scrivere oltre il limite audio. La generazione si ferma a 35 secondi di audio — un copione più lungo viene tagliato, quindi dividilo in segmenti e riusa lo stesso ritratto.
  • Linguaggio tecnico fitto. Numeri, sigle e nomi di prodotto lunghi sono i punti in cui una voce sintetica suona più chiaramente sintetica. Scrivili come li diresti ad alta voce.

Oltre il generatore di video avatar IA

Gli avatar parlanti sono uno dei risultati possibili. La generazione di immagini e video parte dallo stesso account.

Risorse utili sui video avatar IA

Prezzi di AI Talking Photo e crediti gratuiti

I video di foto parlanti vengono addebitati al secondo come gli altri output video. I nuovi account ricevono 200 crediti gratuiti per provarlo.

Gratis

$0

Perfetto per iniziare

  • 200 crediti di benvenuto, fino a 80/giorno
  • Z Image Turbo crea bozze a 0 crediti
  • Velocità di generazione standard
  • Cronologia delle generazioni inclusa
Inizia

Premium

Più popolare
$29/month

Fatturazione annuale · 240 $/anno

  • 8.000 crediti/mese, nessun limite giornaliero
  • Tutti i modelli premium — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • Velocità di generazione 5x, coda prioritaria
  • Ottimizzazione dei prompt con IA
Passa a Premium

Ultimate

$59/month

Fatturazione annuale · 468 $/anno

  • 18.000 crediti/mese, nessun limite giornaliero
  • Generazione HD fino alla risoluzione 4K
  • Supporto prioritario
  • Coda più rapida e accesso anticipato ai nuovi modelli
Passa a Ultimate

AI Talking Photo — Domande frequenti

1

Che cos'è una foto parlante AI?

Una foto parlante AI, chiamata anche avatar AI o umano digitale, è un video parlato generato di una persona, creato da una singola foto e una voce. Invece di filmare, fornisci un ritratto e un audio (o un copione + voce), e il modello anima una performance parlata realistica — usata come presentatore digitale, portavoce o narratore.

2

Di cosa ho bisogno per crearne uno?

Una foto ritratto nitida e frontale, più un file audio (mp3/wav) oppure, in modalità testo, il testo che si desidera far pronunciare e una voce scelta dalla libreria integrata. Questo è sufficiente per generare un video avatar parlante.

3

Posso usare la mia voce?

Sì. Carica la tua registrazione audio e l'avatar la sincronizzerà con essa. Se non hai una registrazione, passa alla modalità testo e scegli una voce dalla libreria di sintesi vocale.

4

Quanto può durare il video dell'avatar?

Fino a 35 secondi di audio per generazione. Per script più lunghi, dividili in più clip. La durata stimata viene visualizzata durante la digitazione e il costo viene calcolato al secondo di audio.

5

A cosa posso utilizzare gli avatar basati sull'intelligenza artificiale?

Tra gli utilizzi più comuni figurano video esplicativi e pubblicitari di prodotti, narrazioni per corsi e programmi di onboarding, clip con presentatori sui social media, annunci e versioni multilingue di un messaggio: in tutti quei casi in cui sarebbe altrimenti necessario filmare un relatore.

6

Quale modello alimenta l'avatar basato sull'intelligenza artificiale?

CreateVision AI utilizza OmniHuman 1.5 di ByteDance, che gestisce la sincronizzazione labiale, i movimenti della testa e i gesti a partire dall'audio. Per i dettagli tecnici, consultare la pagina del modello OmniHuman 1.5.

7

Quale foto funziona meglio in un generatore di video avatar IA?

Un ritratto frontale ben illuminato in cui tutto il volto sia visibile e a fuoco. Occhiali da sole, ombre marcate sul viso, angolazioni estreme o un volto molto piccolo nell'inquadratura riducono tutti la precisione del sincronismo labiale.

8

Devo registrare la mia voce?

No. Puoi scrivere un copione e scegliere una voce dalla libreria integrata, che comprende 60 voci in 10 lingue. Se preferisci, puoi anche caricare una tua registrazione.

9

Posso essere io il protagonista del video?

Sì, ed è l'uso più comune. Carica una tua foto, poi registra la tua voce oppure scrivi un copione e scegli una voce della libreria. Il risultato sei tu, che dici le tue parole, senza alcuna attrezzatura video. Molti creator conservano una buona foto e generano da essa nuove clip ogni settimana.

10

Posso usare una foto parlante AI per scopi commerciali?

Sì. In base ai Termini di servizio di CreateVision AI, i contenuti che generi possono essere usati per scopi personali e commerciali, con attribuzione a CreateVision AI dove appropriato. Sei responsabile di avere i diritti sulla foto e sulla voce che carichi, e di eventuali regole di divulgazione dell'IA sulla piattaforma in cui pubblichi.

11

Prima mi inserivo nei video con Sora. È la stessa cosa?

Stesso obiettivo, meccaniche diverse. Qui la tua foto è l'identità e il tuo audio o copione guida il parlato, quindi il risultato è una clip parlante con sincronizzazione labiale anziché una scena in cui vieni inserito. Funziona da qualsiasi singola foto, non richiede registrazione video e non dipende dalla disponibilità continua di un'altra app.

Crea la tua prima foto parlante con l'IA

Inizia a creare