Generatore da testo a video

Descrivi la scena, il movimento, l'atmosfera e la regia della camera, poi genera il video con un modello e un set di parametri adatti al lavoro.

Da prompt a movimentoControllo della durataSelezione del modello video
0 / 2,000
~75 cr

IA text-to-video — scrivi la scena, ottieni le riprese

Descrivi soggetto, movimento, atmosfera e cinepresa, e genera clip cinematografiche con audio nativo. Basato su Seedance 2.0 — il modello che attualmente vince i voti di preferenza alla cieca — insieme a Veo 3.1 Fast.

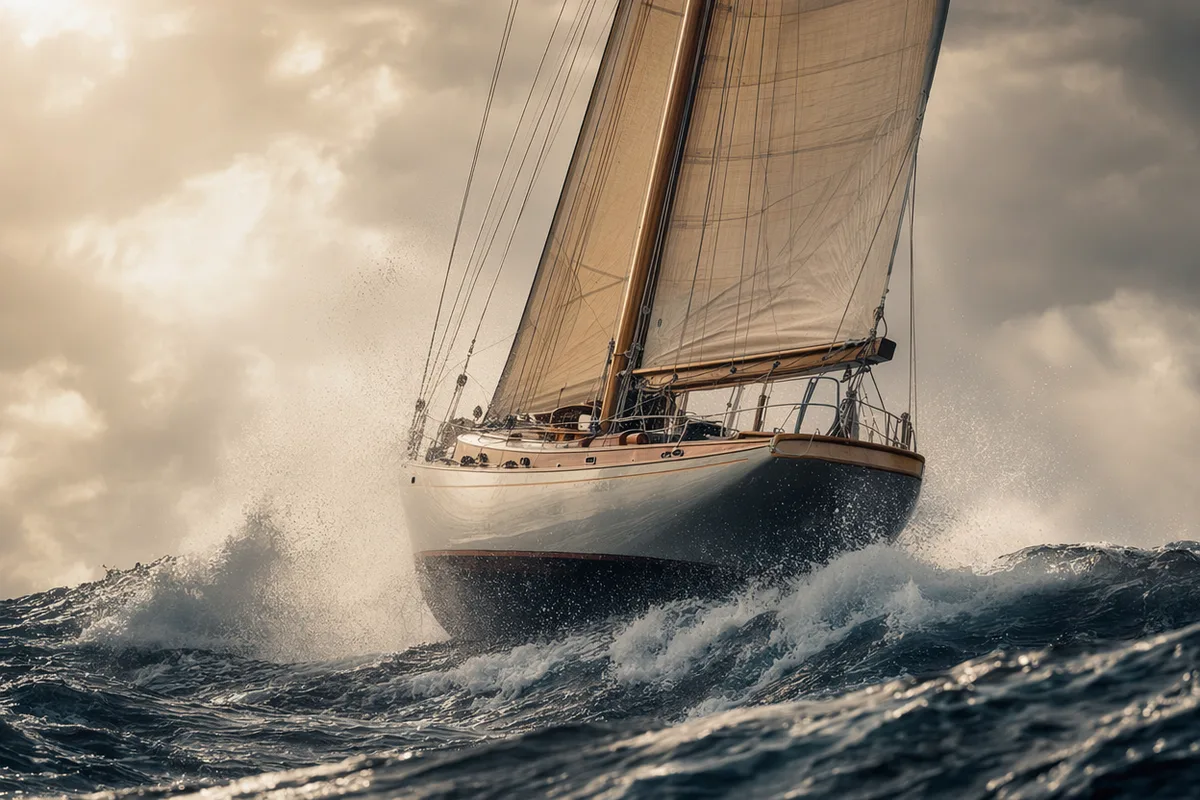
Fotogramma cinematografico IA di una barca a vela in una tempesta

Scene cinematografiche da semplici frasi

Una tempesta in mare, un inseguimento per strade al neon, una tavola calda silenziosa di notte: scrivilo come lo racconteresti a un amico, e il modello si occupa della regia. L'output di Veo viene descritto ripetutamente come "diretto, non generato": luce intenzionale, fisica credibile, una vera grammatica della cinepresa.
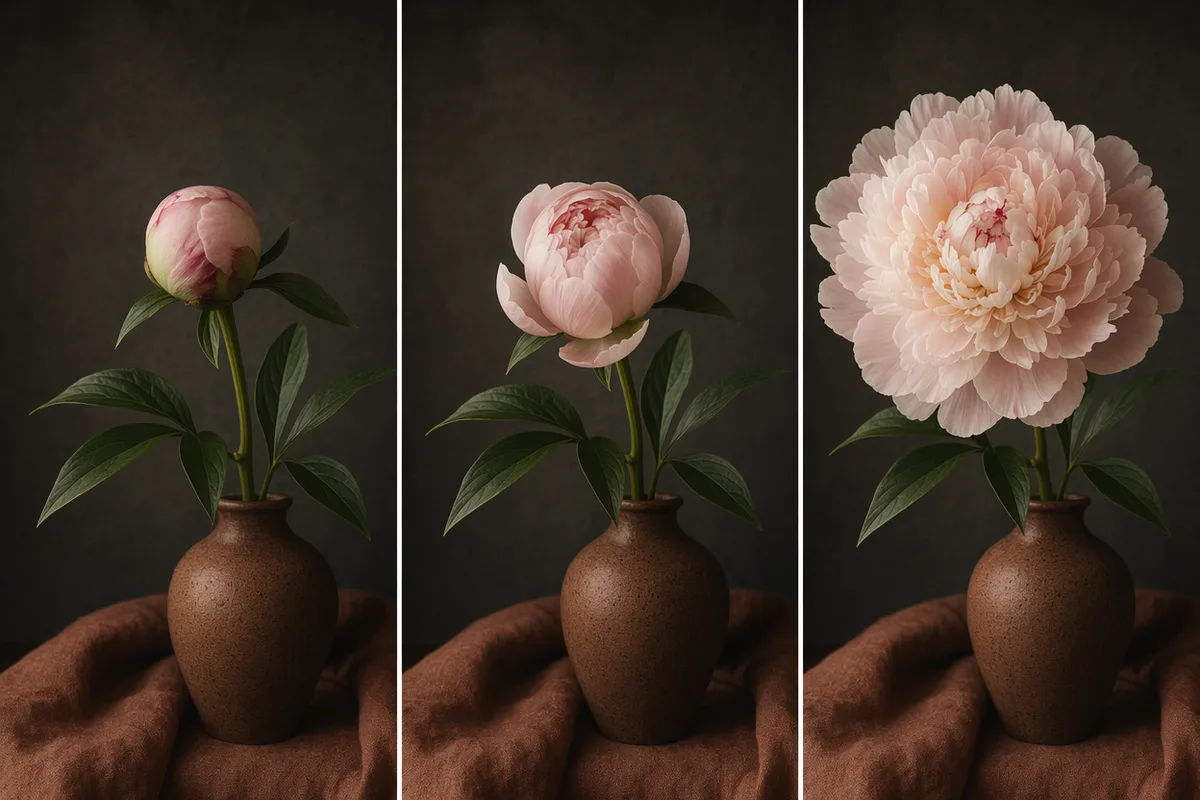
Sequenza timelapse di un fiore che sboccia in tre fotogrammi

Movimento e tempistiche che puoi specificare

Lenta carrellata in avanti, fioritura in timelapse, energia a mano libera — la direzione del movimento nel prompt viene seguita, e la durata sta a te impostarla (4–15 secondi a seconda del modello). La clip corrisponde al brief invece di approssimarlo.

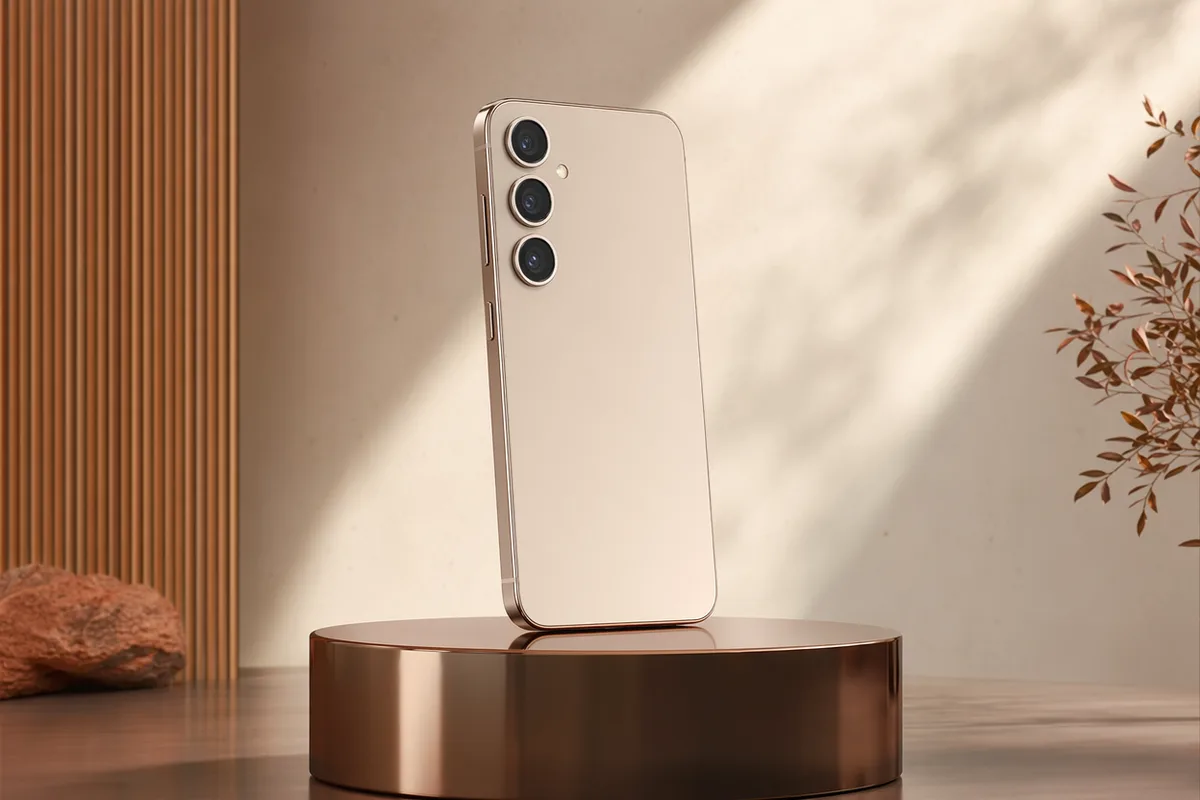
Fotogramma video di prodotto in stile commerciale con uno smartphone che ruota

Clip di prodotto e di brand in pochi minuti

Scatti hero che ruotano, versate, unboxing — filmati in stile commerciale che prima richiedevano una sessione in studio si generano da un paragrafo. I prezzi al secondo con il costo esatto mostrato in anticipo mantengono le campagne dentro il budget.

Timelapse dello skyline di una città con scie di luce al crepuscolo

Sonoro incluso, pronto per il verticale

Dialogo nativo, ambiente sonoro ed effetti arrivano insieme al video; sia il 9:16 verticale che il 16:9 panoramico sono di prima classe. L'output è una clip pronta da pubblicare, non una bozza muta.

Clip da testo a video realizzate su questa pagina

Ognuna è partita solo da un testo scritto, nient'altro. Il prompt che l'ha prodotta è riportato sotto.

PromptSeedance 2.5 · 480p · 16:9 · clip da 4 s · 440 crediti

A ceramicist in a sunlit workshop looks up from the wheel and speaks warmly to camera: "This one finally came out right." Clay-dusted hands, natural skin texture, shallow depth of field, soft window light, ambient studio room tone.

PromptSeedance 2.0 Mini · 720p · 16:9 · clip da 5 s · 150 crediti

A golden retriever puppy sprinting across a sunlit meadow toward the camera, ears flapping, slow-motion feel, backlit grass glowing, joyful energy.

PromptKling 3.0 Turbo · 1080p · 16:9 · 5 s · 350 crediti

A parkour athlete vaulting across rooftop gaps at golden hour, dynamic tracking camera, accurate body mechanics and momentum, dust kicked up on landings, cinematic sports energy.

PromptSeedance 2.0 Mini · 720p · 9:16 · 5 s · 150 crediti

Handheld vertical walk through a neon night market, steam rising from food stalls, lanterns swaying, people passing in soft motion blur, lively street ambience.

PromptKling 3.0 Turbo · 720p · 16:9 · 5 s · 275 crediti

Close-up of an elderly fisherman laughing warmly at dusk on a boat deck, wrinkles and windblown hair rendered naturally, genuine expressive performance, handheld documentary feel.

PromptSeedance 2.0 Mini · 480p · 16:9 · 4 s · 60 crediti

Two tiny paper boats racing down a rain-gutter stream after a storm, water rushing over pebbles, playful close follow shot.

PromptKling 3.0 Turbo · 720p · 9:16 · 5 s · 275 crediti

Vertical fashion film: a model in a flowing emerald dress walking toward camera down a rain-slick runway, fabric rippling naturally with each step, confident stride, editorial lighting.

PromptSeedance 2.5 · 480p · 16:9 · 4 s · 440 crediti · la lavagna è uscita come «SOUPE DU JWIN»

Close-up of a chef\'s hands rapidly julienning a carrot on a wooden board, knife tapping fast, a handwritten chalkboard menu reading "SOUPE DU JOUR" visible behind, busy kitchen sounds.

Modelli da testo a video tra cui puoi passare

Una scena scritta, più motori: scegli quello il cui movimento ti convince.

Specifiche da testo a video

InputSolo prompt testuale — nessuna immagine necessaria.
Lingue dei promptTutte le 27 lingue dell'interfaccia; i prompt non in inglese vengono arricchiti prima della generazione.
DurataDa 4 a 30 secondi a seconda del modello. I pezzi più lunghi si costruiscono estendendo una clip che ti piace.
Risoluzione480p e 720p su tutta la gamma; 1080p e 4K su Seedance 2.0 standard.
AudioAlcuni motori generano audio sincronizzato in modo nativo nello stesso passaggio; altri restituiscono clip mute. Segnalato nel pannello.
CostoAl secondo di output, da 15 crediti/secondo a 480p, mostrato per intero prima di generare.
Generazioni falliteNon addebitato — i crediti restano sul tuo saldo.

Come usare il generatore da testo a video

Scrivi la scena, scegli il motore, genera.

  1. 1

    Scrivi la scena

    Descrivi soggetto, azione, ambientazione e movimento di macchina. I modelli da testo a video rispondono al linguaggio delle inquadrature — «lenta carrellata in avanti», «camera a mano», «campo lungo» — molto più dei modelli di immagine.

  2. 2

    Scegli modello, durata e risoluzione

    Ogni motore da testo a video ha i suoi punti di forza su movimento e audio. Il costo è al secondo ed è mostrato prima di generare.

  3. 3

    Genera e prosegui

    Scarica il clip, estendilo o portalo in ulteriore editing. Prompt e impostazioni restano allegati nella cronologia.

Come scrivere un prompt da testo a video

I modelli da testo a video leggono descrizioni di inquadrature, non riassunti di scena. Quattro componenti, in quest'ordine.

1

Soggetto

Chi o cosa è nell'inquadratura, con un dettaglio distintivo.

uno chef con la giacca bianca macchiata

2

Azione

Un'azione, descritta mentre si svolge.

impiatta una portata, la pinzetta posa l'ultima erbetta

3

Camera

Posizione e movimento. Dillo anche quando la risposta è «nessun movimento».

inquadratura dall'alto a camera fissa

4

Look

Luce, colore e resa.

luce dura da cucina, alto contrasto, documentaristico

Vago

una donna che cammina sotto la pioggia

Specifico

una donna con un cappotto lungo cammina verso la camera sotto la pioggia serale, ombrello inclinato all'indietro, luci dei negozi sfocate dietro di lei, lento carrello indietro all'altezza degli occhi, poca profondità di campo, blu freddo con luce calda dalle finestre

Perché funziona

La versione breve indica un soggetto e una condizione meteo e nient'altro — camera, direzione, luce e obiettivo restano al modello. La versione lunga fissa ognuno di questi elementi, ed è per questo che produce due volte la stessa inquadratura.

Vago

video di prodotto per un flacone di skincare

Specifico

una boccetta di siero in vetro satinato ruota lentamente su una superficie di pietra bagnata, camera fissa all'altezza del prodotto, una sola luce principale morbida da destra, gocce d'acqua che catturano i riflessi, macro, look commerciale pulito

Perché funziona

Il video di prodotto fallisce sull'inquadratura e sulla luce molto più spesso che sull'oggetto. Bloccare la camera, nominare una luce e scegliere il macro dà al modello le tre decisioni che altrimenti tirerebbe a indovinare.

Abitudini da abbandonare

  • Chiedere troppa azione. Ogni movimento in più è un'altra occasione per il modello di deformare un volto o una mano. Un'azione chiara per clip regge molto meglio di tre.
  • Lasciare la camera non specificata. Se non dici come si comporta la camera, sceglie il modello — e di solito sceglie la deriva. «Camera fissa» è un'istruzione valida e utile.
  • Puntare subito alla durata massima. La deriva si accumula nel tempo. Genera prima una ripresa breve che ti convince, poi estendila, invece di chiedere 30 secondi al primo tentativo.

Oltre il testo a video

Il video guidato dal prompt è una strada. Le immagini di riferimento, gli avatar e l'editing sono le altre.

Risorse utili sull'IA da testo a video

Da testo a video: prezzi e crediti giornalieri gratuiti

La modalità da testo a video si paga al secondo di output. Gli account gratuiti ricevono 80 crediti al giorno; i piani a pagamento aprono i motori premium e le durate più lunghe.

Gratis

$0

Perfetto per iniziare

  • 200 crediti di benvenuto, fino a 80/giorno
  • Z Image Turbo crea bozze a 0 crediti
  • Velocità di generazione standard
  • Cronologia delle generazioni inclusa
Inizia

Premium

Più popolare
$29/month

Fatturazione annuale · 240 $/anno

  • 8.000 crediti/mese, nessun limite giornaliero
  • Tutti i modelli premium — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • Velocità di generazione 5x, coda prioritaria
  • Ottimizzazione dei prompt con IA
Passa a Premium

Ultimate

$49/month

Fatturazione annuale · 380 $/anno

  • 18.000 crediti/mese, nessun limite giornaliero
  • Generazione HD fino alla risoluzione 4K
  • Supporto prioritario
  • Coda più rapida e accesso anticipato ai nuovi modelli
Passa a Ultimate

Da testo a video — domande frequenti

1

Come funziona il text-to-video?

Descrivi la scena — soggetto, movimento, atmosfera, cinepresa — e un modello video IA genera una clip da zero, incluso l'audio nativo. Non serve alcun filmato sorgente.

2

Quale modello dovrei usare?

Seedance 2.0 Fast per l'iterazione conveniente, Seedance 2.0 per storie a più riprese, Veo 3.1 Fast per la rifinitura cinematografica a scena singola, Seedance 1.5 Pro quando ti serve un controllo esatto su 1080p/durata.

3

Quanto possono essere lunghi i video?

Circa da 4 a 15 secondi per generazione a seconda del modello, con estensione della scena disponibile su Seedance 2.0 per proseguire le sequenze.

4

Le clip includono l'audio?

Sì — Seedance e Veo generano dialogo, ambiente sonoro ed effetti in modo nativo. L'audio può essere disattivato su Seedance per una tariffa al secondo inferiore.

5

Quanto costa?

Al secondo, variabile in base a modello, risoluzione e audio — sempre mostrato prima di generare, con rimborsi automatici in caso di errori.

6

Come si scrive un buon prompt per i video?

Indica il soggetto, l'azione, l'ambientazione, l'atmosfera e il movimento di camera. L'ottimizzatore di prompt integrato espande automaticamente le idee brevi in brief video ben strutturati.

7

Posso creare video verticali per TikTok e Reels?

Sì — scegli il 9:16 per ogni generazione per le piattaforme verticali, oppure il 16:9 per YouTube e il web.

8

Come scrivo un buon prompt da testo a video?

Separa il soggetto, l'azione e la camera. «Uno chef che impiatta» è un soggetto; «lenta avanzata su uno chef che impiatta, profondità di campo ridotta, luce calda da cucina» è un'inquadratura. I modelli da testo a video seguono la seconda in modo molto più affidabile.

9

Il testo a video può generare dialoghi e audio?

Sui motori che supportano l'audio nativo sì, parlato sincronizzato compreso. Gli altri producono clip muti. Quale sia quale è indicato nel pannello dei modelli prima che tu spenda crediti.

10

Perché il mio clip da testo a video si allontana dal prompt?

Le durate più lunghe derivano di più, perché il modello ha più fotogrammi da riempire e meno ancoraggi. I clip brevi seguono il prompt in modo più stretto; se ti serve durata, genera una ripresa breve che ti convince ed estendila, invece di chiedere subito 30 secondi.

Scrivi un paragrafo — presenta in anteprima una clip

Inizia a generare video

Scopri i nostri strumenti IA per video in un clic

Strumenti in un clic per tutto ciò che circonda la generazione: rifinire, cambiare stile, condividere.