الصورة الناطقة بالذكاء الاصطناعي

ارفع صورة شخصية ومقطعًا صوتيًا (حتى 35s)، أو اكتب نصًا واختر صوتًا، وسيحوّل OmniHuman 1.5 الصورة إلى فيديو متحدث بشفاه متزامنة وحركة طبيعية. استخدم صورتك الخاصة لتظهر فيه بنفسك.

0 / 2,000
130 cr/s · ≤35s

من صورة واحدة إلى فيديو ناطق

صورة شخصية واحدة مع نص تتحول إلى متحدث واقعي — مزامنة الشفاه والتعبيرات والإيماءات. بلا كاميرا ولا استوديو.

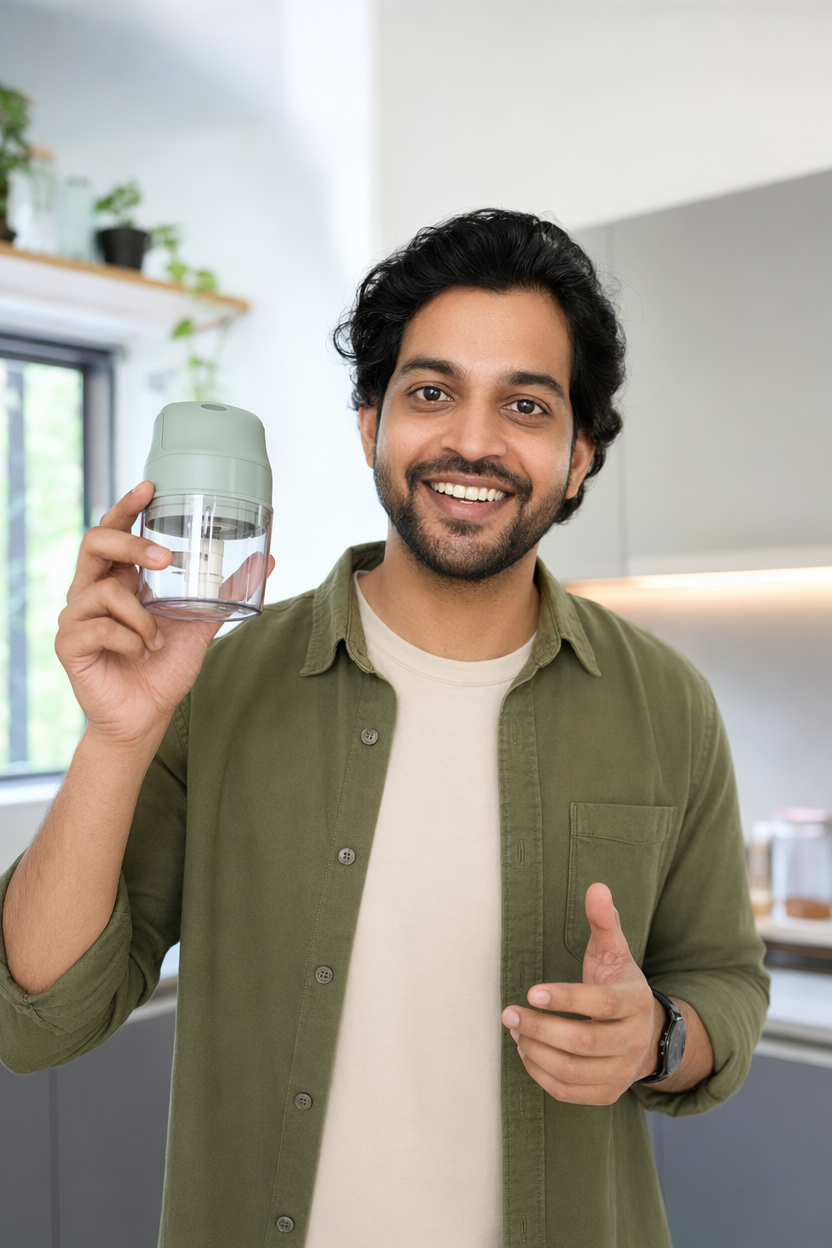
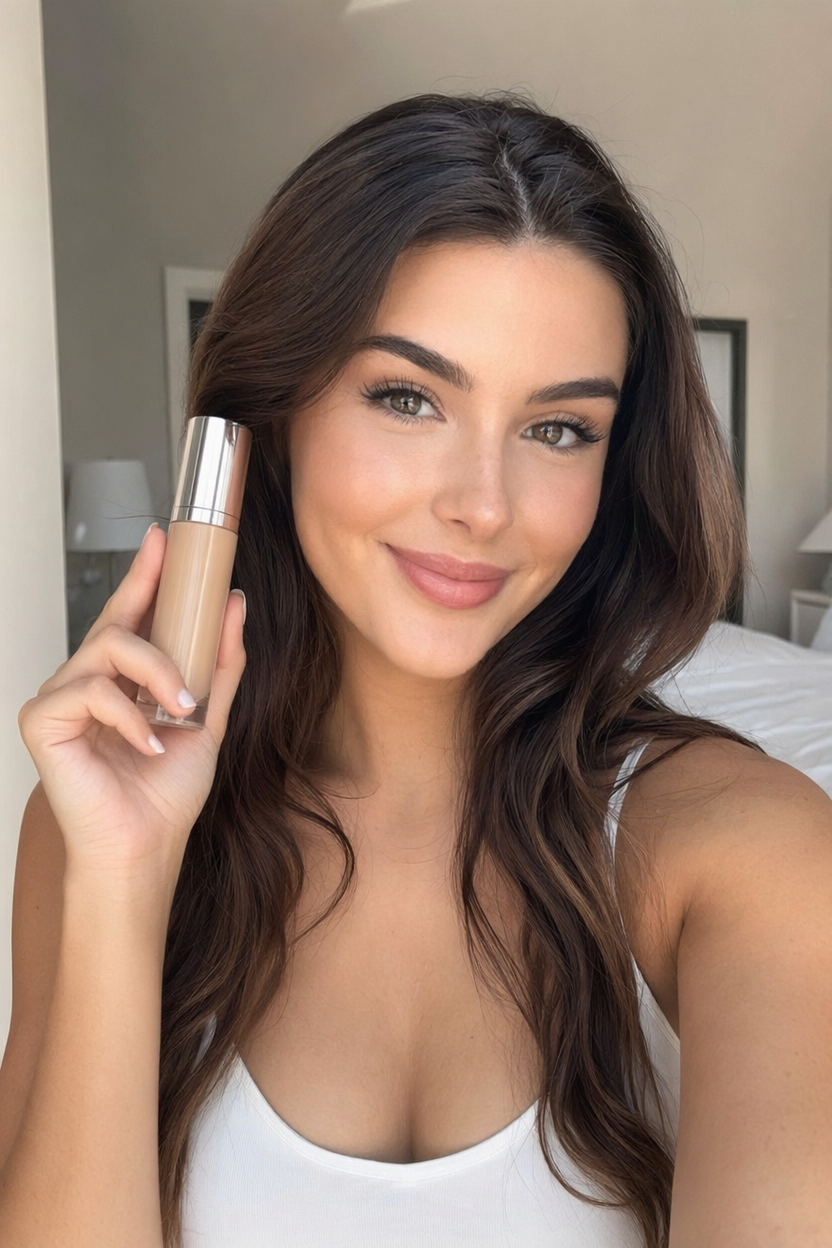
الصورة الأصليةOriginal portrait photo of a beauty creator holding a skincare product
النص

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

فيديو الأفاتار بالذكاء الاصطناعي

اجعل أي صورة تتكلم، بما في ذلك صورتك

مولّد كامل للصور الناطقة بالذكاء الاصطناعي (إنسان رقمي): ارفع صورة شخصية ومقطعًا صوتيًا، أو اكتب نصًا واختر صوتًا، واحصل على فيديو ناطق واقعي بشفاه متزامنة وتعابير طبيعية وإيماءات. استخدم صورة لنفسك لتكون المقدّم. يعمل بـ ByteDance OmniHuman 1.5، دون حاجة إلى كاميرا أو ممثل أو استوديو.

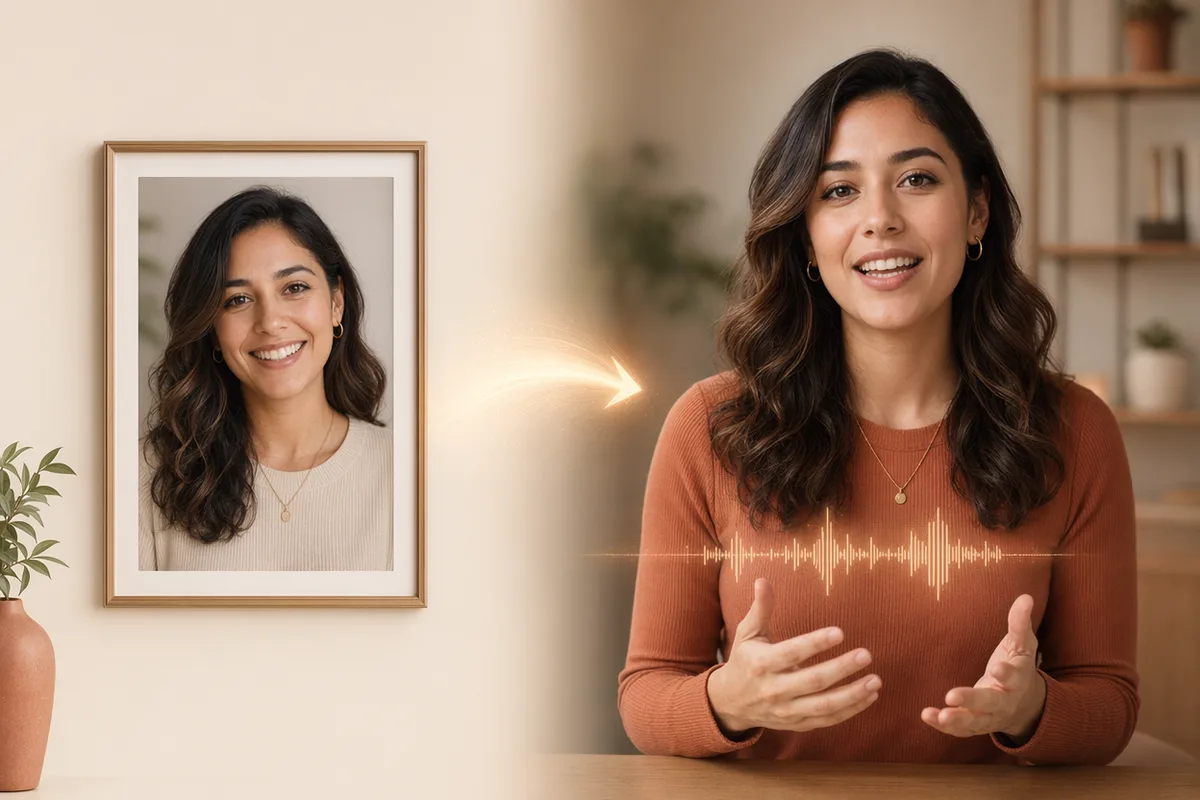
صورة شخصية مؤطرة تتحول إلى صورة رمزية ناطقة بالذكاء الاصطناعي للمرأة نفسها، مع موجة صوتية بينهما

كن أنت نجمها بنفسك، أو ابنِ متحدثًا رقميًا

لا تصوير، لا ممثل، لا شاشة خضراء. ارفع صورة واضحة واحدة لنفسك وستصبح المقدّم الذي يقرأ نصك، بصوتك أنت أو بصوت من المكتبة. أو استخدم صورة لشخص منحك إذنه وابنِ مضيفًا رقميًا قابلًا لإعادة الاستخدام لشروحات المنتجات ومقدمات الدورات والإعلانات والإعلانات التجارية. أعد توليد أسطر جديدة في أي وقت دون إعادة تصوير.
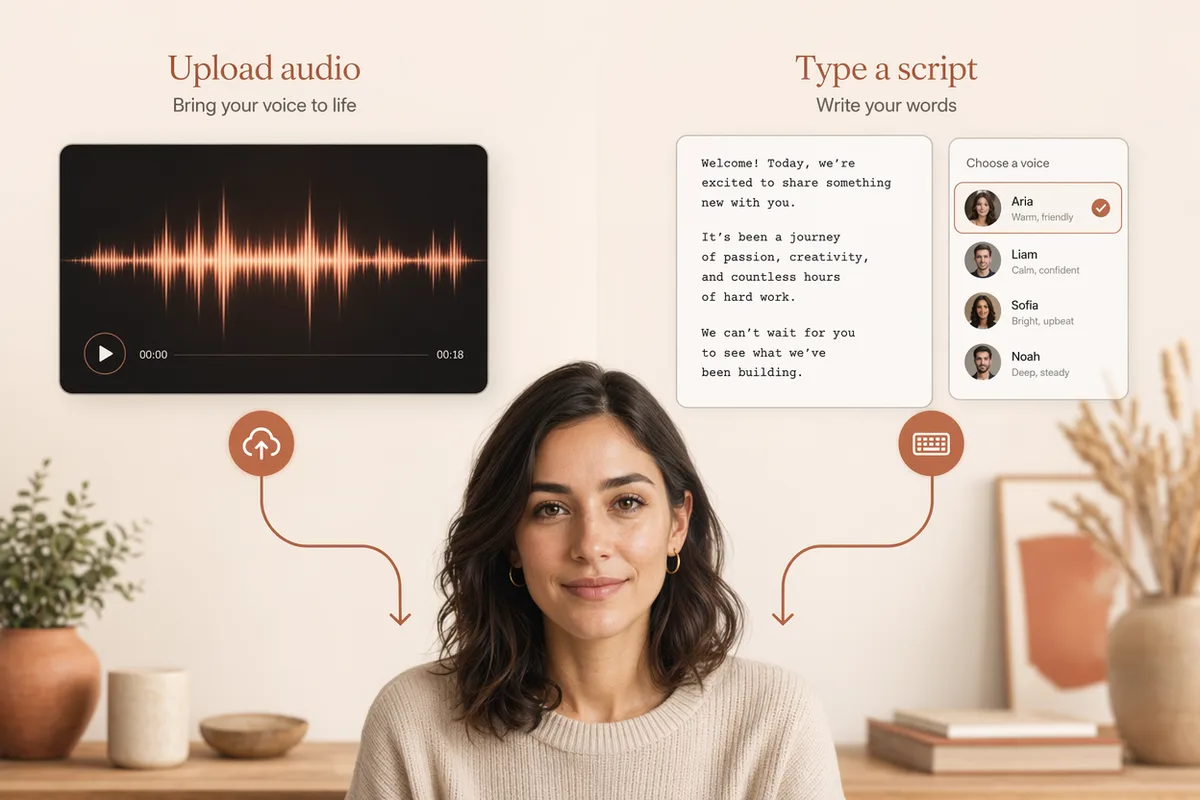
مدخلان لصورة ناطقة بالذكاء الاصطناعي: موجة صوتية مرفوعة ونص مكتوب مع منتقي أصوات

هناك طريقتان للدخول: تحميل ملف صوتي أو كتابة نص مكتوب

هل لديك تسجيل صوتي؟ حمّله وسيقوم الأفاتار بمزامنة حركة الشفاه معه. ليس لديك صوت؟ انتقل إلى وضع النص - اكتب ما يجب أن يقوله الأفاتار، واختر صوتًا من مكتبة تحويل النص إلى كلام المدمجة، وسيتم تحويل النص إلى صوت القيادة تلقائيًا. يتم عرض المدة التقريبية وتكلفة الرصيد قبل البدء.

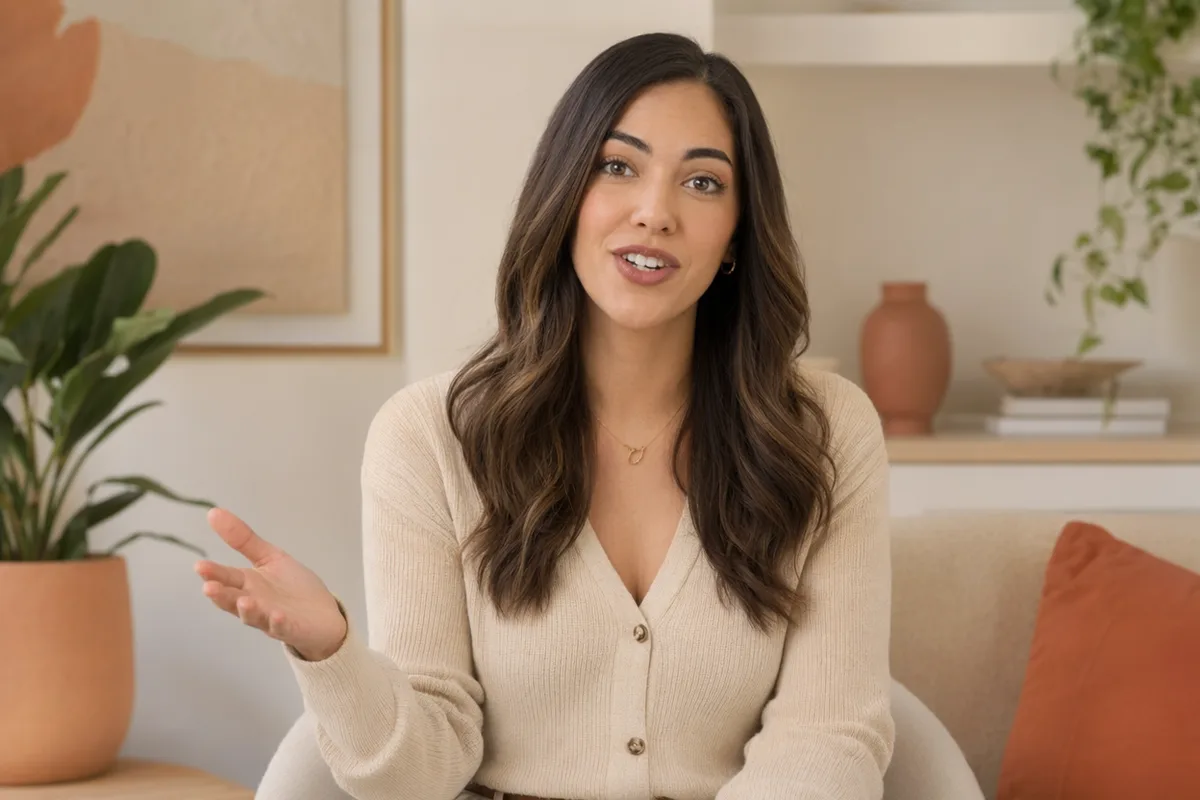
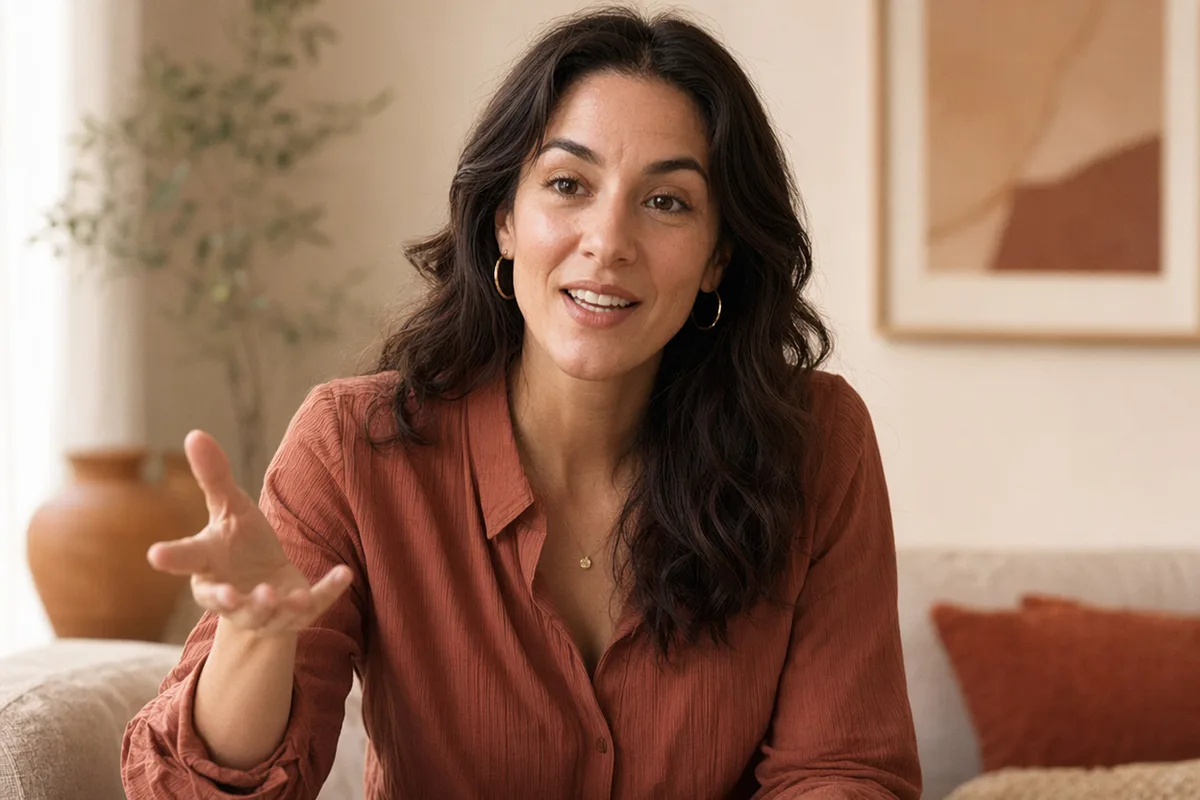
لقطة ثابتة لصورة ناطقة بالذكاء الاصطناعي لامرأة تتحدث إلى الكاميرا بإيماءات يد طبيعية

نابض بالحياة - ليس مجرد فم متحرك

يقرأ برنامج OmniHuman 1.5 إيقاع الصوت ونبرته ومعناه لتحريك الرأس والوضعية وإيماءات اليد بدقة متناهية، مع الحفاظ على هوية الشخص والإضاءة. والنتيجة هي أداء يُحاكي مقدماً حقيقياً بدلاً من صورة ثابتة بفم متحرك.

مقدّم صورة ناطقة بالذكاء الاصطناعي في غرفة معيشة يقدّم مقطعًا اجتماعيًا قصيرًا

مصمم لأغراض التسويق والتدريب والتواصل الاجتماعي

أنشئ مقاطع فيديو للمتحدثين الرسميين للإعلانات وصفحات الهبوط، ودروسًا تعليمية مصحوبة بشرح صوتي، ومنشورات تعريفية لوسائل التواصل الاجتماعي، أو نسخًا متعددة اللغات من الرسالة نفسها. يتم حفظ كل جيل في سجل البيانات مع مدخلاته، مما يتيح لك التعديل وإنتاج نسخ مختلفة بسرعة.

صور شخصية جاهزة لميزة الصورة الناطقة بالذكاء الاصطناعي

صور شخصية بأسلوب المقدّمين أُنتجت على CreateVision AI — أي واحدة منها تستطيع تشغيل فيديو أفاتار متحدث بمجرد إضافة الصوت.

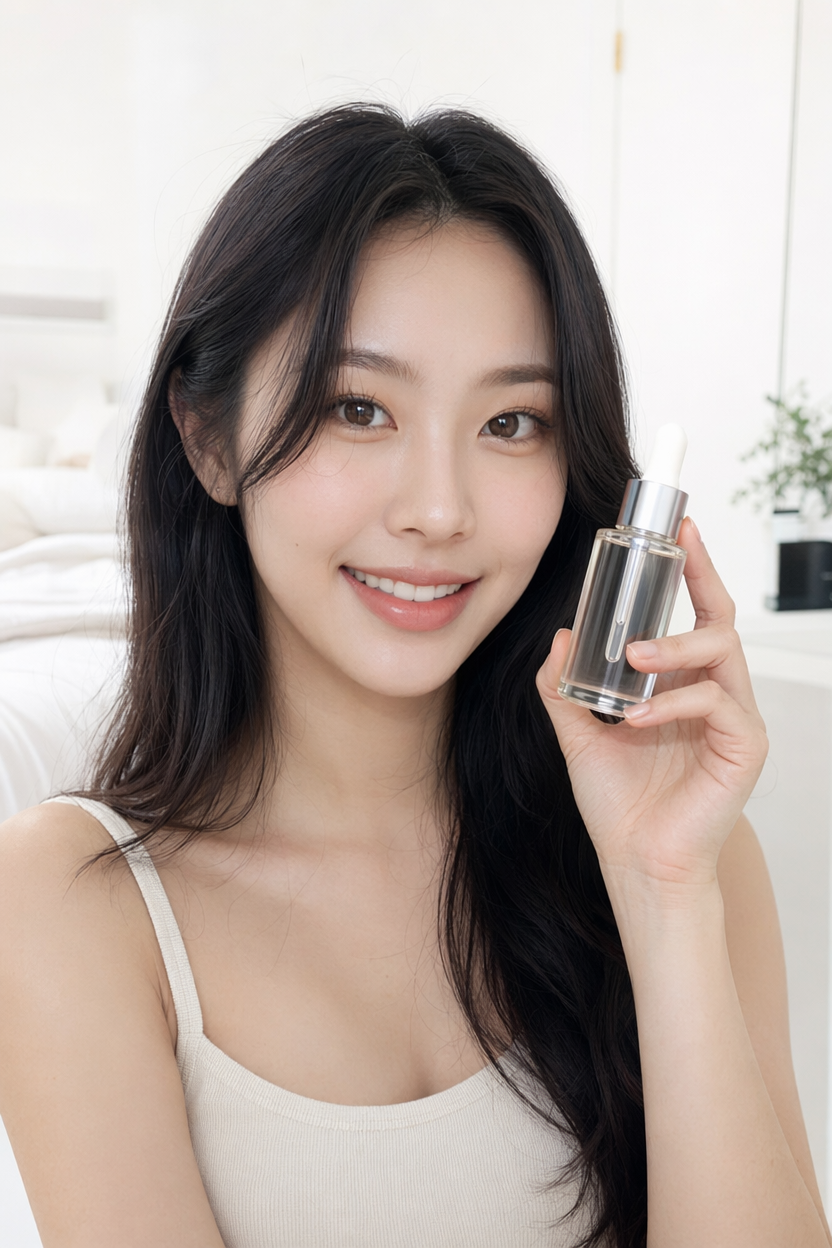
صورة رمزية للذكاء الاصطناعي لخبيرة تجميل تعرض سيروم للعناية بالبشرة
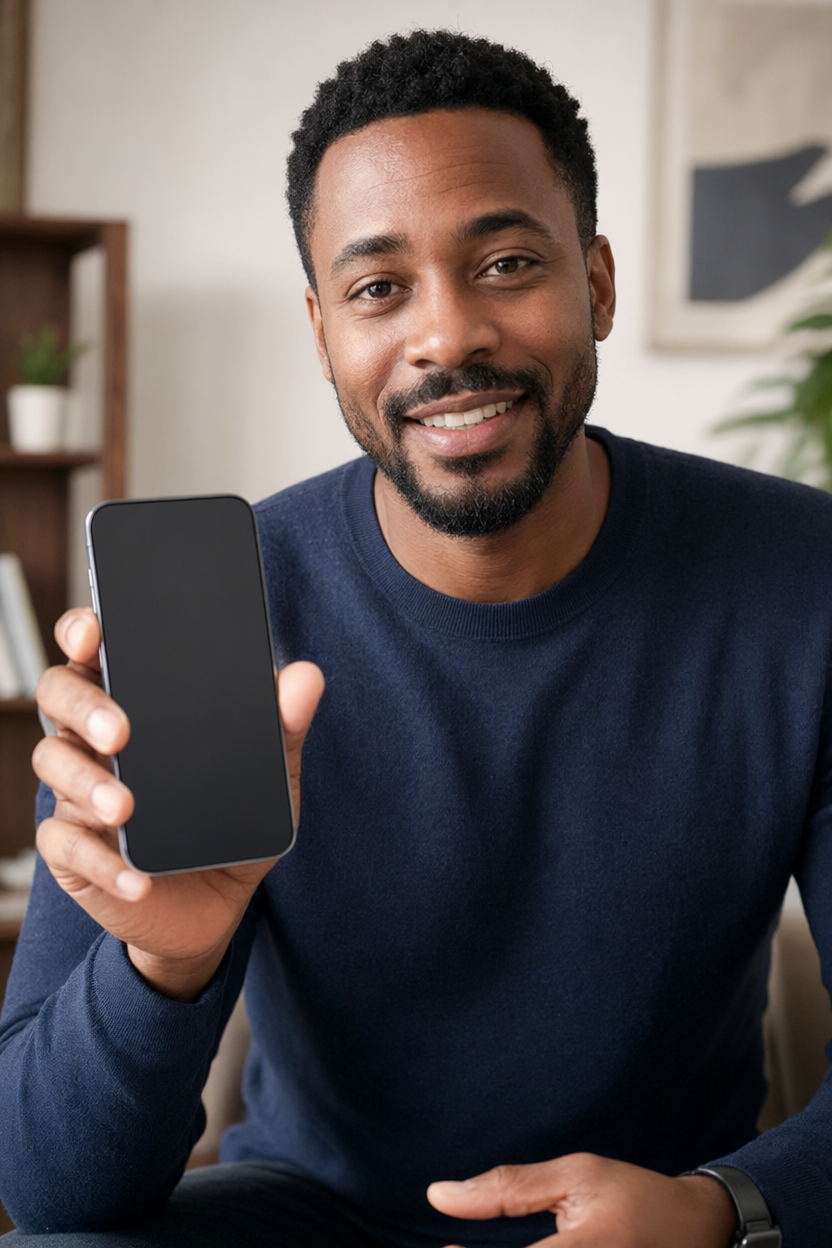
صورة رمزية للذكاء الاصطناعي لمراجع تقني يعرض هاتفًا ذكيًا
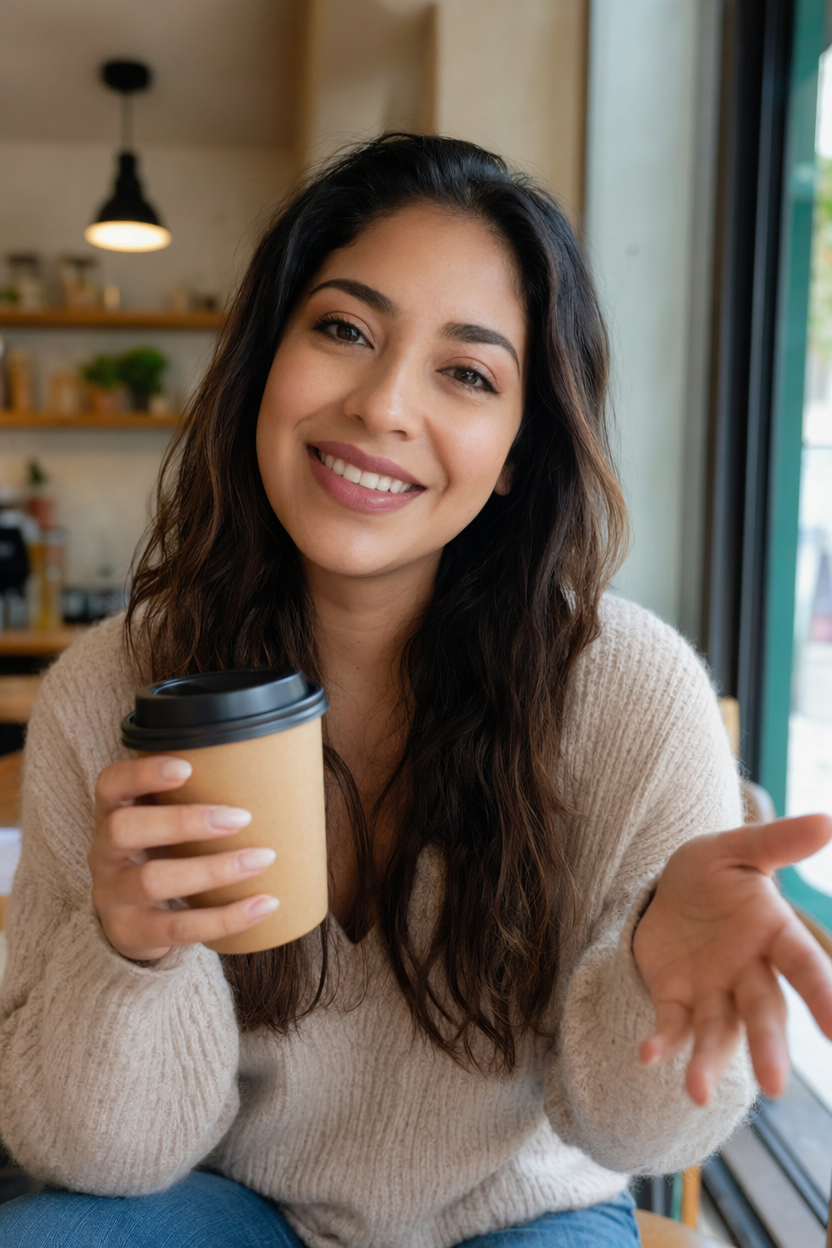
صورة رمزية للذكاء الاصطناعي لمنشئ أسلوب حياة يحمل فنجان قهوة
صورة رمزية للذكاء الاصطناعي لمراجع أحذية رياضية يعرض حذاءً
صورة رمزية للذكاء الاصطناعي لمصممة أزياء تحمل حقيبة يد
صورة رمزية تعمل بالذكاء الاصطناعي لمبتكر منتجات صحية يعرض المكملات الغذائية
صورة رمزية للذكاء الاصطناعي لصانعة مستحضرات تجميل تحمل زجاجة عطر
صورة رمزية للذكاء الاصطناعي لمبتكر وصفات الطبخ المنزلي مع أداة مطبخ

النموذج الذي يشغّل مولّد الصور الناطقة بالذكاء الاصطناعي هذا

يتولّى OmniHuman 1.5 مزامنة الشفاه وتعبيرات الوجه وحركة الجسد في هذه الصفحة.

مواصفات الصورة الناطقة بالذكاء الاصطناعي

المُدخلصورة شخصية واحدة، إضافة إلى ملف صوتي مرفوع أو نص مكتوب.
صورة منصورتك أنت، أو صورة شخص منحك إذنه. يجب أن تكون الصورة والصوت لك لتستخدمهما.
إرشادات الصورة الشخصيةصورة أمامية، جيدة الإضاءة، والوجه كامل وظاهر وواضح. النظارات الشمسية والظلال الثقيلة تقلّل دقة مزامنة الشفاه.
مدة الصوتحتى 35 ثانية لكل توليد — أي نحو 85 كلمة منطوقة.
مكتبة الأصوات60 صوتًا مدمجًا بعشر لغات، مع إمكانية الاستماع قبل التوليد.
النموذجOmniHuman 1.5، وهو الذي يقود مزامنة الشفاه وتعبيرات الوجه وحركة الرأس والجسد الطبيعية.
التكلفةتُحتسب التكلفة عن كل ثانية من الناتج كما في توليد الفيديو الآخر؛ وتظهر قبل التوليد.
المُخرَجمقطع قابل للتنزيل، يُحفظ في سجلك مرفقًا بالصورة الشخصية المصدر والنص.

كيف تكون نجم صورتك الناطقة بالذكاء الاصطناعي

صورتك، كلماتك، مقطع واحد.

  1. 1

    ارفع صورة لنفسك

    تعمل الصورة الواضحة المواجهة للأمام بشكل أفضل: سيلفي هاتف، أو صورة رأس، أو إطار من فيديو. يقرأ نظام الصور الناطقة بالذكاء الاصطناعي وجهك من هذا الإطار الواحد.

  2. 2

    أضف صوتك

    سجّل نفسك وارفع الصوت، أو اكتب نصك واختر واحدًا من 60 صوتًا مدمجًا. يمكن أن يصل طول الصوت إلى 35 ثانية.

  3. 3

    ولّد، ثم أعد استخدام نسختك

    يزامن النموذج الشفاه والتعبير وحركة الرأس الطبيعية مع الصوت. احتفظ بالصورة نفسها وولّد أسطرًا جديدة كلما احتجت إليها، دون إعادة تصوير.

كيف تكتب نصًا لصورة ناطقة بالذكاء الاصطناعي

لا يوجد هنا موجِّه للصورة — فالصورة الشخصية والصوت هما من يقوم بالعمل. أما ما تكتبه فهو النص، وخيارات النص هي التي تقرّر إن كانت النتيجة ستبدو طبيعية.

1

الجملة الافتتاحية

ابدأ بشيء قصير. الثانية الأولى هي أوضح موضع تظهر فيه مزامنة الشفاه.

أهلًا — كلمة سريعة.

2

طول الجملة

أبقِ الجمل دون 15 كلمة تقريبًا. الجمل الطويلة تنتج وقفات غير طبيعية.

هذا السيروم يحتوي على مكوّنين. هذه هي التركيبة كاملة.

3

علامات الترقيم

الفواصل والنقاط تتحوّل إلى أنفاس. ضعها حيث تتوقف فعلًا عند الكلام.

إنه ينجح — ولا يستغرق سوى عشر ثوانٍ.

4

ميزانية الطول

نحو 2.5 كلمة في الثانية. اكتب بما يناسب طول المقطع الذي تريده.

نحو 85 كلمة لمقطع مدته 35 ثانية

غامض

يستخدم منتجنا الثوري أحدث التقنيات لتقديم نتائج لا تُضاهى لعملاء مميّزين يبحثون عن التميّز.

محدّد

هذا هو الجزء الذي يسأل عنه الناس دائمًا. مكوّنان، بلا حشو. وسترى الفرق خلال أسبوع تقريبًا.

لماذا ينجح هذا

الأولى جملة واحدة من 19 كلمة كلها تجريد — يؤدّيها الأفاتار بنبرة مسطّحة متّصلة بلا نفَس، لأنه لا يجد موضعًا للوقوف. والثانية ثلاث جمل قصيرة بمواضع نبر طبيعية، وهذا ما يجعل الأداء يبدو بشريًا.

غامض

مرحبًا وأهلًا بكم في قناتنا حيث سنناقش اليوم أهم خمسة أشياء تحتاجون إلى معرفتها عن روتينات العناية بالبشرة.

محدّد

خمسة أشياء عن العناية بالبشرة. أوّلها هو ما يخطئ فيه الناس.

لماذا ينجح هذا

الافتتاحيات الطويلة المتّصلة هي أكثر ما تنحرف عنده مزامنة الشفاه، لأن النموذج لا يجد علامات ترقيم يتّكئ عليها. أما الافتتاحية القصيرة فتمنحه مواضع نبر واضحة وتمسك الانتباه بشكل أفضل.

عادات يُستحسن التخلّي عنها

  • استخدام صورة شخصية يكون فيها الوجه صغيرًا أو مائلًا أو نصفه في الظل. فدقة مزامنة الشفاه ترتبط مباشرة بمدى وضوح الفم في اللقطة المصدر.
  • الكتابة بما يتجاوز حد الصوت. التوليد يتوقّف عند 35 ثانية من الصوت — والنص الأطول يُقصّ، فقسّمه إلى مقاطع وأعد استخدام الصورة الشخصية نفسها.
  • الصياغة التقنية المكثّفة. الأرقام والاختصارات وأسماء المنتجات الطويلة هي المواضع التي يبدو فيها الأداء الاصطناعي اصطناعيًا بأوضح صورة. اكتبها كما تنطقها بصوت عالٍ.

أبعد من مولّد فيديو الأفاتار بالذكاء الاصطناعي

الأفاتارات الناطقة مخرج واحد فقط. فتوليد الصور والفيديو يعمل من الحساب نفسه.

مصادر مفيدة عن فيديو الأفاتار بالذكاء الاصطناعي

أسعار الصور الناطقة بالذكاء الاصطناعي والرصيد المجاني

تُحتسب فيديوهات الصور الناطقة بالثانية مثل مخرجات الفيديو الأخرى. تحصل الحسابات الجديدة على 200 رصيد مجاني لتجربتها.

مجاني

$0

مثالي للبدء

  • 200 رصيد ترحيبي، بحد أقصى 80 يوميًا
  • مسوّدات Z Image Turbo بـ 0 رصيد
  • سرعة توليد قياسية
  • سجل التوليد مُضمّن
ابدأ

Premium

الأكثر شيوعًا
$29/month

يُحاسَب سنويًا · $240/year

  • 8,000 رصيد/شهر، بلا حدود يومية
  • جميع النماذج المتميزة — GPT Image 2 وNano Banana وSeedream وSeedance وVeo وKling
  • سرعة توليد 5 أضعاف، طابور أولوية
  • تحسين الموجِّهات بالذكاء الاصطناعي
الترقية إلى Premium

Ultimate

$59/month

يُحاسَب سنويًا · $468/سنة

  • 18,000 رصيد/شهر، بلا حدود يومية
  • توليد عالي الدقة حتى دقة 4K
  • دعم ذو أولوية
  • أسرع طابور ووصول مبكر للنماذج الجديدة
الترقية إلى Ultimate

الصورة الناطقة بالذكاء الاصطناعي — الأسئلة الشائعة

1

ما الصورة الناطقة بالذكاء الاصطناعي؟

الصورة الناطقة بالذكاء الاصطناعي، وتسمى أيضًا الصورة الرمزية بالذكاء الاصطناعي أو الإنسان الرقمي، هي فيديو ناطق مولّد لشخص مبني من صورة واحدة وصوت. بدلًا من التصوير، تقدّم صورة شخصية وصوتًا (أو نصًا + صوتًا)، ويحرّك النموذج أداءً كلاميًا واقعيًا — يُستخدم كمقدّم رقمي أو متحدث باسم أو راوٍ.

2

ما الذي أحتاجه لإنشاء واحد؟

صورة شخصية واضحة من الأمام، بالإضافة إلى مقطع صوتي (mp3/wav) أو - في وضع النص - النص الذي ترغب في نطقه مع اختيار صوت من المكتبة المدمجة. هذا يكفي لإنشاء فيديو أفاتار ناطق.

3

هل يمكنني استخدام صوتي؟

نعم. حمّل تسجيلك الصوتي الخاص، وسيقوم الأفاتار بمزامنة حركة الشفاه معه. إذا لم يكن لديك تسجيل، فانتقل إلى وضع النص واختر صوتًا من مكتبة تحويل النص إلى كلام.

4

ما هو الحد الأقصى لطول فيديو الصورة الرمزية؟

يُمكنك تسجيل ما يصل إلى 35 ثانية من الصوت لكل عملية إنشاء. بالنسبة للنصوص الأطول، قسّمها إلى مقاطع متعددة. يظهر لك الوقت المُقدّر أثناء الكتابة، ويتم احتساب التكلفة بالثانية.

5

ما هي استخدامات الصور الرمزية المدعومة بالذكاء الاصطناعي؟

تشمل الاستخدامات الشائعة شرح المنتجات والإعلانات، وسرد الدورات التدريبية والتعريفية، ومقاطع الفيديو التي تظهر فيها المتحدثة على وسائل التواصل الاجتماعي، والإعلانات، والنسخ متعددة اللغات من الرسالة - في أي مكان قد تحتاج فيه إلى تصوير مقدم العرض.

6

ما هو النموذج الذي يدعم الصورة الرمزية المدعومة بالذكاء الاصطناعي؟

تستخدم تقنية الذكاء الاصطناعي CreateVision برنامج OmniHuman 1.5 من ByteDance، الذي يتحكم في مزامنة حركة الشفاه وحركة الرأس والإيماءات بناءً على الصوت. راجع صفحة طراز OmniHuman 1.5 للاطلاع على التفاصيل التقنية.

7

ما الصورة الأنسب في مولّد فيديو الأفاتار بالذكاء الاصطناعي؟

صورة شخصية جيدة الإضاءة من الأمام، يظهر فيها الوجه كاملًا وواضحًا. النظارات الشمسية، والظل الكثيف على الوجه، والزوايا المتطرفة، أو الوجه الصغير جدًا داخل الإطار — كلها تقلّل دقة مزامنة الشفاه.

8

هل يلزمني تسجيل صوتي الخاص؟

لا. يمكنك كتابة النص واختيار صوت من المكتبة المدمجة التي تضم 60 صوتًا بـ 10 لغات. ورفع تسجيلك الخاص مدعوم أيضًا إن كنت تفضّل استخدامه.

9

هل يمكنني أن أكون نجم الفيديو بنفسي؟

نعم، وهذا الاستخدام الأكثر شيوعًا. ارفع صورة لنفسك، ثم إما سجّل صوتك أو اكتب نصًا واختر صوتًا من المكتبة. النتيجة هي أنت، تقول كلماتك، دون إعداد كاميرا. يحتفظ كثير من صنّاع المحتوى بصورة جيدة واحدة ويولّدون منها مقاطع جديدة كل أسبوع.

10

هل يمكنني استخدام الصورة الناطقة بالذكاء الاصطناعي تجاريًا؟

نعم. بموجب شروط خدمة CreateVision AI، يمكن استخدام المحتوى الذي تنشئه لأغراض شخصية وتجارية، مع الإشارة إلى CreateVision AI عند الاقتضاء. أنت مسؤول عن امتلاك حقوق الصورة والصوت اللذين ترفعهما، وعن أي قواعد للإفصاح عن الذكاء الاصطناعي على المنصة التي تنشر فيها.

11

كنت أظهر بنفسي في فيديوهات باستخدام Sora. هل هذا هو الشيء نفسه؟

الهدف نفسه، لكن الآلية مختلفة. هنا صورتك هي الهوية، والصوت أو النص الذي تقدمه هو الذي يقود الكلام، لذا يكون الناتج مقطعًا لوجه متحدث مع مزامنة الشفاه بدلًا من مشهد يتم إدخالك فيه. يعمل من أي صورة واحدة، ولا يحتاج إلى تسجيل بالفيديو، ولا يعتمد على بقاء تطبيق آخر متاحًا.

أنشئ أول صورة ناطقة لك بالذكاء الاصطناعي

ابدأ الإنشاء