AI-talkande foto

Ladda upp ett porträtt och ett ljudspår (upp till 35s), eller skriv ett manus och välj en röst, så förvandlar OmniHuman 1.5 fotot till en talande video med synkade läppar och naturlig rörelse. Använd ditt eget foto för att medverka själv.

0 / 2,000
130 cr/s · ≤35s

Från ett foto till en talande video

Ett enda porträtt plus ett manus blir en livfull talesperson – synkade läppar, uttryck och gester. Ingen kamera, ingen studio.

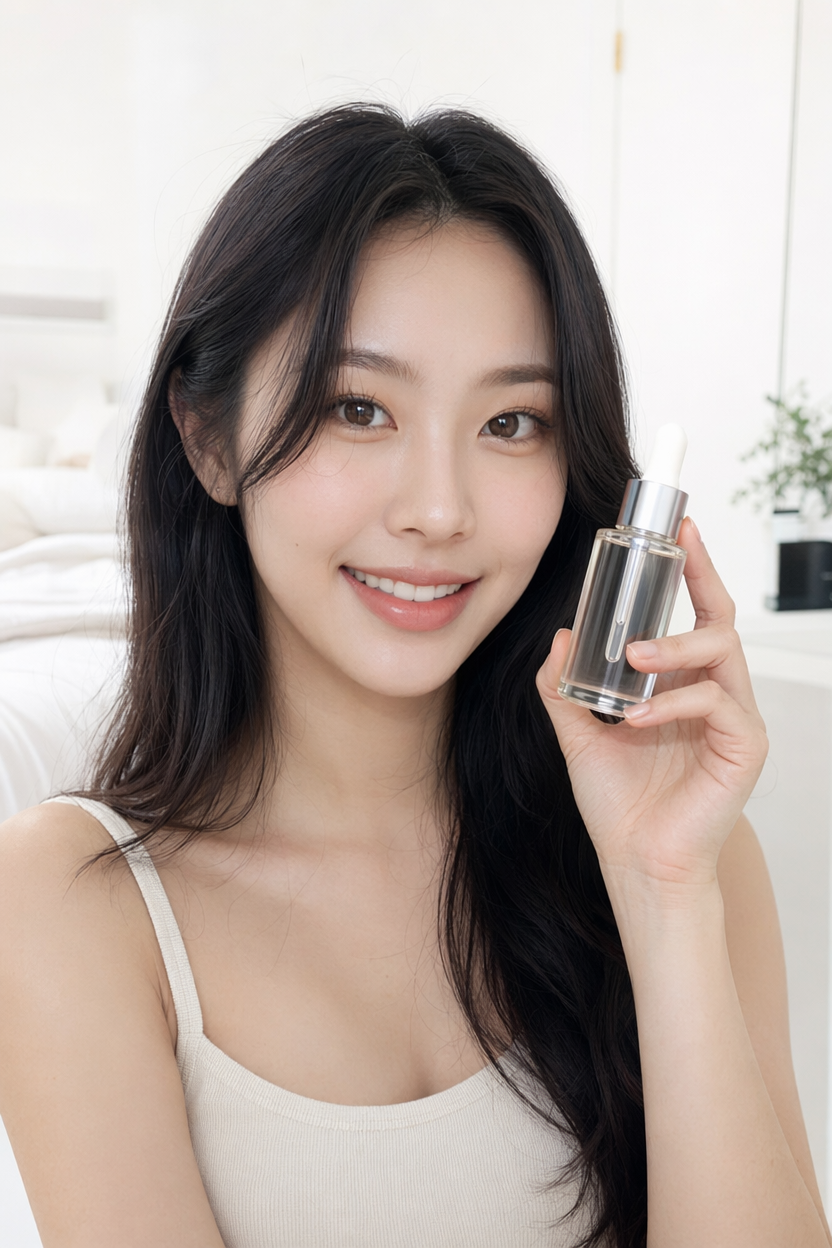
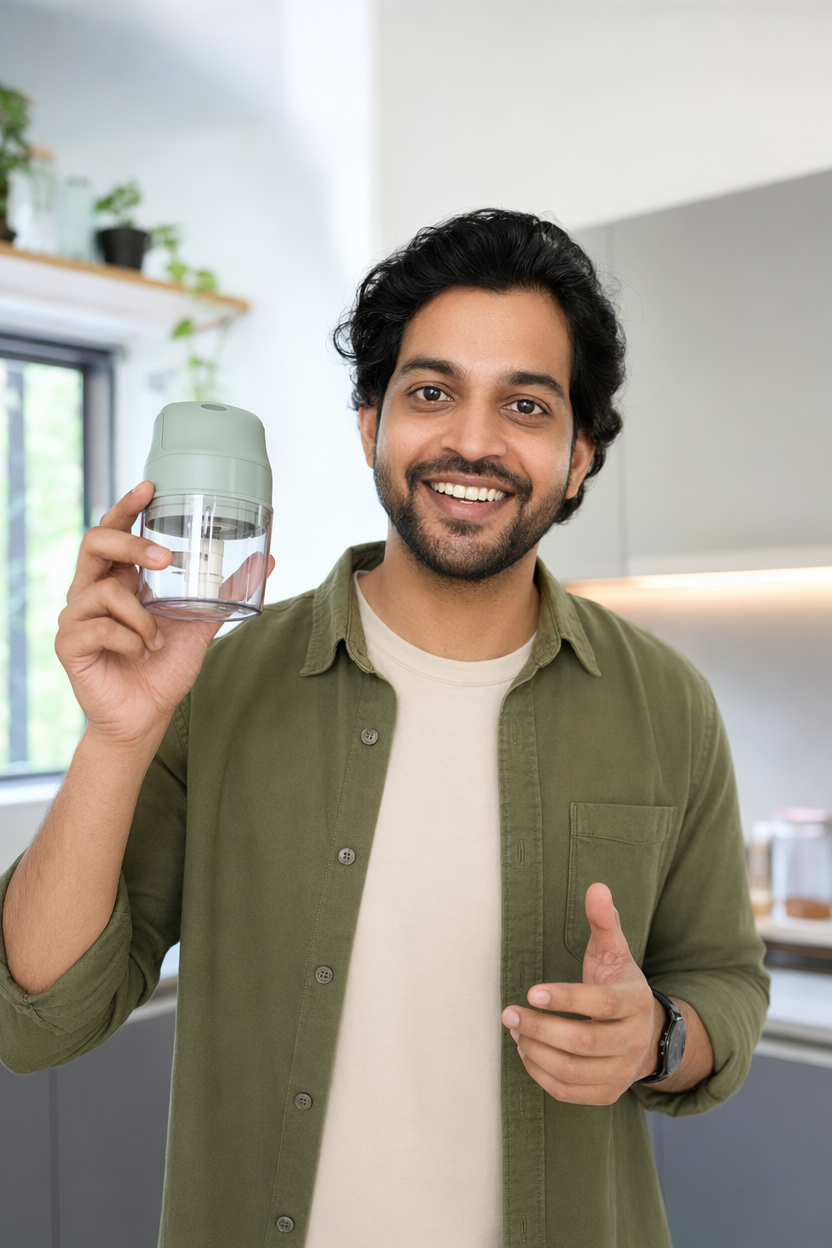
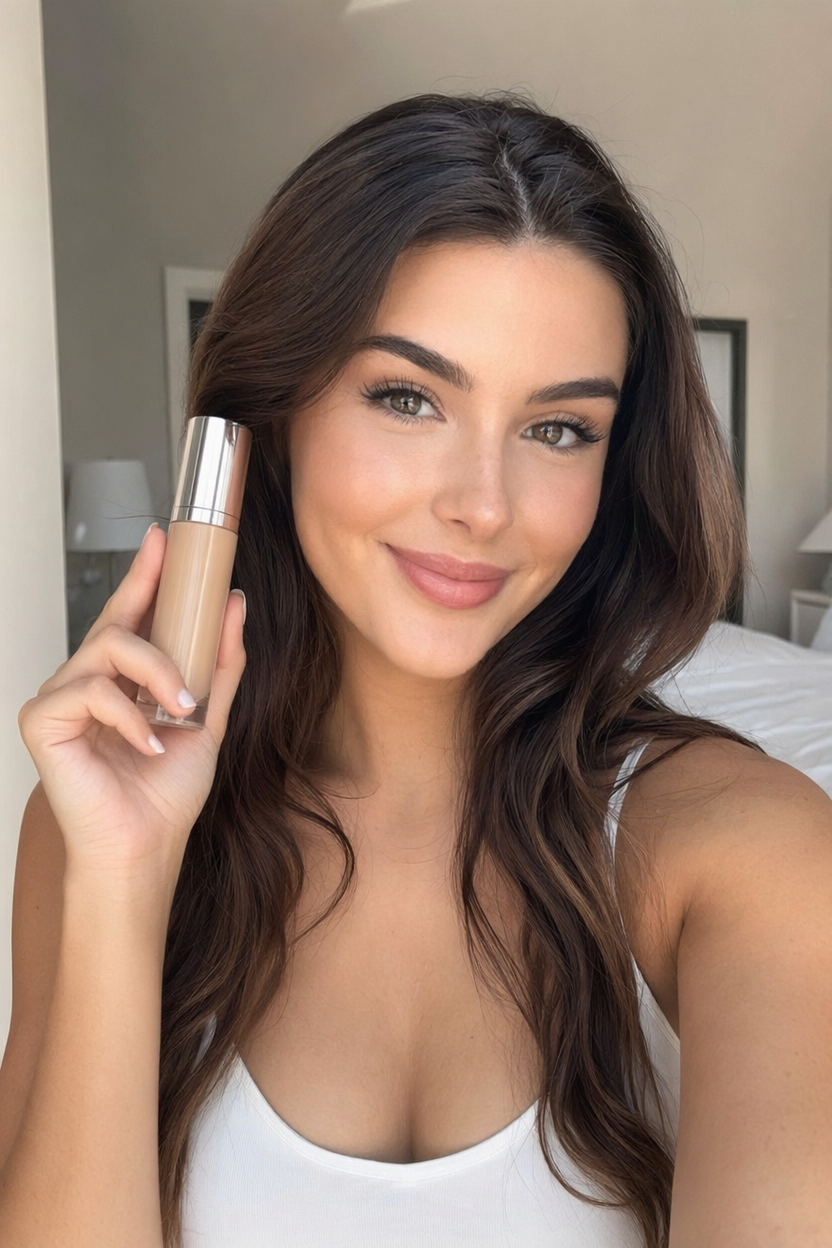
OriginalbildOriginal portrait photo of a beauty creator holding a skincare product
Manus

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

AI-avatarvideo

Få vilket foto som helst att tala, inklusive ditt eget

En komplett AI-generator för talande foton (digitala människor): ladda upp ett porträtt och ett ljudklipp, eller skriv ett manus och välj en röst, och få en verklighetstrogen talande video med synkade läppar, naturliga ansiktsuttryck och gester. Använd ett foto av dig själv för att vara presentatören. Drivs av ByteDance OmniHuman 1.5, ingen kamera, skådespelare eller studio krävs.

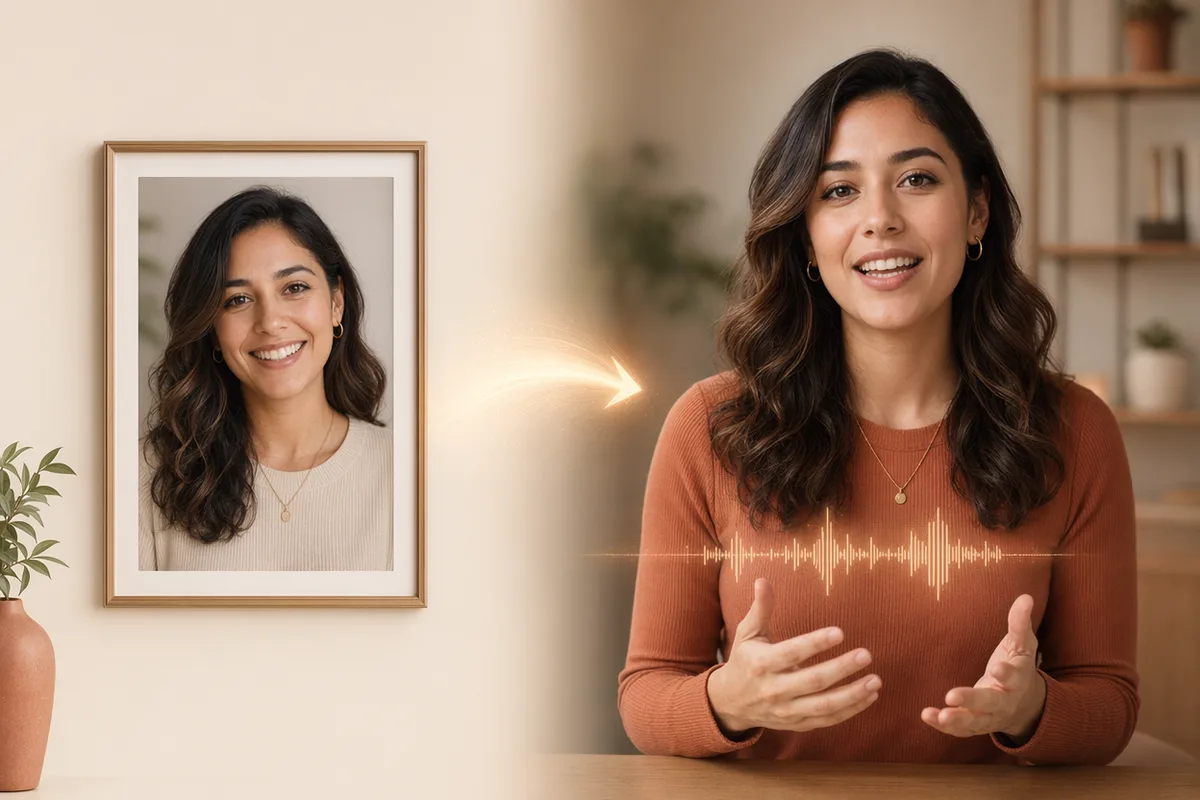
Ett inramat porträttfoto som förvandlas till en talande AI-avatar av samma kvinna, med en ljudvågform emellan dem

Medverka själv, eller bygg en digital talesperson

Ingen filmning, ingen skådespelare, ingen greenscreen. Ladda upp ett tydligt foto av dig själv så blir du presentatören som läser ditt manus, med din egen röst eller en biblioteksröst. Eller använd ett foto av en person som gett dig tillåtelse och bygg en återanvändbar digital programledare för produktförklaringar, kursintroduktioner, tillkännagivanden och annonser. Generera nya repliker när som helst utan att filma om.
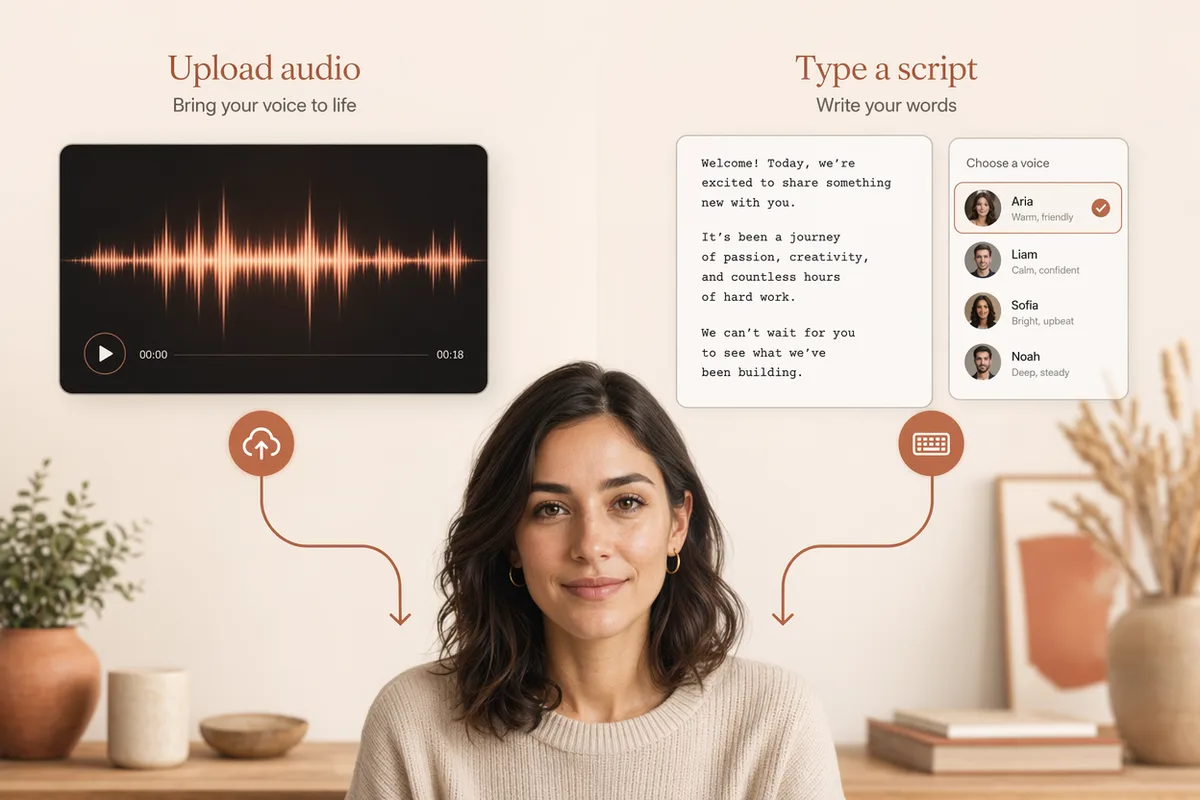
Två indata för ett AI-talande foto: en uppladdad ljudvågform och ett skrivet manus med en röstväljare

Två sätt att komma in: ladda upp ljud eller skriv ett manus

Har du redan en röstinspelning? Ladda upp den så synkroniseras avataren med den. Inget ljud? Växla till textläge – skriv vad avataren ska säga, välj en röst från det inbyggda text-till-tal-biblioteket så syntetiseras manuset till körljudet åt dig. Den uppskattade längden och kreditkostnaden visas innan du genererar.

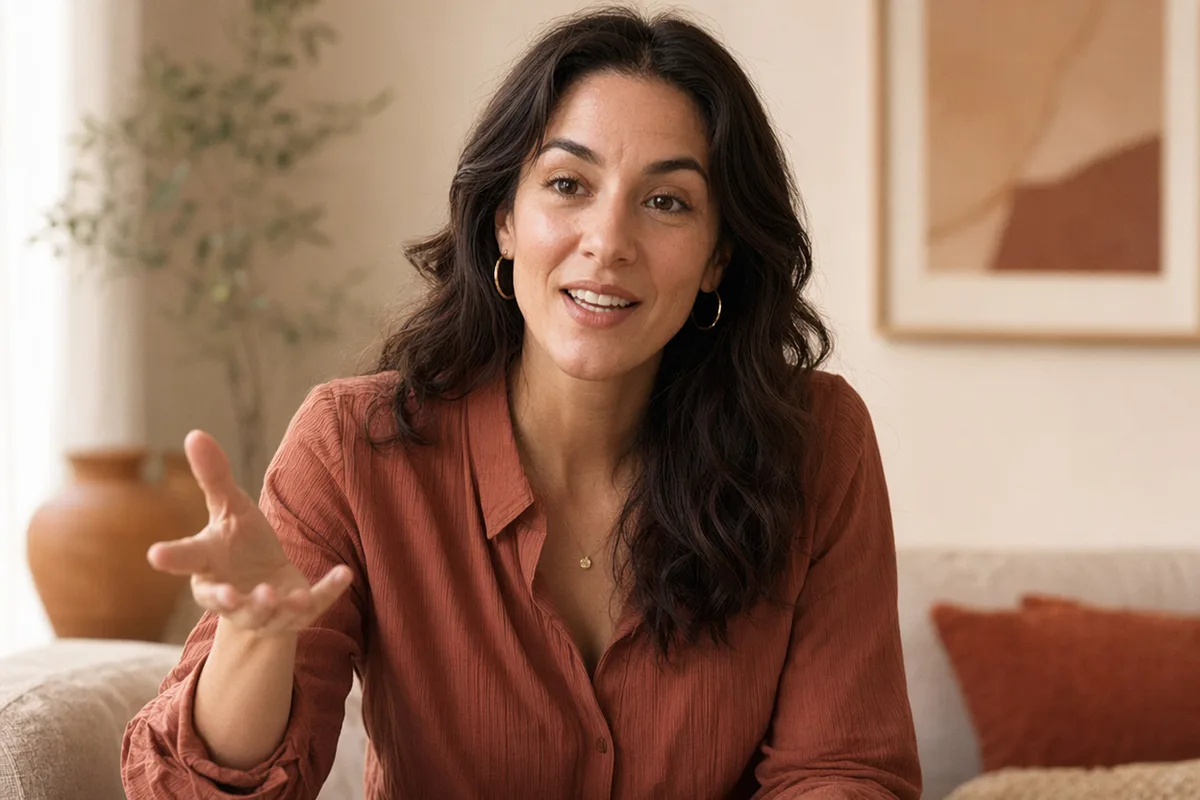
Stillbild från AI-talande foto av en kvinna som talar till kameran med naturliga handgester

Verklighetstrogen – inte bara en rörlig mun

OmniHuman 1.5 läser rytmen, prosodin och betydelsen av ljudet för att styra huvudrörelser, hållning och handgester tillsammans med korrekt läppsynkronisering, samtidigt som personens identitet och ljussättning bevaras. Resultatet fungerar som en riktig presentatör snarare än ett statiskt porträtt med en animerad mun.

AI-presentatör för talande foto i ett vardagsrum som levererar ett kort socialt klipp

Byggd för marknadsföring, utbildning och sociala medier

Skapa talespersonsklipp för annonser och landningssidor, berättade lektioner och onboarding för utbildningar, inlägg med talkheads för sociala medier eller flerspråkiga versioner av samma budskap. Varje generation sparas i historiken med sina indata, så att du kan iterera och producera variationer snabbt.

Porträtt redo för AI-talande foto

Porträtt i programledarstil genererade på CreateVision AI – vilket som helst av dem kan driva en talande avatarvideo när du lägger till ljud.

AI-avatar av en skönhetsskapare som presenterar ett hudvårdsserum
AI-avatar av en teknikrecensent som presenterar en smartphone
AI-avatar av en livsstilsskapare med en kaffekopp
AI-avatar av en sneakerrecensent som presenterar en sko
AI-avatar av en modeskapare med en handväska
AI-avatar för en wellness-skapare som presenterar kosttillskott
AI-avatar av en skönhetsskapare med en parfymflaska
AI-avatar av en hemlagningsskapare med en köksapparat

Modellen bakom den här AI-generatorn för talande foton

OmniHuman 1.5 driver läppsynken, mimiken och kroppsrörelserna på den här sidan.

Specifikationer för AI-talande foto

IndataEtt porträttfoto plus antingen en uppladdad ljudfil eller ett inskrivet manus.
Vems fotoDitt eget, eller en person som gett dig tillåtelse. Både fotot och rösten måste vara dina att använda.
Riktlinjer för porträttetRakt framifrån, väl belyst, hela ansiktet synligt och i fokus. Solglasögon och hårda skuggor sänker läppsynkens träffsäkerhet.
LjudlängdUpp till 35 sekunder per generering — ungefär 85 talade ord.
Röstbibliotek60 inbyggda röster på 10 språk, med förhandslyssning innan du genererar.
ModellOmniHuman 1.5, som driver läppsynk, ansiktsuttryck och naturlig huvud- och kroppsrörelse.
KostnadDebiteras per sekund output som annan videogenerering; visas innan du genererar.
UtdataEtt nedladdningsbart klipp, sparat i din historik tillsammans med källporträttet och manuset.

Så medverkar du i ditt eget AI-talande foto

Ditt foto, dina ord, ett klipp.

  1. 1

    Ladda upp ett foto av dig själv

    Ett tydligt foto taget framifrån fungerar bäst: en mobilselfie, en porträttbild eller en bildruta från en video. AI:n för talande foton läser av ditt ansikte från denna enda bildruta.

  2. 2

    Lägg till din röst

    Spela in dig själv och ladda upp ljudet, eller skriv ditt manus och välj en av 60 inbyggda röster. Ljudet kan vara upp till 35 sekunder långt.

  3. 3

    Generera, återanvänd sedan dig själv

    Modellen synkar läppar, ansiktsuttryck och naturliga huvudrörelser till ljudet. Behåll samma foto och generera nya repliker när du behöver dem, utan att filma om.

Så skriver du ett manus för ett AI-talande foto

Här finns ingen bildprompt — porträttet och ljudet gör jobbet. Det du skriver är manuset, och manusvalen avgör om resultatet ser naturligt ut.

1

Inledningsrad

Börja med något kort. Första sekunden är där läppsynken syns mest.

Hej — det här går fort.

2

Meningslängd

Håll meningarna under ungefär 15 ord. Långa bisatser ger onaturliga pauser.

Det här serumet har två ingredienser. Det är hela formeln.

3

Skiljetecken

Kommatecken och punkter blir andetag. Sätt dem där du faktiskt skulle pausa.

Det funkar — och tar tio sekunder.

4

Längdbudget

Ungefär 2,5 ord per sekund. Skriv mot den kliplängd du vill ha.

~85 ord för ett 35-sekundersklipp

Vagt

Vår revolutionerande produkt nyttjar spjutspetsteknologi för att leverera oöverträffade resultat till kräsna kunder som söker excellens.

Specifikt

Det här är den del alla frågar om. Två ingredienser, inga utfyllnader. Du ser skillnaden på ungefär en vecka.

Varför det fungerar

Den första är en enda mening på 19 ord av abstraktioner — avataren levererar den i en platt, andfådd monoton, eftersom det inte finns någonstans att pausa. Den andra är tre korta meningar med naturliga betoningspunkter, och det är det som får framförandet att låta mänskligt.

Vagt

Hej och välkommen till vår kanal, där vi i dag ska gå igenom de fem viktigaste sakerna du behöver veta om hudvårdsrutiner.

Specifikt

Fem saker om hudvård. Nummer ett är den nästan alla gör fel.

Varför det fungerar

Långa, oavbrutna inledningar är där läppsynken driver mest, eftersom modellen inte har någon skiljeteckning att förankra sig i. En kort hook ger den rena betoningspunkter och håller uppmärksamheten bättre.

Vanor värda att släppa

  • Att använda ett porträtt där ansiktet är litet, vinklat eller delvis i skugga. Läppsynkens träffsäkerhet följer direkt hur tydligt munnen syns i källbilden.
  • Att skriva förbi ljudgränsen. Genereringen stannar vid 35 sekunder ljud — ett längre manus kapas, så dela upp det i segment och återanvänd samma porträtt.
  • Tät teknisk formulering. Siffror, förkortningar och långa produktnamn är där syntetiskt tal låter som mest syntetiskt. Skriv dem som du skulle säga dem högt.

Bortom AI-avatarvideogeneratorn

Talande avatarer är ett av resultaten. Bild- och videogenerering körs från samma konto.

Användbara resurser om AI-avatarvideo

AI-talande foto: priser och gratis krediter

Videor med talande foton debiteras per sekund som annan videogenerering. Nya konton får 200 gratis credits för att prova.

Gratis

$0

Perfekt för att komma igång

  • 200 välkomstkrediter, upp till 80/dag
  • Z Image Turbo skissar för 0 credits
  • Standardhastighet för generering
  • Genereringshistorik ingår
Kom igång

Premium

Mest populär
$29/month

Faktureras årligen · 240 USD/år

  • 8 000 krediter/månad, inga dagliga gränser
  • Alla premiummodeller — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • 5x genereringshastighet, prioriterad kö
  • AI-promptförbättring
Uppgradera till Premium

Ultimate

$59/month

Faktureras årligen · 468 USD/år

  • 18 000 krediter/månad, inga dagliga gränser
  • HD-generering upp till 4K-upplösning
  • Prioriterad support
  • Snabbaste kön och tidig tillgång till nya modeller
Uppgradera till Ultimate

AI-talande foto — vanliga frågor

1

Vad är ett AI-talande foto?

Ett AI-talande foto, även kallat AI-avatar eller digital människa, är en genererad talande video av en person som byggs från ett enda foto och en röst. Istället för att filma tillhandahåller du ett porträtt och ljud (eller ett manus + röst), och modellen animerar ett verklighetstroget talat framträdande — som används som digital presentatör, talesperson eller berättare.

2

Vad behöver jag för att skapa en?

Ett tydligt porträttfoto framifrån, plus antingen ett ljudklipp (mp3/wav) eller – i textläge – det skript du vill ha uppläst och en röst vald från det inbyggda biblioteket. Det räcker för att generera en talande avatarvideo.

3

Kan jag använda min egen röst?

Ja. Ladda upp din egen ljudinspelning så synkroniseras avataren med den. Om du inte har en inspelning, växla till textläge och välj en röst från text-till-tal-biblioteket istället.

4

Hur lång kan avatarvideon vara?

Upp till 35 sekunder ljud per generation. För längre manus, dela upp dem i flera klipp. Den uppskattade längden visas medan du skriver, och du debiteras per sekund ljud.

5

Vad kan jag använda AI-avatarer till?

Vanliga användningsområden inkluderar produktförklaringar och annonser, berättarröst för kurser och introduktioner, klipp från sociala medier, meddelanden och flerspråkiga versioner av ett meddelande – överallt där du annars skulle behöva filma en presentatör.

6

Vilken modell driver AI-avataren?

CreateVision AI använder ByteDances OmniHuman 1.5, som driver läppsynkronisering plus huvudrörelser och gester från ljudet. Se modellsidan för OmniHuman 1.5 för tekniska detaljer.

7

Vilket foto fungerar bäst i en AI-avatarvideogenerator?

Ett välbelyst porträtt rakt framifrån där hela ansiktet syns och är i fokus. Solglasögon, hårda skuggor över ansiktet, extrema vinklar eller ett mycket litet ansikte i bild försämrar alla läppsynkens träffsäkerhet.

8

Måste jag spela in min egen röst?

Nej. Du kan skriva ett manus och välja en röst ur det inbyggda biblioteket, som rymmer 60 röster på 10 språk. Du kan också ladda upp en egen inspelning om du hellre vill det.

9

Kan jag medverka i videon själv?

Ja, och det är den vanligaste användningen. Ladda upp ett foto av dig själv, spela sedan antingen in din egen röst eller skriv ett manus och välj en biblioteksröst. Resultatet är du som säger dina ord, utan någon kamerauppställning. Många skapare behåller ett bra foto och genererar nya klipp från det varje vecka.

10

Kan jag använda ett AI-talande foto kommersiellt?

Ja. Enligt CreateVision AI:s användarvillkor får innehåll som du genererar användas för personliga och kommersiella ändamål, med källhänvisning till CreateVision AI där det är lämpligt. Du ansvarar för att ha rättigheterna till fotot och rösten du laddar upp, och för eventuella regler om AI-märkning på plattformen där du publicerar.

11

Jag brukade placera mig själv i videor med Sora. Är det här samma sak?

Samma mål, annan mekanik. Här är ditt foto identiteten och ditt ljud eller manus styr talet, så resultatet är ett talking-head-klipp med läppsynk snarare än en scen du släpps in i. Det fungerar från ett enda foto, kräver ingen videoregistrering och beror inte på att en annan app fortsätter finnas tillgänglig.

Skapa ditt första AI-talkande foto

Börja skapa