Mówiące zdjęcie AI

Prześlij portret i ścieżkę audio (do 35s) lub wpisz scenariusz i wybierz głos, a OmniHuman 1.5 zamieni zdjęcie w mówiące wideo z zsynchronizowanymi wargami i naturalnym ruchem. Użyj własnego zdjęcia, aby wystąpić w nim osobiście.

0 / 2,000
130 cr/s · ≤35s

Od jednego zdjęcia do mówiącego wideo

Jedno zdjęcie portretowe i scenariusz stają się realistycznym mówcą — zsynchronizowane usta, mimika i gesty. Bez kamery i studia.

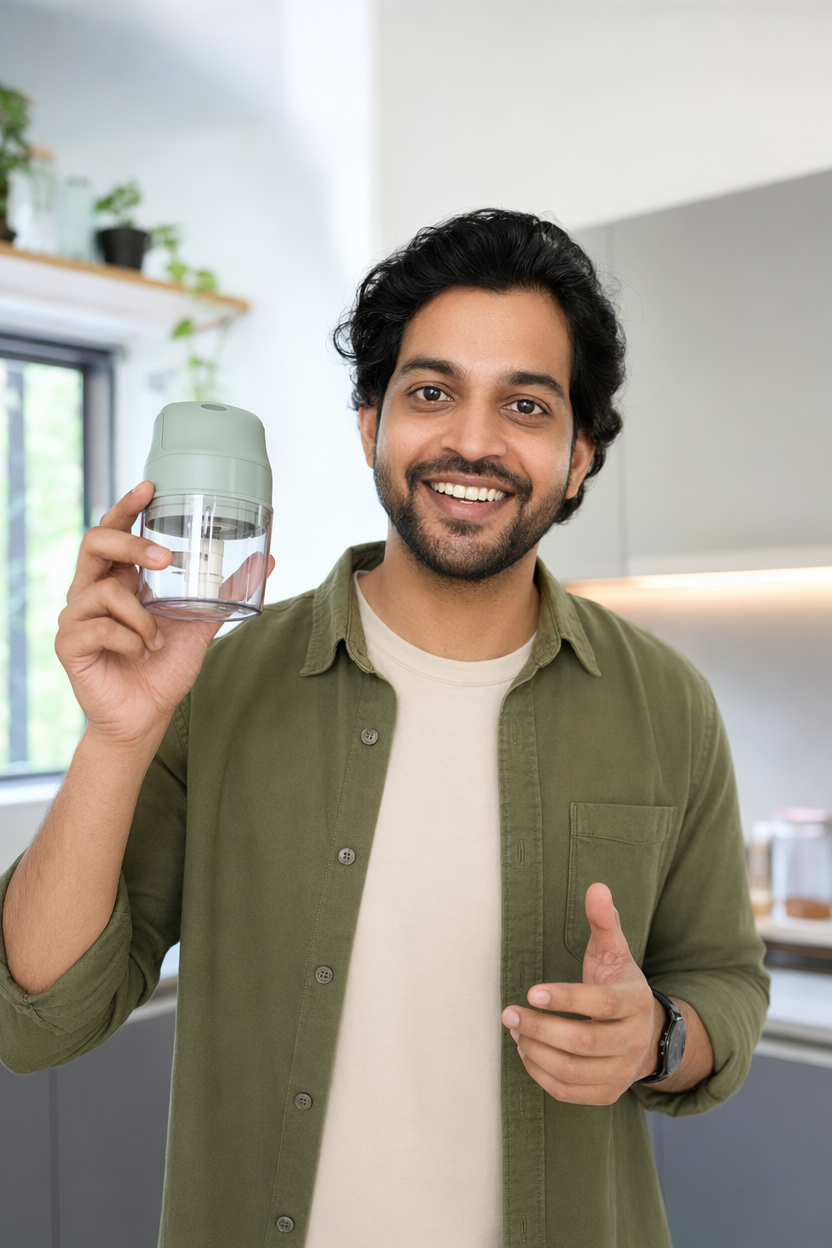
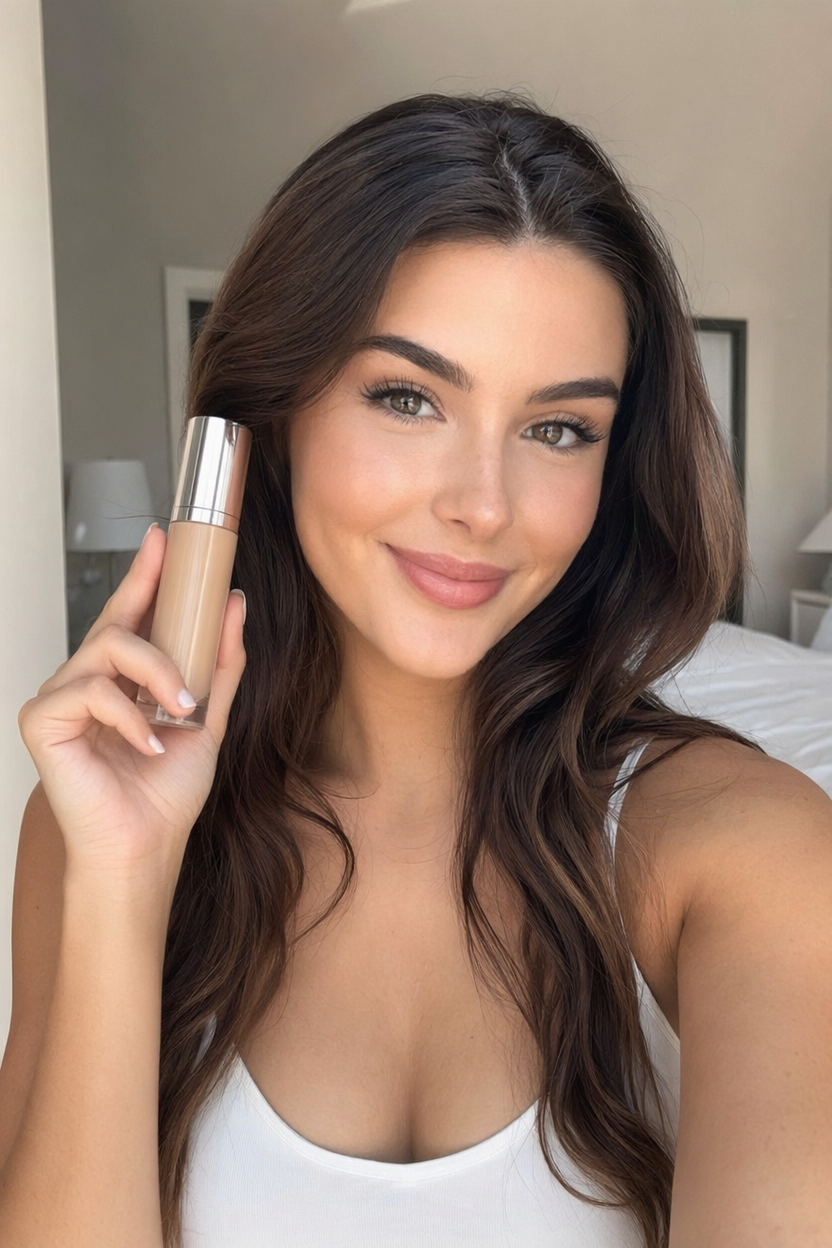
Oryginalny obrazOriginal portrait photo of a beauty creator holding a skincare product
Scenariusz

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

Wideo z awatarem AI

Spraw, że dowolne zdjęcie zacznie mówić, w tym twoje

Kompletny generator mówiących zdjęć AI (cyfrowy człowiek): prześlij portret i klip audio albo wpisz scenariusz i wybierz głos, a otrzymasz realistyczne mówiące wideo z zsynchronizowanymi ustami, naturalną mimiką i gestami. Użyj własnego zdjęcia, aby zostać prezenterem. Napędzany przez ByteDance OmniHuman 1.5 — bez kamery, aktora czy studia.

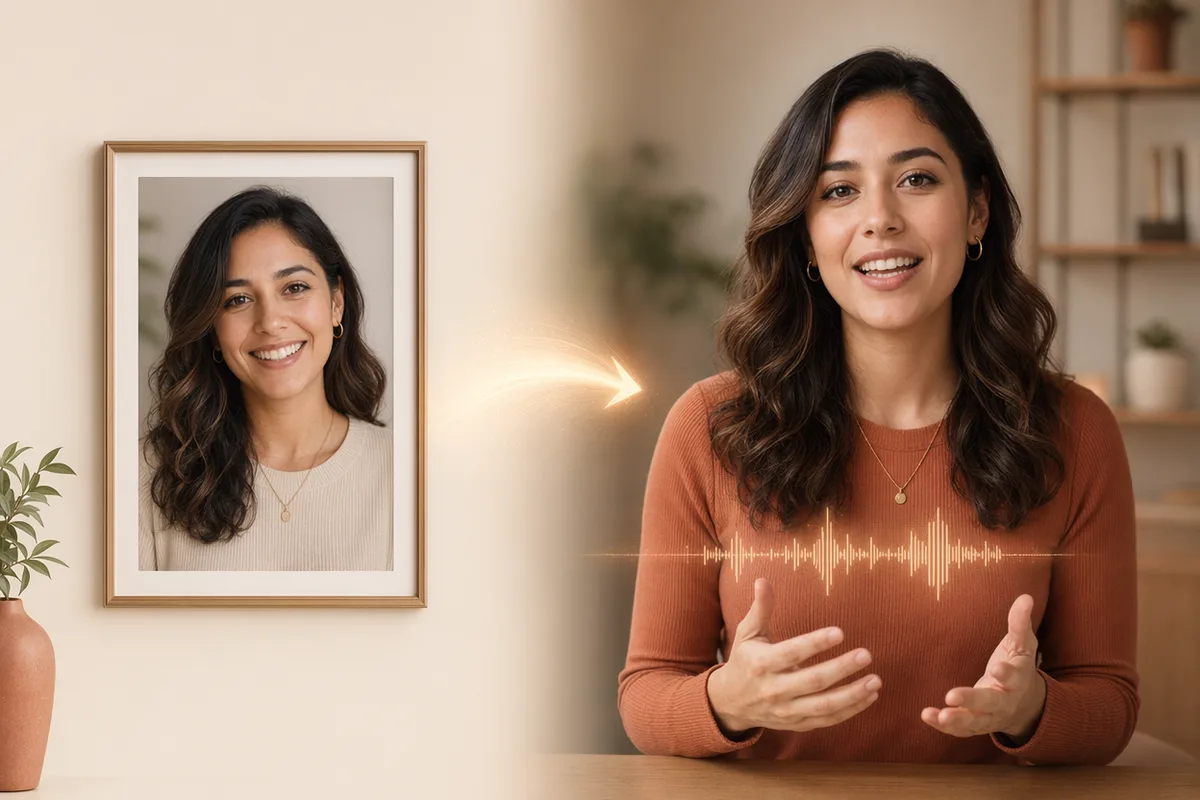
Oprawione zdjęcie portretowe zmieniające się w mówiący awatar AI tej samej kobiety, z falą dźwiękową między nimi

Wystąp w nim sam albo zbuduj cyfrowego rzecznika

Bez kręcenia, bez aktora, bez green screena. Prześlij jedno wyraźne zdjęcie siebie, a staniesz się prezenterem, który czyta twój scenariusz — własnym głosem albo głosem z biblioteki. Albo użyj zdjęcia osoby, która dała ci zgodę, i zbuduj wielokrotnego użytku cyfrowego prowadzącego do objaśnień produktu, wstępów do kursów, ogłoszeń i reklam. Regeneruj nowe kwestie kiedy chcesz, bez ponownego kręcenia.
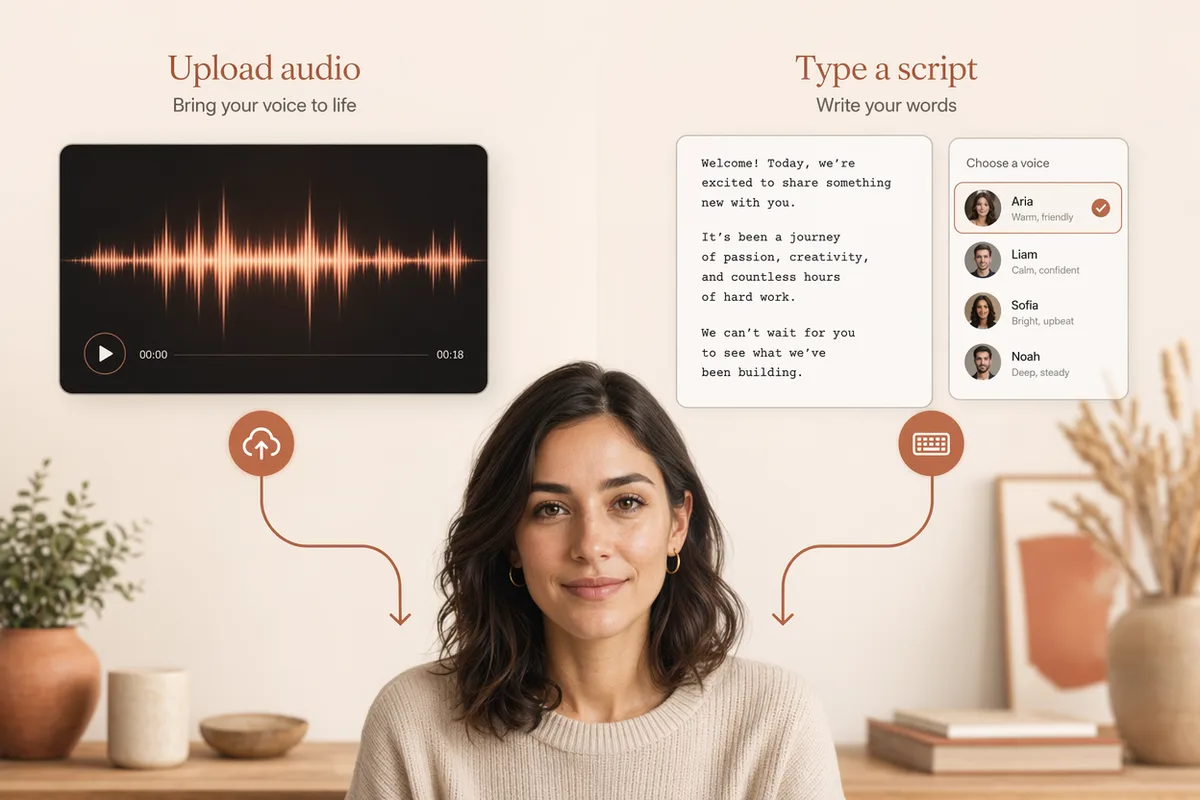
Dwa wejścia dla mówiącego zdjęcia AI: przesłana fala dźwiękowa i wpisany scenariusz z wyborem głosu

Dwa sposoby wejścia: wgraj dźwięk lub wpisz skrypt

Masz już nagranie głosowe? Prześlij je, a awatar zsynchronizuje się z nim. Brak dźwięku? Przełącz się na tryb tekstowy — wpisz, co awatar ma powiedzieć, wybierz głos z wbudowanej biblioteki syntezatorów mowy, a skrypt zostanie zsyntetyzowany i zamieniony na ścieżkę dźwiękową. Szacunkowa długość i koszt napisów są wyświetlane przed wygenerowaniem.

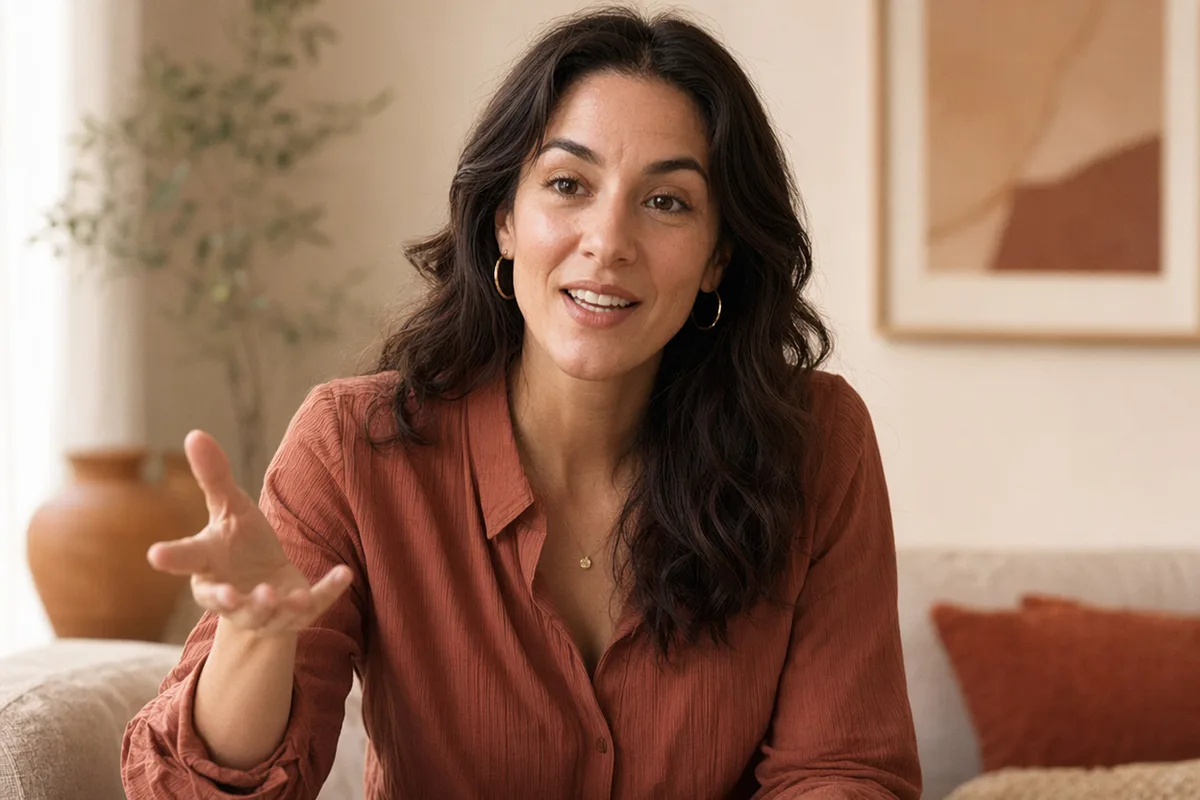
Kadr mówiącego zdjęcia AI: kobieta mówiąca do kamery z naturalnymi gestami rąk

Realistyczne – nie tylko ruchome usta

OmniHuman 1.5 odczytuje rytm, prozodię i znaczenie dźwięku, aby sterować ruchami głowy, postawą i gestami rąk, a także precyzyjnie odtwarzać ruchy ust, zachowując jednocześnie tożsamość i oświetlenie osoby. Rezultatem jest wrażenie prawdziwego prezentera, a nie statycznego portretu z animowanymi ustami.

Prezenter mówiącego zdjęcia AI w salonie, podający krótki klip do mediów społecznościowych

Stworzone do celów marketingowych, szkoleniowych i społecznościowych

Przygotuj klipy z wypowiedziami rzeczników prasowych do reklam i landing page'y, lekcje z narracją i materiały szkoleniowe, posty z wypowiedziami do mediów społecznościowych lub wielojęzyczne wersje tego samego przekazu. Każde pokolenie jest zapisywane w historii wraz ze swoimi wkładami, dzięki czemu możesz szybko iterować i tworzyć nowe wersje.

Portrety gotowe na mówiące zdjęcie AI

Portrety w stylu prezentera wygenerowane w CreateVision AI — każdy z nich może napędzić mówiące wideo z awatarem, gdy tylko dodasz dźwięk.

Awatar AI kreatora urody prezentujący serum do pielęgnacji skóry
Awatar AI recenzenta technologii prezentującego smartfon
Awatar AI twórcy stylu życia z filiżanką kawy
Awatar AI recenzenta butów sportowych prezentującego but
Awatar AI kreatora mody z torebką
Awatar AI twórcy wellness prezentującego suplementy
Awatar AI kreatora kosmetyków z butelką perfum
Awatar AI twórcy domowego gotowania z gadżetem kuchennym

Model napędzający ten generator mówiących zdjęć AI

Za synchronizację ust, mimikę i ruch ciała na tej stronie odpowiada OmniHuman 1.5.

Specyfikacje mówiącego zdjęcia AI

WejścieJedno zdjęcie portretowe plus przesłany plik audio albo wpisany scenariusz.
Czyje zdjęcieTwoje własne albo osoby, która dała ci zgodę. Zarówno zdjęcie, jak i głos musisz mieć prawo wykorzystać.
Wymagania wobec portretuNa wprost, dobrze doświetlone, cała twarz widoczna i ostra. Okulary przeciwsłoneczne i mocny cień obniżają dokładność synchronizacji ust.
Długość audioDo 35 sekund na generację — mniej więcej 85 wypowiedzianych słów.
Biblioteka głosów60 wbudowanych głosów w 10 językach, z odsłuchem przed generowaniem.
ModelOmniHuman 1.5, który odpowiada za synchronizację ust, mimikę oraz naturalny ruch głowy i ciała.
KosztNaliczane za sekundę materiału, jak przy pozostałym generowaniu wideo; kwota widoczna przed startem.
WynikKlip do pobrania, zapisany w twojej historii razem z portretem źródłowym i scenariuszem.

Jak wystąpić we własnym mówiącym zdjęciu AI

Twoje zdjęcie, twoje słowa, jeden klip.

  1. 1

    Prześlij swoje zdjęcie

    Najlepiej sprawdzi się wyraźne zdjęcie ustawione do przodu: selfie z telefonu, zdjęcie portretowe albo klatka z wideo. AI mówiącego zdjęcia odczytuje twoją twarz z tej jednej klatki.

  2. 2

    Dodaj swój głos

    Nagraj siebie i prześlij audio albo wpisz scenariusz i wybierz jeden z 60 wbudowanych głosów. Audio może trwać do 35 sekund.

  3. 3

    Generuj, a potem używaj siebie ponownie

    Model synchronizuje usta, mimikę i naturalne ruchy głowy z audio. Zachowaj to samo zdjęcie i generuj nowe kwestie, gdy tylko ich potrzebujesz — bez ponownego kręcenia.
Jak napisać scenariusz dla mówiącego zdjęcia AI

Nie ma tu promptu do obrazu — pracę wykonują portret i dźwięk. Ty piszesz scenariusz, a to decyzje scenariuszowe przesądzają, czy wynik wygląda naturalnie.

1

Pierwsze zdanie

Zacznij od czegoś krótkiego. Pierwsza sekunda to moment, w którym synchronizacja ust jest najbardziej widoczna.

Cześć — na szybko.

2

Długość zdania

Trzymaj zdania poniżej mniej więcej 15 słów. Długie zdania podrzędne dają nienaturalne pauzy.

To serum ma dwa składniki. To cała formuła.

3

Interpunkcja

Przecinki i kropki zamieniają się w oddechy. Stawiaj je tam, gdzie naprawdę zrobiłbyś pauzę.

Działa — i zajmuje dziesięć sekund.

4

Budżet długości

Mniej więcej 2,5 słowa na sekundę. Pisz pod długość klipu, jakiej chcesz.

~85 słów na 35-sekundowy klip

Ogólnie

Nasz rewolucyjny produkt wykorzystuje najnowocześniejszą technologię, aby dostarczać niezrównane rezultaty wymagającym klientom poszukującym doskonałości.

Konkretnie

O to zawsze pytacie. Dwa składniki, zero wypełniaczy. Różnicę zobaczysz mniej więcej po tygodniu.

Dlaczego to działa

Pierwszy to jedno 19-wyrazowe zdanie z samych abstrakcji — awatar wygłasza je płaskim monotonem na jednym oddechu, bo nie ma gdzie zrobić pauzy. Drugi to trzy krótkie zdania z naturalnymi akcentami, i to właśnie sprawia, że brzmi to po ludzku.

Ogólnie

Witajcie i zapraszamy na nasz kanał, na którym dziś będziemy omawiać pięć najważniejszych rzeczy, jakie musicie wiedzieć o rutynach pielęgnacji skóry.

Konkretnie

Pięć rzeczy o pielęgnacji skóry. Pierwszą większość robi źle.

Dlaczego to działa

To właśnie przy długich, rozwleczonych wstępach synchronizacja ust rozjeżdża się najbardziej, bo model nie ma się czego uchwycić — brakuje interpunkcji. Krótki haczyk daje mu czyste punkty akcentu i lepiej trzyma uwagę.

Nawyki warte porzucenia

  • Użycie portretu, na którym twarz jest mała, ustawiona bokiem albo częściowo w cieniu. Dokładność synchronizacji ust zależy wprost od tego, jak wyraźnie widać usta na zdjęciu źródłowym.
  • Pisanie ponad limit audio. Generowanie kończy się na 35 sekundach dźwięku — dłuższy scenariusz zostanie ucięty, więc podziel go na części i użyj tego samego portretu.
  • Gęsty język techniczny. To na liczbach, skrótowcach i długich nazwach produktów syntetyczna mowa brzmi najbardziej sztucznie. Zapisuj je tak, jak byś je wypowiedział na głos.

Więcej niż generator wideo z awatarem AI

Mówiące awatary to tylko jeden z efektów. Generowanie obrazów i wideo działa z tego samego konta.

Przydatne materiały o wideo z awatarem AI

Cennik mówiącego zdjęcia AI i darmowe kredyty

Wideo z mówiących zdjęć rozliczane są za sekundę jak inne wyniki wideo. Nowe konta dostają 200 darmowych kredytów, żeby to wypróbować.

Darmowy

$0

Idealny na początek

  • 200 kredytów powitalnych, do 80/dzień
  • Szkice w Z Image Turbo za 0 kredytów
  • Standardowa prędkość generowania
  • Historia generacji w zestawie
Zacznij

Premium

Najpopularniejszy
$29/month

Rozliczenie roczne · $240/rok

  • 8000 kredytów/mies., brak dziennych limitów
  • Wszystkie modele premium — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • 5x szybsze generowanie, priorytetowa kolejka
  • Ulepszanie promptów przez AI
Przejdź na Premium

Ultimate

$59/month

Rozliczenie roczne · $468/rok

  • 18 000 kredytów/mies., brak dziennych limitów
  • Generowanie w HD aż do rozdzielczości 4K
  • Priorytetowe wsparcie
  • Najszybsza kolejka i wcześniejszy dostęp do nowych modeli
Przejdź na Ultimate

Mówiące zdjęcie AI — często zadawane pytania

1

Czym jest mówiące zdjęcie AI?

Mówiące zdjęcie AI, nazywane też awatarem AI albo cyfrowym człowiekiem, to wygenerowane mówiące wideo osoby zbudowane z jednego zdjęcia i głosu. Zamiast kręcić, dostarczasz portret i audio (albo scenariusz + głos), a model animuje realistyczne wykonanie mowy — używane jako cyfrowy prezenter, rzecznik lub narrator.

2

Czego potrzebuję, aby go utworzyć?

Wyraźne, portretowe zdjęcie z przodu, a także klip audio (mp3/wav) lub – w trybie tekstowym – wyrecytowany skrypt i głos wybrany z wbudowanej biblioteki. To wystarczy, aby wygenerować wideo z mówiącym awatarem.

3

Czy mogę używać własnego głosu?

Tak. Prześlij własne nagranie audio, a awatar zsynchronizuje się z nim. Jeśli nie masz nagrania, przełącz się na tryb tekstowy i wybierz głos z biblioteki syntezatorów mowy.

4

Jak długi może być film awatara?

Do 35 sekund dźwięku na generację. W przypadku dłuższych skryptów podziel je na kilka klipów. Szacowany czas trwania jest wyświetlany podczas pisania, a opłata jest naliczana za każdą sekundę dźwięku.

5

Do czego mogę wykorzystać awatary AI?

Typowe zastosowania obejmują wyjaśnienia dotyczące produktów i reklamy, narrację kursów i szkoleń, klipy z udziałem ekspertów w mediach społecznościowych, ogłoszenia i wielojęzyczne wersje wiadomości — wszędzie tam, gdzie w przeciwnym razie konieczne byłoby filmowanie prezentera.

6

Który model zasila awatara AI?

CreateVision AI wykorzystuje platformę OmniHuman 1.5 firmy ByteDance, która odpowiada za synchronizację ruchu ust, głowy i gestów z dźwiękiem. Szczegóły techniczne można znaleźć na stronie modelu OmniHuman 1.5.

7

Jakie zdjęcie sprawdza się najlepiej w generatorze wideo z awatarem AI?

Dobrze oświetlony portret na wprost, na którym cała twarz jest widoczna i ostra. Okulary przeciwsłoneczne, głęboki cień na twarzy, skrajne ujęcia albo bardzo mała twarz w kadrze — każde z tych zjawisk obniża dokładność synchronizacji ust.

8

Czy muszę nagrywać własny głos?

Nie. Możesz wpisać tekst i wybrać głos z wbudowanej biblioteki, która obejmuje 60 głosów w 10 językach. Przesłanie własnego nagrania też jest obsługiwane, jeśli wolisz je wykorzystać.

9

Czy mogę sam wystąpić w wideo?

Tak, i to jest najczęstsze zastosowanie. Prześlij swoje zdjęcie, a potem nagraj własny głos albo wpisz scenariusz i wybierz głos z biblioteki. Efekt to ty, mówiący twoje słowa, bez ustawiania kamery. Wielu twórców trzyma jedno dobre zdjęcie i co tydzień generuje z niego nowe klipy.

10

Czy mogę używać mówiącego zdjęcia AI komercyjnie?

Tak. Zgodnie z Warunkami korzystania z usługi CreateVision AI treści, które generujesz, mogą być wykorzystywane do celów osobistych i komercyjnych, z oznaczeniem CreateVision AI tam, gdzie to stosowne. Odpowiadasz za posiadanie praw do zdjęcia i głosu, które przesyłasz, oraz za przestrzeganie zasad ujawniania treści AI na platformie, na której publikujesz.

11

Kiedyś umieszczałem siebie w filmach za pomocą Sora. Czy to to samo?

Ten sam cel, inna mechanika. Tutaj Twoje zdjęcie jest tożsamością, a nagranie audio lub scenariusz steruje mową, więc wynikiem jest klip z mówiącą głową z synchronizacją warg, a nie scena, w której zostajesz umieszczony. Działa na podstawie dowolnego pojedynczego zdjęcia, nie wymaga rejestracji wideo i nie zależy od dostępności innej aplikacji.

Stwórz swoje pierwsze mówiące zdjęcie AI

Rozpocznij tworzenie