Generador de texto a vídeo

Describe la escena, el movimiento, el ambiente y la dirección de cámara, y luego genera vídeo con un modelo y un conjunto de parámetros adecuados para la tarea.

Prompt a movimientoControl de duraciónSelección de modelo de vídeo
0 / 2,000
~75 cr

IA de texto a vídeo: escribe la escena, obtén el metraje

Describe el sujeto, el movimiento, la atmósfera y la cámara, y genera clips cinematográficos con audio nativo. Impulsado por Seedance 2.0 —el modelo que actualmente gana las votaciones de preferencia a ciegas— junto con Veo 3.1 Fast.

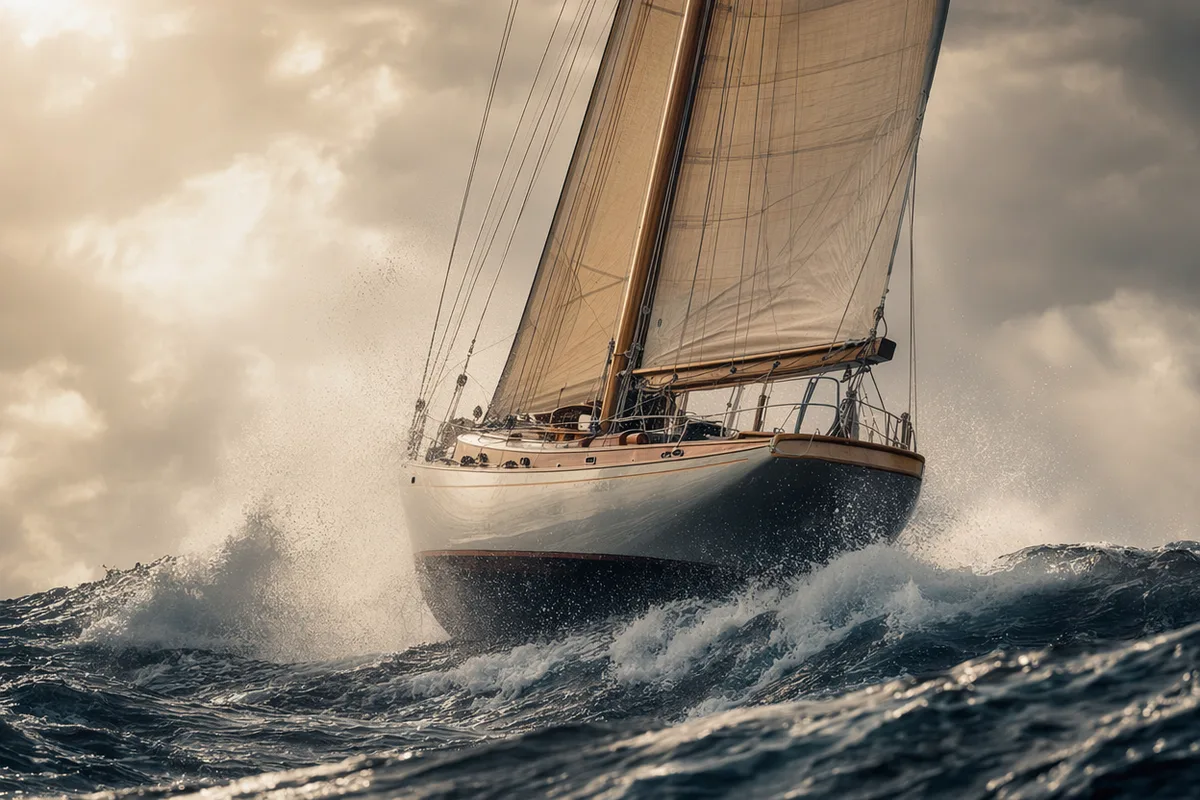
Fotograma de película de IA cinematográfico de un velero en una tormenta

Escenas cinematográficas a partir de frases sencillas

Una tormenta en el mar, una persecución por calles de neón, un café tranquilo de noche: descríbelo como se lo contarías a un amigo y el modelo se encarga de la cinematografía. La salida de Veo se describe una y otra vez como "dirigida, no generada": luz intencional, física creíble y gramática de cámara real.
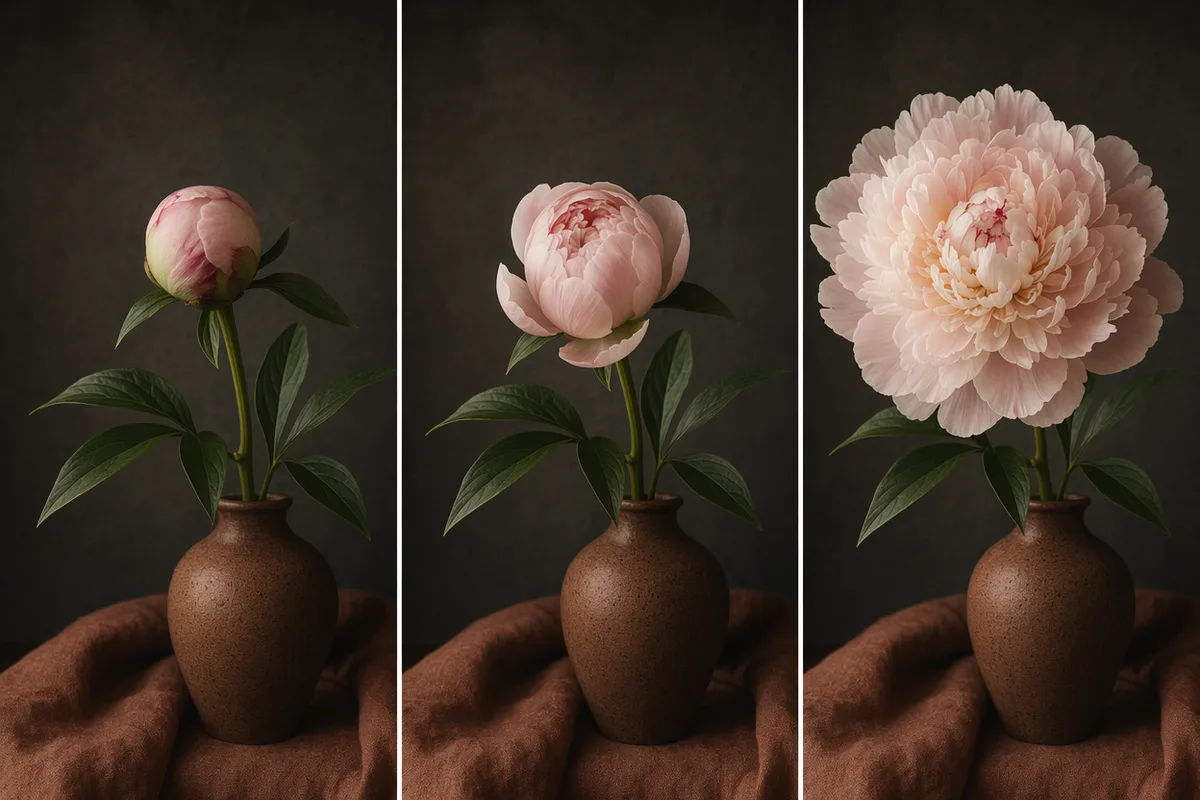
Secuencia en timelapse de una flor floreciendo a lo largo de tres fotogramas

Movimiento y ritmo que puedes especificar

Acercamiento lento, floración en timelapse, energía de cámara en mano: la dirección de movimiento del prompt se respeta, y la duración la fijas tú (4–15 segundos según el modelo). El clip se ajusta al encargo en lugar de aproximarse a él.

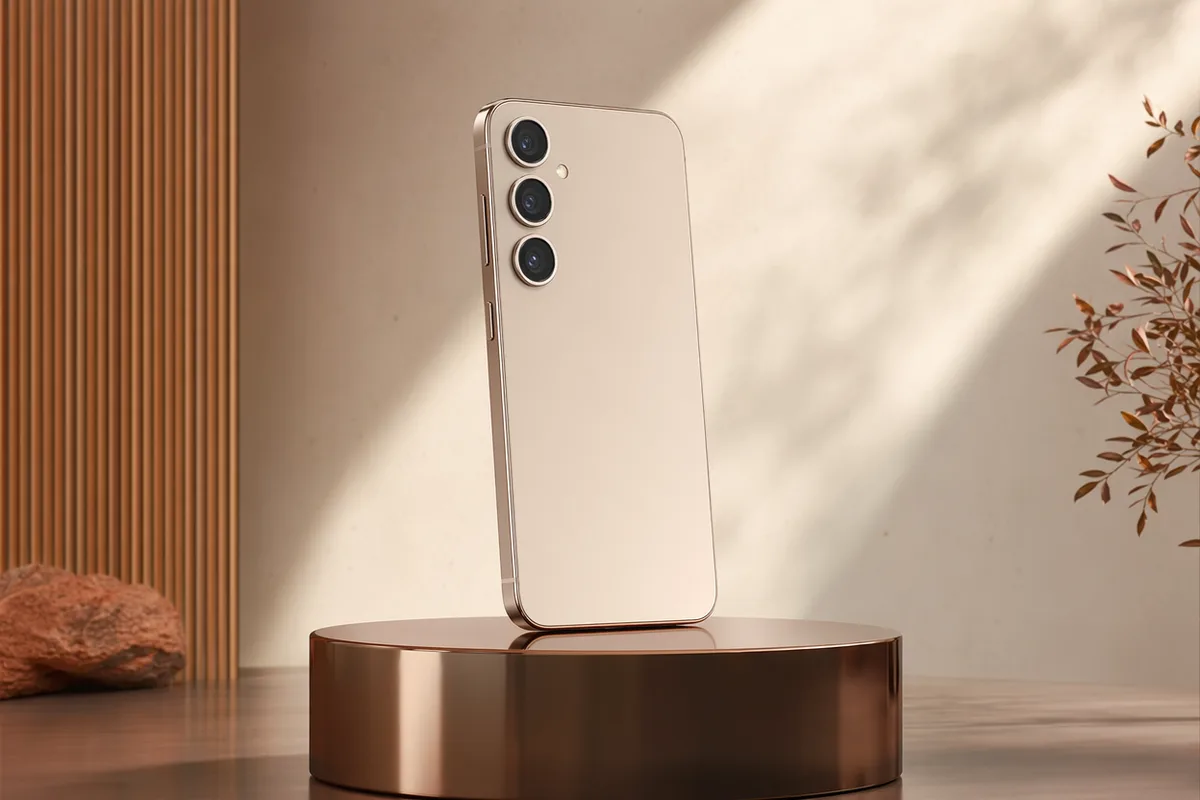
Fotograma de vídeo de producto de estilo comercial de un smartphone girando

Clips de producto y de marca en minutos

Tomas destacadas en rotación, tomas de vertido, unboxings: metraje de estilo comercial que antes requería una sesión de estudio se genera a partir de un párrafo. Los precios por segundo con el coste exacto mostrado de antemano hacen que las campañas sigan siendo presupuestables.

Timelapse del horizonte de la ciudad con estelas de luz al anochecer

Sonido incluido, listo para vertical

El diálogo nativo, el ambiente y los efectos llegan junto con la imagen; tanto 9:16 vertical como 16:9 panorámico son de primera clase. La salida es un clip listo para publicar, no un borrador mudo.

Clips de texto a vídeo hechos en esta página

Todos empezaron solo como texto escrito, nada más. El prompt que lo produjo aparece debajo.

PromptSeedance 2.5 · 480p · 16:9 · clip de 4 s · 440 créditos

A ceramicist in a sunlit workshop looks up from the wheel and speaks warmly to camera: "This one finally came out right." Clay-dusted hands, natural skin texture, shallow depth of field, soft window light, ambient studio room tone.

PromptSeedance 2.0 Mini · 720p · 16:9 · clip de 5 s · 150 créditos

A golden retriever puppy sprinting across a sunlit meadow toward the camera, ears flapping, slow-motion feel, backlit grass glowing, joyful energy.

PromptKling 3.0 Turbo · 1080p · 16:9 · 5 s · 350 créditos

A parkour athlete vaulting across rooftop gaps at golden hour, dynamic tracking camera, accurate body mechanics and momentum, dust kicked up on landings, cinematic sports energy.

PromptSeedance 2.0 Mini · 720p · 9:16 · 5 s · 150 créditos

Handheld vertical walk through a neon night market, steam rising from food stalls, lanterns swaying, people passing in soft motion blur, lively street ambience.

PromptKling 3.0 Turbo · 720p · 16:9 · 5 s · 275 créditos

Close-up of an elderly fisherman laughing warmly at dusk on a boat deck, wrinkles and windblown hair rendered naturally, genuine expressive performance, handheld documentary feel.

PromptSeedance 2.0 Mini · 480p · 16:9 · 4 s · 60 créditos

Two tiny paper boats racing down a rain-gutter stream after a storm, water rushing over pebbles, playful close follow shot.

PromptKling 3.0 Turbo · 720p · 9:16 · 5 s · 275 créditos

Vertical fashion film: a model in a flowing emerald dress walking toward camera down a rain-slick runway, fabric rippling naturally with each step, confident stride, editorial lighting.

PromptSeedance 2.5 · 480p · 16:9 · 4 s · 440 créditos · la pizarra salió como «SOUPE DU JWIN»

Close-up of a chef\'s hands rapidly julienning a carrot on a wooden board, knife tapping fast, a handwritten chalkboard menu reading "SOUPE DU JOUR" visible behind, busy kitchen sounds.

Modelos de texto a vídeo entre los que puedes alternar

Una escena escrita, varios motores: quédate con aquel cuyo movimiento te guste.

Especificaciones de texto a vídeo

EntradaSolo prompt de texto: no hace falta imagen.
Idiomas de los promptsLos 27 idiomas de la interfaz; los prompts que no están en inglés se enriquecen antes de generar.
DuraciónDe 4 a 30 segundos según el modelo. Las piezas más largas se construyen extendiendo un clip que te guste.
Resolución480p y 720p en toda la gama; 1080p y 4K en Seedance 2.0 standard.
AudioAlgunos motores generan audio sincronizado de forma nativa en la misma pasada; otros devuelven clips mudos. Se indica en el panel.
CostePor segundo de salida, desde 15 créditos/segundo a 480p, mostrado al completo antes de generar.
Generaciones fallidasNo se cobra: los créditos siguen en tu saldo.

Cómo usar el generador de texto a vídeo

Escribe la escena, elige el motor, genera.

  1. 1

    Escribe la escena

    Describe el sujeto, la acción, el escenario y el movimiento de cámara. Los modelos de texto a vídeo responden al lenguaje de planos —«travelling lento hacia dentro», «cámara en mano», «plano general»— mucho más que los modelos de imagen.

  2. 2

    Elige modelo, duración y resolución

    Cada motor de texto a vídeo tiene sus puntos fuertes en movimiento y audio. El coste es por segundo y se muestra antes de generar.

  3. 3

    Genera y continúa

    Descarga el clip, extiéndelo o llévalo a más edición. El prompt y los ajustes quedan asociados en el historial.

Cómo escribir un prompt de texto a vídeo

Los modelos de texto a vídeo leen descripciones de plano, no resúmenes de escena. Cuatro componentes, en este orden.

1

Sujeto

Quién o qué está en el encuadre, con un detalle distintivo.

un cocinero con la chaquetilla blanca manchada

2

Acción

Una acción, descrita tal como se desarrolla.

emplata un plato, unas pinzas colocan la última hierba

3

Cámara

Posición y movimiento. Dilo incluso cuando la respuesta sea «sin movimiento».

plano cenital con cámara fija

4

Aspecto

Luz, color y acabado.

luz dura de cocina, alto contraste, documental

Vago

una mujer caminando bajo la lluvia

Concreto

una mujer con abrigo largo camina hacia la cámara bajo la lluvia del atardecer, paraguas inclinado hacia atrás, luces de tiendas desenfocadas detrás de ella, travelling lento hacia atrás a la altura de los ojos, poca profundidad de campo, azul frío con luz cálida de ventana

Por qué funciona

La versión corta indica un sujeto y una condición meteorológica y nada más: cámara, dirección, luz y óptica quedan en manos del modelo. La versión larga fija cada una de ellas, y por eso produce dos veces el mismo plano.

Vago

vídeo de producto para un frasco de cosmética

Concreto

un frasco de sérum de vidrio esmerilado gira lentamente sobre una superficie de piedra mojada, cámara fija a la altura del producto, una única luz principal suave desde la derecha, gotas de agua recogiendo brillos, macro, look comercial limpio

Por qué funciona

El vídeo de producto falla en el encuadre y la luz mucho más a menudo que en el objeto. Fijar la cámara, nombrar una luz y elegir macro le da al modelo las tres decisiones que, si no, adivinaría.

Hábitos que conviene dejar

  • Pedir demasiada acción. Cada movimiento de más es otra oportunidad para que el modelo deforme una cara o una mano. Una acción clara por clip aguanta mucho mejor que tres.
  • Dejar la cámara sin especificar. Si no dices cómo se comporta la cámara, elige el modelo, y casi siempre elige la deriva. «Cámara fija» es una instrucción válida y útil.
  • Ir directo a la duración máxima. La deriva se acumula con el tiempo. Genera una toma corta que te convenza y luego extiéndela, en vez de pedir 30 segundos al primer intento.

Más allá de texto a vídeo

El vídeo guiado por prompt es un camino. Las imágenes de referencia, los avatares y la edición son los otros.

Recursos útiles sobre IA de texto a vídeo

Texto a vídeo: precios y créditos diarios gratis

El texto a vídeo se cobra por segundo de salida. Las cuentas gratuitas reciben 80 créditos al día; los planes de pago abren los motores premium y duraciones más largas.

Gratis

$0

Perfecto para empezar

  • 200 créditos de bienvenida, hasta 80/día
  • Borradores de Z Image Turbo a 0 créditos
  • Velocidad de generación estándar
  • Historial de generaciones incluido
Comenzar

Premium

Más popular
$29/month

Facturación anual · $240/año

  • 8.000 créditos/mes, sin límites diarios
  • Todos los modelos premium — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • Velocidad de generación 5x, cola prioritaria
  • Mejora de prompts con IA
Mejorar a Premium

Ultimate

$49/month

Facturación anual · $380/año

  • 18.000 créditos/mes, sin límites diarios
  • Generación en HD hasta resolución 4K
  • Soporte prioritario
  • La cola más rápida y acceso anticipado a nuevos modelos
Mejorar a Ultimate

Texto a vídeo: preguntas frecuentes

1

¿Cómo funciona el texto a vídeo?

Describes la escena —sujeto, movimiento, atmósfera, cámara— y un modelo de vídeo de IA genera un clip desde cero, incluido el audio nativo. No se necesita metraje de origen.

2

¿Qué modelo debería usar?

Seedance 2.0 Fast para iterar de forma asequible, Seedance 2.0 para historias multitoma, Veo 3.1 Fast para un acabado cinematográfico de una sola toma, Seedance 1.5 Pro cuando necesitas un control exacto de 1080p/duración.

3

¿Cuánto pueden durar los vídeos?

Aproximadamente de 4 a 15 segundos por generación según el modelo, con extensión de escena disponible en Seedance 2.0 para continuar secuencias.

4

¿Los clips incluyen audio?

Sí: Seedance y Veo generan diálogo, ambiente y efectos de forma nativa. El audio puede desactivarse en Seedance para una tarifa por segundo menor.

5

¿Cuánto cuesta?

Por segundo, variando según el modelo, la resolución y el audio: siempre mostrado antes de generar, con reembolsos automáticos en caso de fallo.

6

¿Cómo escribo un buen prompt de vídeo?

Nombra el sujeto, la acción, el escenario, la atmósfera y el movimiento de cámara. El potenciador de prompts integrado expande automáticamente las ideas breves en encargos de vídeo bien estructurados.

7

¿Puedo hacer vídeos verticales para TikTok y Reels?

Sí: elige 9:16 en cada generación para plataformas verticales, o 16:9 para YouTube y la web.

8

¿Cómo escribo un buen prompt de texto a vídeo?

Separa el sujeto, la acción y la cámara. «Un chef emplatando» es un sujeto; «acercamiento lento a un chef emplatando, poca profundidad de campo, luz cálida de cocina» es un plano. Los modelos de texto a vídeo siguen el segundo con mucha más fiabilidad.

9

¿Puede el texto a vídeo generar diálogos y sonido?

En los motores que admiten audio nativo, sí, incluida el habla sincronizada. Otros producen clips mudos. Cuál es cuál aparece marcado en el panel de modelos antes de que gastes créditos.

10

¿Por qué mi clip de texto a vídeo se desvía del prompt?

Cuanto más larga es la duración, más se desvía, porque el modelo tiene más fotogramas que rellenar y menos anclaje. Los clips cortos se ciñen mejor al prompt; si necesitas duración, genera una toma corta que te guste y extiéndela en vez de pedir 30 segundos de entrada.

Escribe un párrafo, estrena un clip

Empieza a generar vídeos

Descubre nuestras herramientas IA de video en un clic

Herramientas de un clic para todo lo que rodea la generación: pulir, cambiar de estilo y compartir.