Говорящая фотография с ИИ

Загрузите портрет и аудиодорожку (до 35s) или введите сценарий и выберите голос — и OmniHuman 1.5 превратит фотографию в говорящее видео с синхронизированными губами и естественным движением. Используйте собственное фото, чтобы сняться в ролике самому.

0 / 2,000
130 cr/s · ≤35s

От одного фото к говорящему видео

Один портрет и сценарий превращаются в живого спикера — синхронные губы, мимика и жесты. Без камеры и студии.

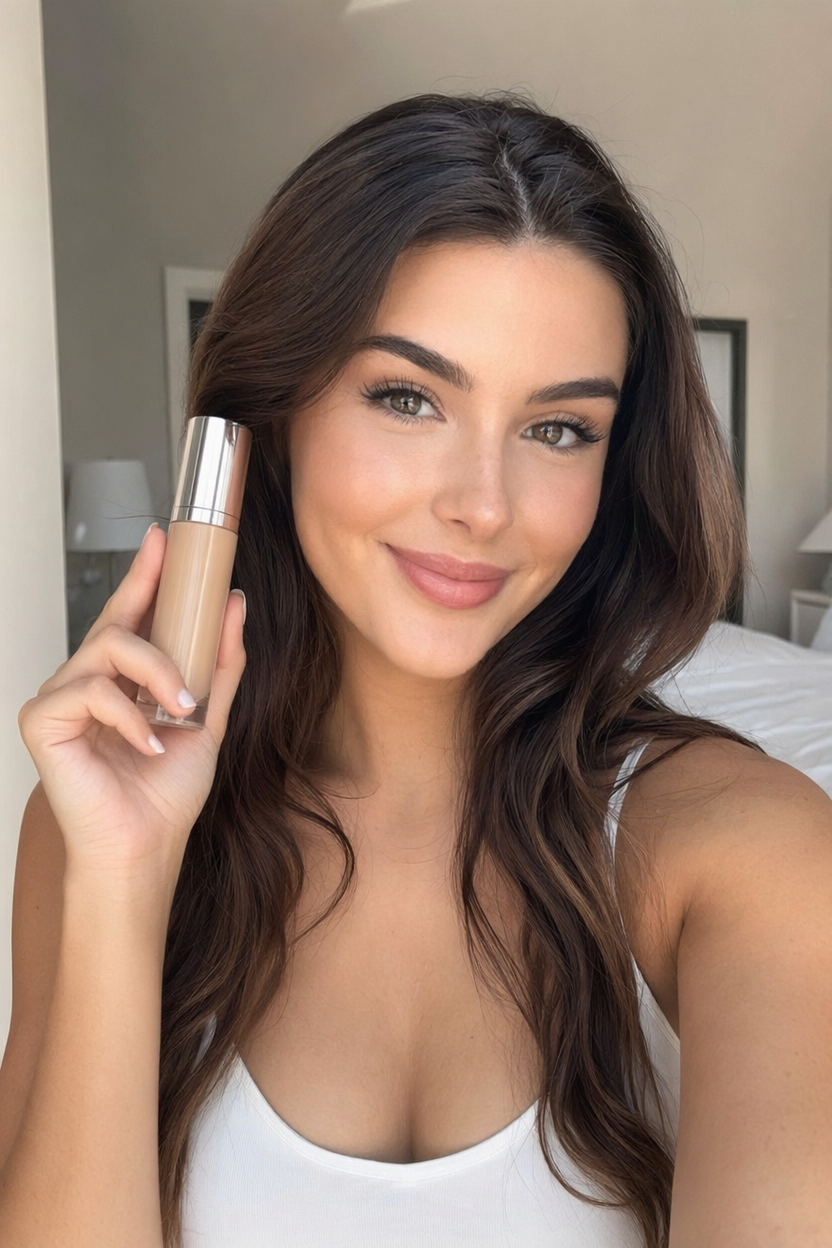
Исходное изображениеOriginal portrait photo of a beauty creator holding a skincare product
Сценарий

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

Видео с ИИ-аватаром

Заставьте говорить любое фото, включая ваше собственное

Полный генератор говорящих фото с ИИ (цифровой человек): загрузите портрет и аудиоклип или введите сценарий и выберите голос — и получите реалистичное говорящее видео с синхронизированными губами, естественной мимикой и жестами. Используйте собственное фото, чтобы стать ведущим. Работает на ByteDance OmniHuman 1.5, без камеры, актёра или студии.

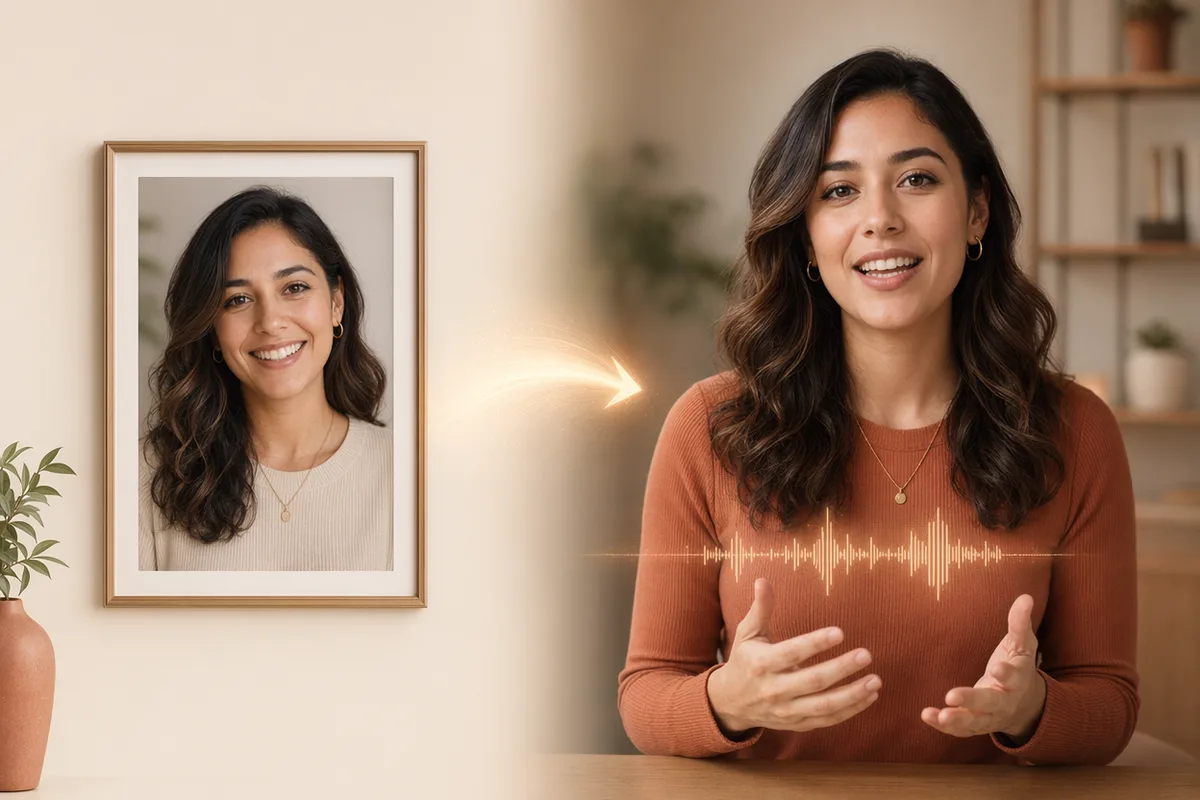
Портретное фото в рамке превращается в говорящий ИИ-аватар той же женщины, а между ними — аудиоволна

Снимитесь в нём сами или создайте цифрового представителя

Без съёмок, без актёра, без зелёного экрана. Загрузите одно чёткое фото себя, и вы становитесь ведущим, который зачитывает ваш сценарий вашим голосом или голосом из библиотеки. Или возьмите фото человека, который дал вам разрешение, и создайте многоразового цифрового ведущего для объяснений продукта, вступлений к курсам, объявлений и рекламы. Перегенерируйте новые реплики в любое время без пересъёмки.
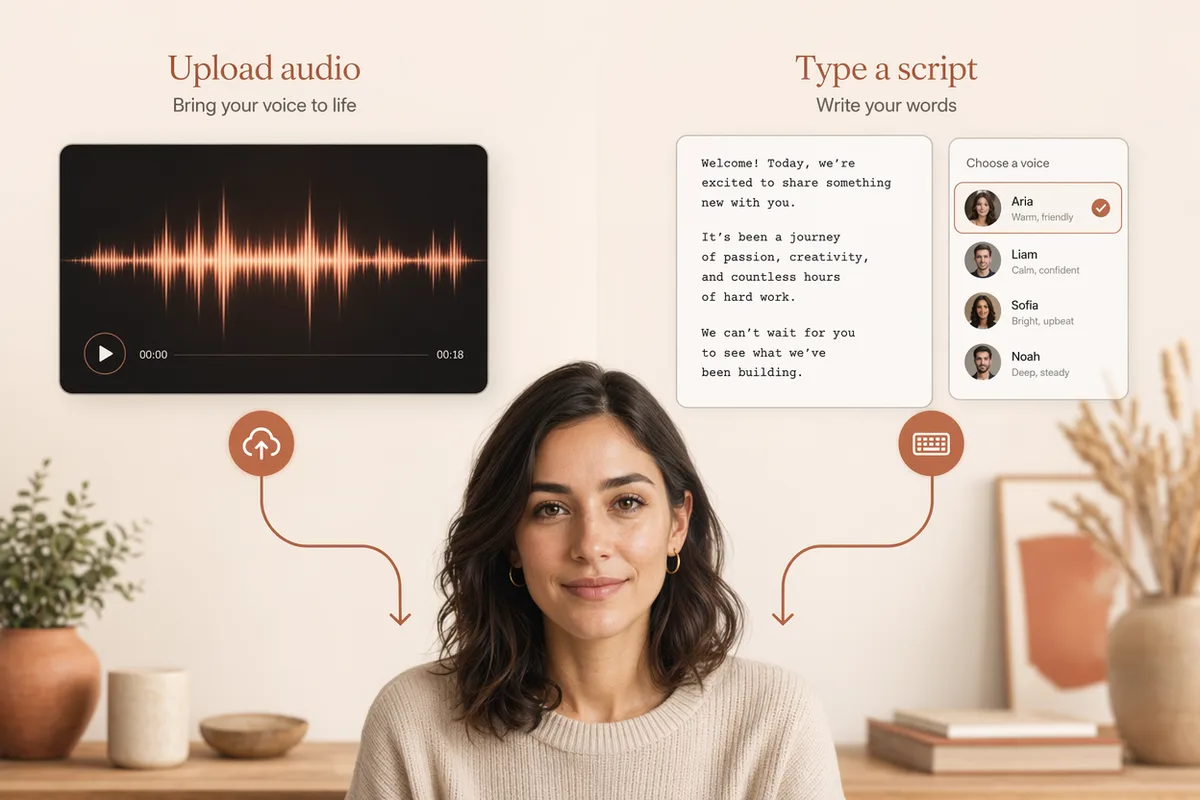
Два входных данных для говорящего фото с ИИ: загруженная аудиоволна и введённый сценарий с выбором голоса

Есть два способа: загрузить аудиофайл или написать сценарий.

У вас уже есть голосовая запись? Загрузите её, и аватар синхронизирует движения губ с ней. Нет звука? Переключитесь в текстовый режим — наберите текст, который должен произнести аватар, выберите голос из встроенной библиотеки преобразования текста в речь, и сценарий будет синтезирован в аудиодорожку для вас. Ориентировочная продолжительность и стоимость кредитов отображаются перед созданием.

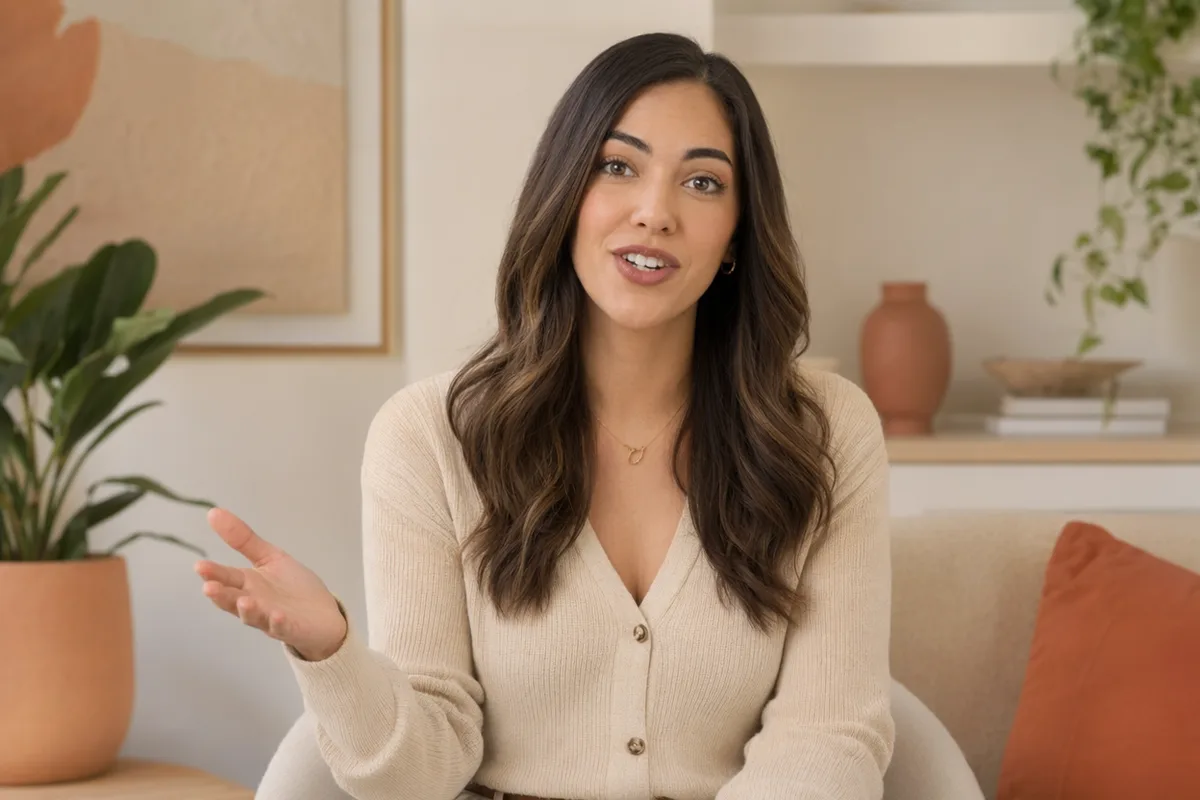
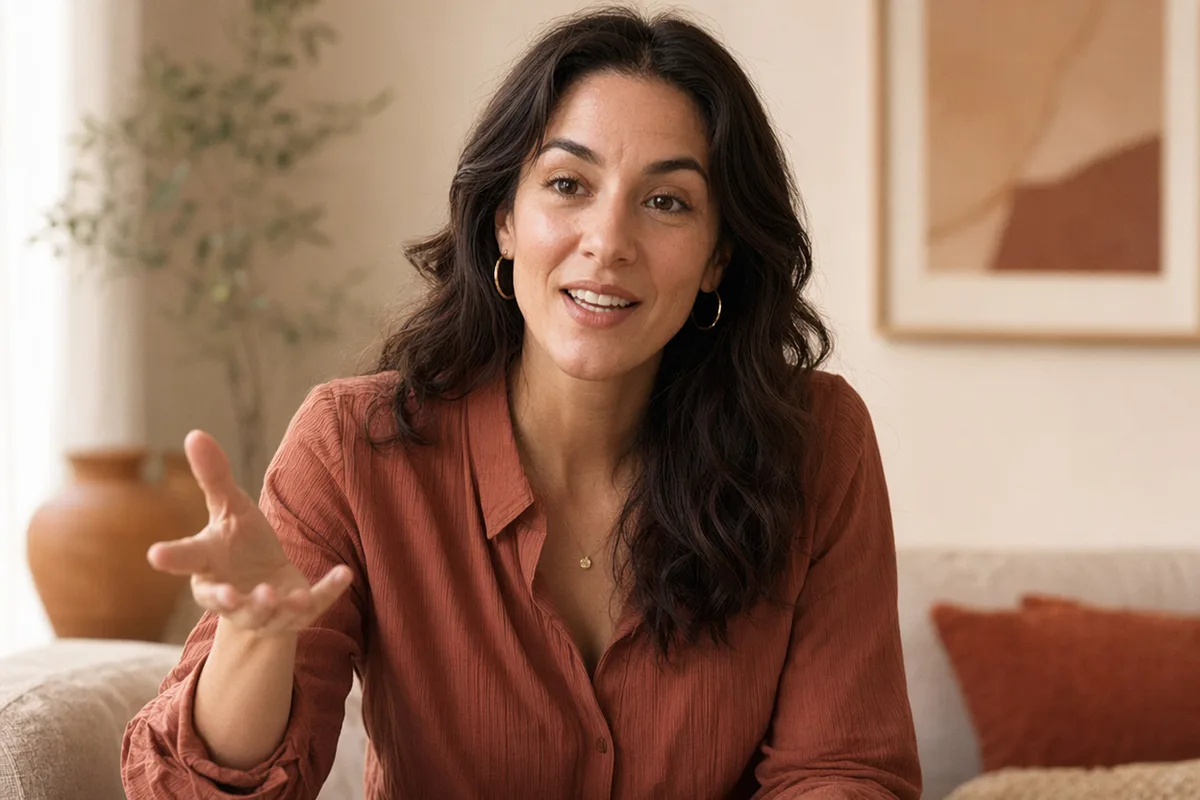
Кадр говорящего фото с ИИ: женщина говорит в камеру с естественными жестами рук

Реалистично — не просто движущийся рот.

OmniHuman 1.5 считывает ритм, просодию и смысл аудио, чтобы управлять движениями головы, осанкой и жестами рук, а также точно синхронизировать движения губ, сохраняя при этом индивидуальность человека и освещение. В результате получается образ настоящего ведущего, а не статичный портрет с анимированным ртом.

Ведущий говорящего фото с ИИ в гостиной записывает короткий клип для соцсетей

Создано для маркетинга, обучения и социальных сетей.

Создавайте видеоролики с участием спикеров для рекламы и целевых страниц, обучающие уроки и вводные материалы для тренингов, посты с говорящими головами для социальных сетей или многоязычные версии одного и того же сообщения. Каждая версия сохраняется в истории вместе со своими исходными данными, поэтому вы можете быстро вносить изменения и создавать вариации.

Портреты, готовые для говорящего фото с ИИ

Портреты в стиле ведущего, сгенерированные в CreateVision AI: любой из них можно оживить в говорящее аватар-видео, как только вы добавите звук.

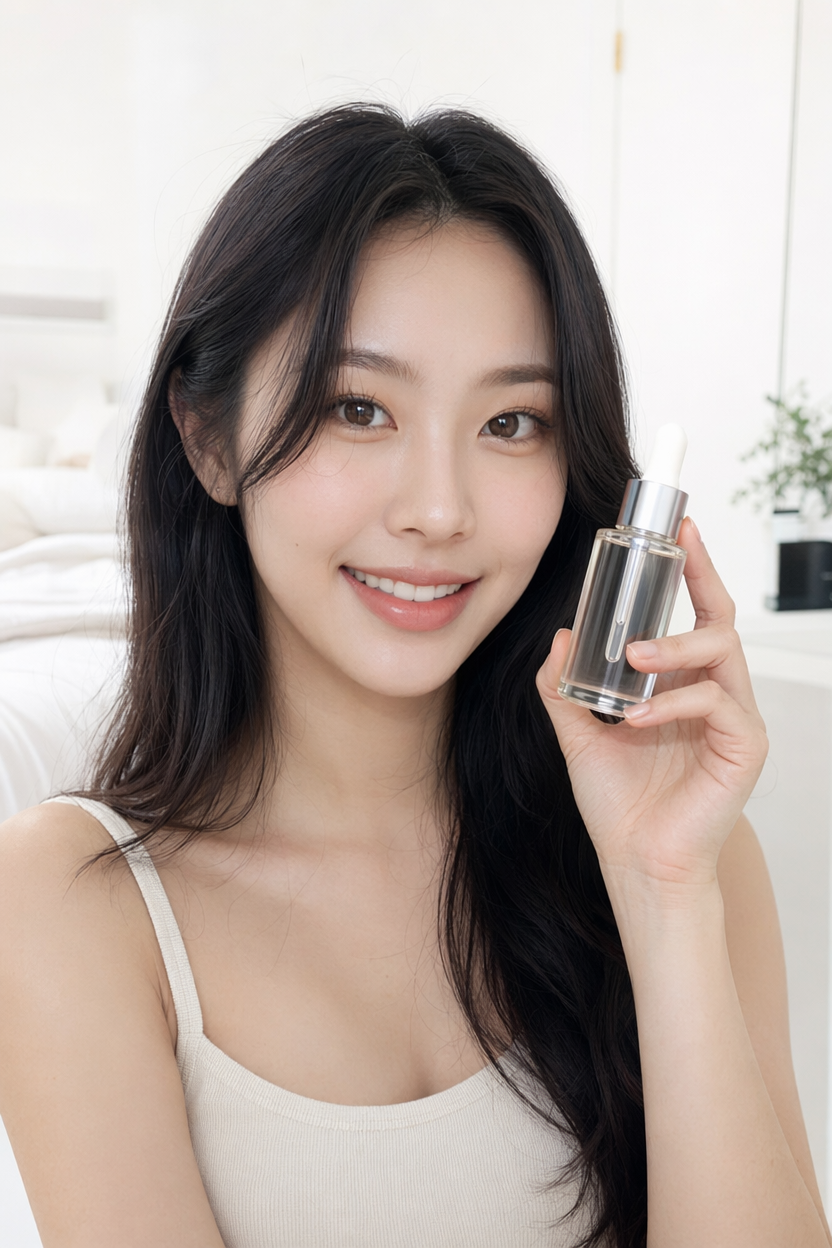
Искусственный интеллект, изображающий бьюти-блогера, презентующего сыворотку для ухода за кожей.
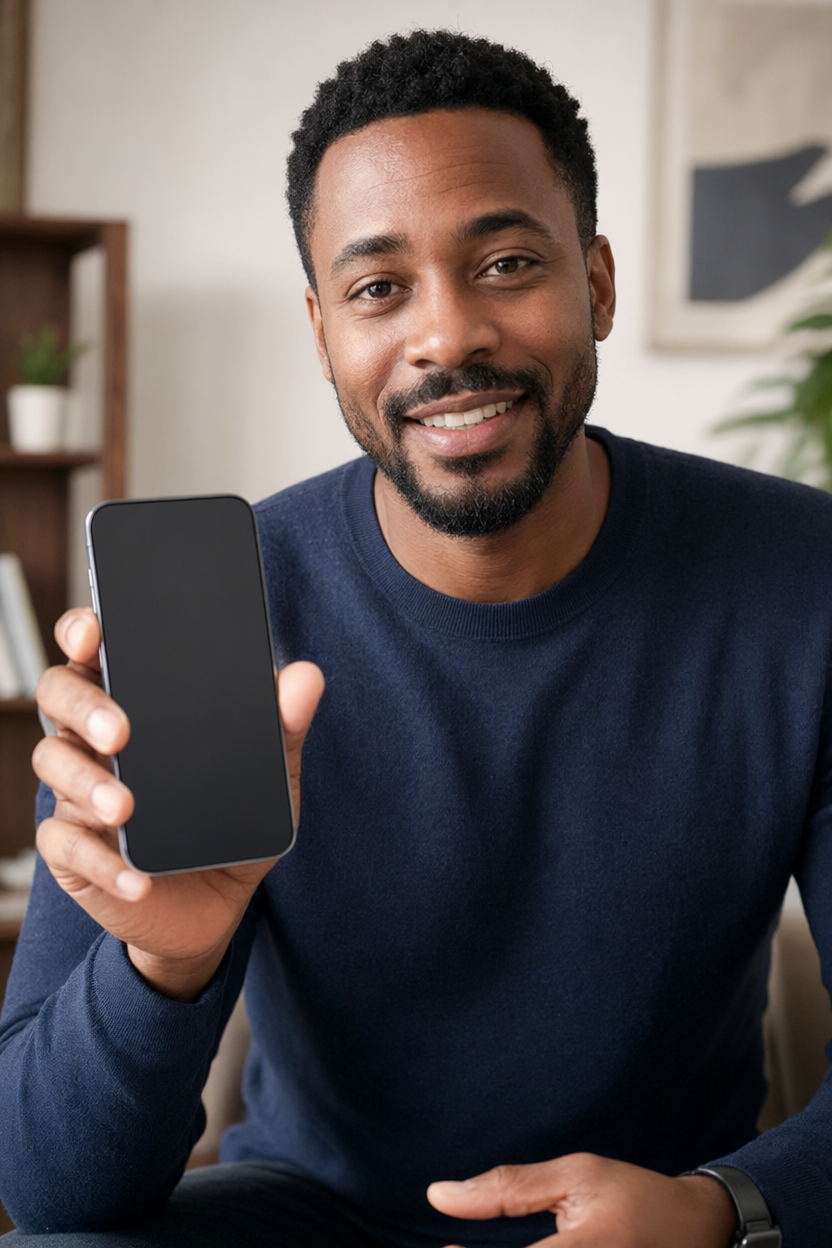
Аватар ИИ, изображающий технического обозревателя, демонстрирующего смартфон.
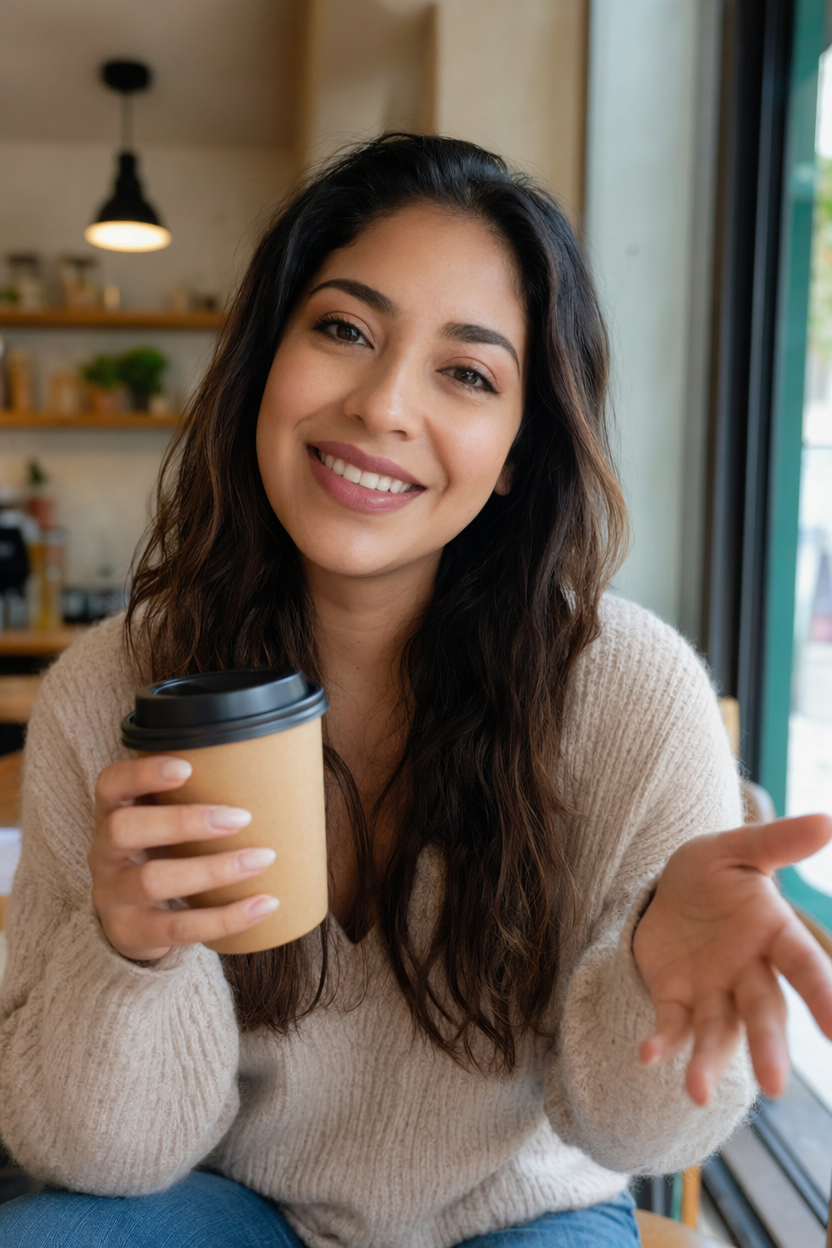
Аватар искусственного интеллекта, изображающий создателя образа жизни с чашкой кофе.
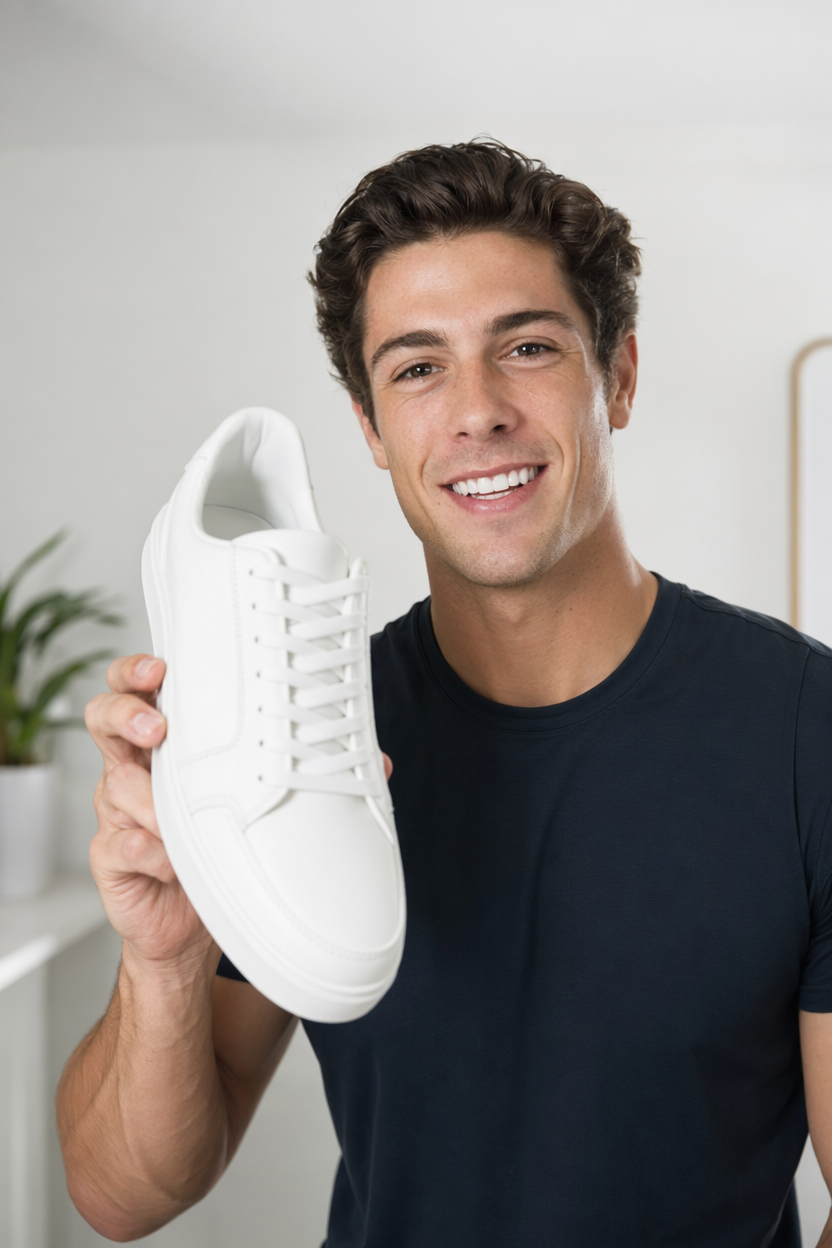
Искусственный интеллект, изображающий обозревателя кроссовок, демонстрирующего модель обуви.
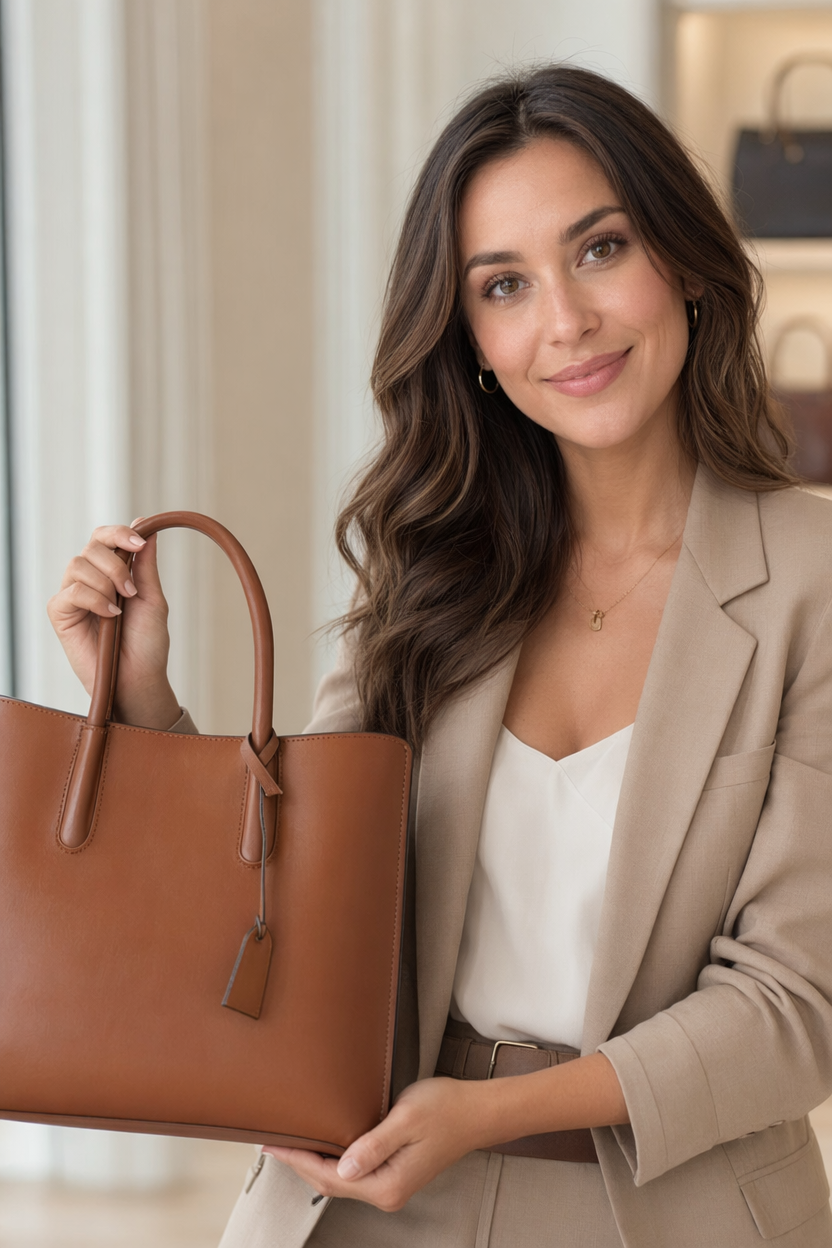
Искусственный интеллект, изображающий модельера с сумочкой.
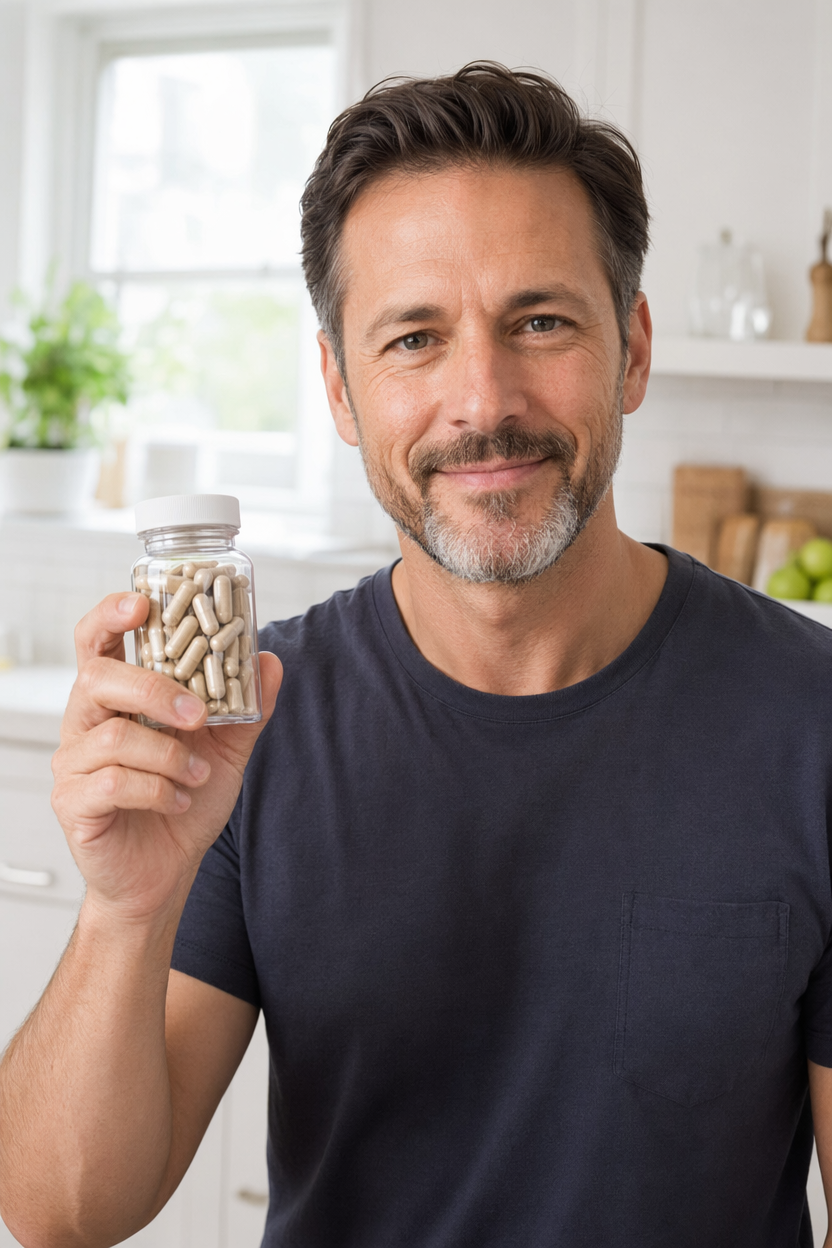
Искусственный интеллект, изображающий создателя контента о здоровом образе жизни, рекламирует пищевые добавки.
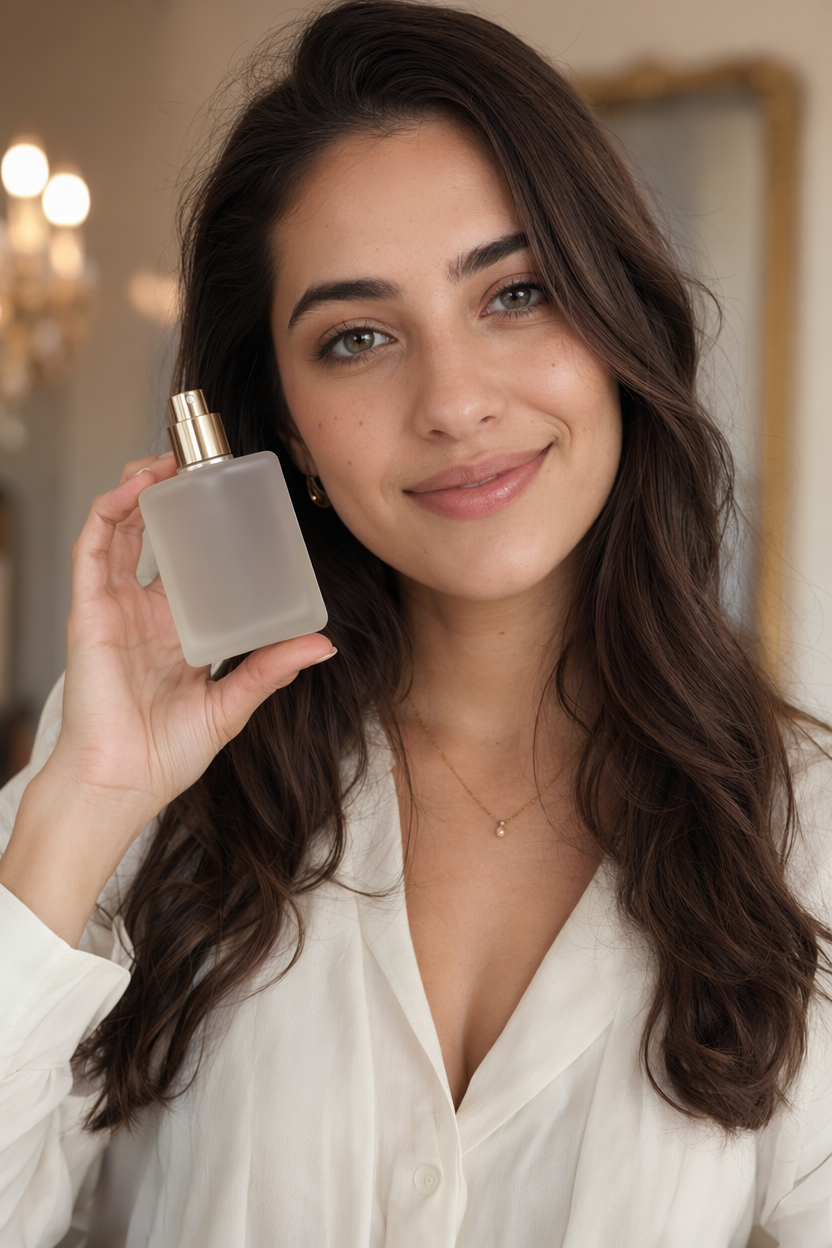
Аватар ИИ, изображающий бьюти-блогера с флаконом духов.
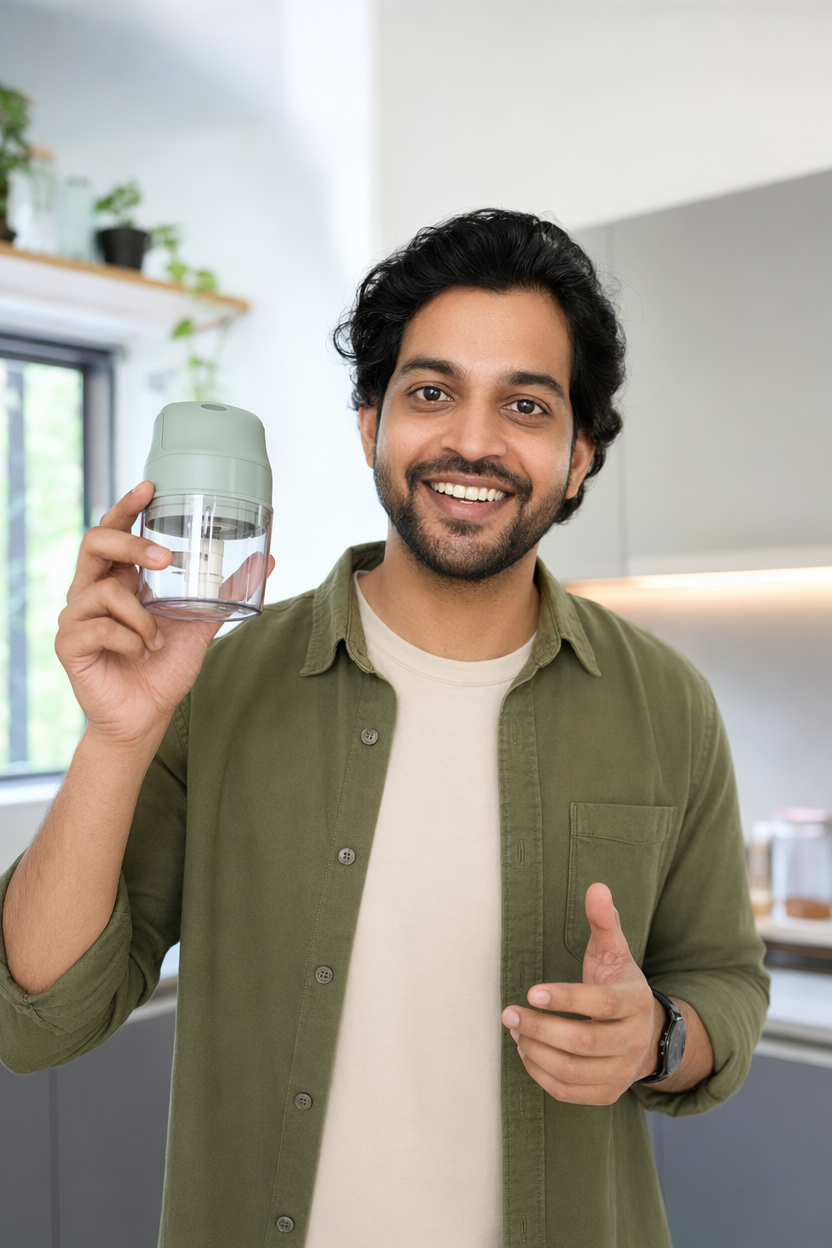
Искусственный интеллект, изображающий создателя рецептов домашней кухни с кухонным гаджетом.

Модель в основе этого генератора говорящих фото с ИИ

За синхронизацию губ, мимику и движения тела на этой странице отвечает OmniHuman 1.5.

Характеристики говорящего фото с ИИ

ВводОдно портретное фото плюс либо загруженный аудиофайл, либо набранный сценарий.
Чьё фотоВаше собственное или человека, который дал вам разрешение. И фото, и голос должны быть доступны вам для использования.
Требования к портретуАнфас, хорошо освещённое, лицо целиком видно и в фокусе. Тёмные очки и глубокая тень снижают точность синхронизации губ.
Длительность аудиоДо 35 секунд за генерацию — примерно 85 произнесённых слов.
Библиотека голосов60 встроенных голосов на 10 языках, с прослушиванием до генерации.
МодельOmniHuman 1.5 — он отвечает за синхронизацию губ, мимику и естественные движения головы и тела.
СтоимостьСписывается посекундно, как и в остальной видеогенерации; сумма показана до запуска.
РезультатКлип, готовый к скачиванию, сохранённый в вашей истории вместе с исходным портретом и сценарием.

Как сняться в собственном говорящем фото с ИИ

Ваше фото, ваши слова, один клип.

  1. 1

    Загрузите своё фото

    Лучше всего подходит чёткое фото анфас: селфи на телефон, деловой портрет или кадр из видео. ИИ говорящего фото считывает ваше лицо из этого единственного кадра.

  2. 2

    Добавьте свой голос

    Запишите себя и загрузите аудио или введите сценарий и выберите один из 60 встроенных голосов. Аудио может длиться до 35 секунд.

  3. 3

    Сгенерируйте, затем используйте себя повторно

    Модель синхронизирует губы, мимику и естественные движения головы с аудио. Сохраните то же фото и генерируйте новые реплики, когда они понадобятся, без пересъёмки.

Как написать сценарий для говорящего фото с ИИ

Промпта для изображения здесь нет — работу делают портрет и звук. Вы пишете сценарий, и именно решения в сценарии определяют, будет ли результат выглядеть естественно.

1

Первая фраза

Начните с чего-то короткого. Первая секунда — там синхронизация губ заметнее всего.

Привет — коротко к делу.

2

Длина предложения

Держите предложения примерно до 15 слов. Длинные обороты дают неестественные паузы.

В этой сыворотке два ингредиента. Это вся формула.

3

Пунктуация

Запятые и точки превращаются во вдохи. Ставьте их там, где вы действительно сделали бы паузу.

Это работает — и занимает десять секунд.

4

Бюджет длительности

Примерно 2,5 слова в секунду. Пишите под нужную длину клипа.

~85 слов на 35-секундный клип

Расплывчато

Наш революционный продукт использует передовые технологии, чтобы обеспечить непревзойдённые результаты для взыскательных клиентов, стремящихся к совершенству.

Конкретно

Вот об этом всегда и спрашивают. Два ингредиента, без наполнителей. Разницу увидите примерно через неделю.

Почему это работает

Первый — одно предложение из 19 слов сплошных абстракций: аватар произносит его ровным монотонным потоком, потому что паузу поставить негде. Второй — три коротких предложения с естественными смысловыми ударениями, и именно это делает подачу человеческой.

Расплывчато

Здравствуйте и добро пожаловать на наш канал, где сегодня мы будем обсуждать пять самых важных вещей, которые вам необходимо знать о процедурах ухода за кожей.

Конкретно

Пять вещей об уходе за кожей. Первую большинство делает неправильно.

Почему это работает

Именно на длинных сбивчивых вступлениях синхронизация губ уплывает сильнее всего: модели не за что зацепиться, знаков препинания нет. Короткий хук даёт ей чистые точки ударения и лучше удерживает внимание.

Привычки, от которых стоит отказаться

  • Брать портрет, где лицо мелкое, повёрнутое или наполовину в тени. Точность синхронизации губ напрямую зависит от того, насколько ясно виден рот в исходном кадре.
  • Писать длиннее лимита звука. Генерация обрезается на 35 секундах аудио — более длинный сценарий обрежется, так что разбейте его на части и используйте тот же портрет.
  • Плотный технический текст. Именно на числах, аббревиатурах и длинных названиях продуктов синтетическая речь звучит наиболее синтетически. Пишите их так, как произнесли бы вслух.

Не только генератор видео с ИИ-аватаром

Говорящие аватары — лишь один из результатов. Генерация изображений и видео работает из того же аккаунта.

Полезные материалы о видео с ИИ-аватаром

Цены на говорящее фото с ИИ и бесплатные кредиты

Видео говорящих фото тарифицируются посекундно, как и другой видеовывод. Новые аккаунты получают 200 бесплатных кредитов, чтобы попробовать.

Бесплатно

$0

Идеально для начала

  • 200 приветственных кредитов, до 80 в день
  • Z Image Turbo создаёт черновики за 0 кредитов
  • Стандартная скорость генерации
  • История генераций включена
Начать

Premium

Самый популярный
$29/month

Оплата раз в год · $240/год

  • 8 000 кредитов/мес, без дневных лимитов
  • Все премиум-модели — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • 5-кратная скорость генерации, приоритетная очередь
  • ИИ-улучшение промптов
Перейти на Premium

Ultimate

$59/month

Оплата раз в год · $468/год

  • 18 000 кредитов/мес, без дневных лимитов
  • HD-генерация вплоть до разрешения 4K
  • Приоритетная поддержка
  • Самая быстрая очередь и ранний доступ к новым моделям
Перейти на Ultimate

Говорящее фото с ИИ — часто задаваемые вопросы

1

Что такое говорящее фото с ИИ?

Говорящее фото с ИИ, также называемое ИИ-аватаром или цифровым человеком, — это сгенерированное говорящее видео человека, созданное из одного фото и голоса. Вместо съёмки вы предоставляете портрет и аудио (или сценарий + голос), а модель анимирует реалистичное выступление с речью — его используют как цифрового ведущего, представителя или рассказчика.

2

Что мне нужно, чтобы его создать?

Чёткое портретное фото анфас, а также аудиоклип (mp3/wav) или — в текстовом режиме — текст, который вы хотите озвучить, и голос, выбранный из встроенной библиотеки. Этого достаточно для создания видеоролика с говорящим аватаром.

3

Могу ли я использовать свой собственный голос?

Да. Загрузите свою аудиозапись, и аватар синхронизирует движения губ с ней. Если у вас нет записи, переключитесь в текстовый режим и выберите голос из библиотеки преобразования текста в речь.

4

Какой может быть продолжительность видеоролика с аватаром?

До 35 секунд аудио за одно создание. Для более длинных сценариев разделите их на несколько фрагментов. Ориентировочная продолжительность отображается по мере ввода текста, оплата производится посекундно.

5

Для чего можно использовать аватары, созданные с помощью ИИ?

К распространенным вариантам использования относятся пояснения к продуктам и рекламные ролики, озвучивание курсов и вводных материалов, видеоролики для социальных сетей, объявления и многоязычные версии сообщений — везде, где в противном случае потребовалась бы съемка выступления докладчика.

6

Какая модель используется для управления аватаром с искусственным интеллектом?

CreateVision AI использует технологию OmniHuman 1.5 от ByteDance, которая обеспечивает синхронизацию губ, а также движений головы и жестов на основе аудиоданных. Технические подробности см. на странице модели OmniHuman 1.5.

7

Какое фото лучше всего работает в генераторе видео с ИИ-аватаром?

Хорошо освещённый портрет анфас, где всё лицо видно и находится в фокусе. Тёмные очки, глубокая тень на лице, экстремальные ракурсы или слишком мелкое лицо в кадре — всё это снижает точность синхронизации губ.

8

Нужно ли записывать собственный голос?

Нет. Можно ввести текст и выбрать голос из встроенной библиотеки — в ней 60 голосов на 10 языках. Загрузка собственной записи тоже поддерживается, если вам так удобнее.

9

Могу ли я сам сняться в видео?

Да, и это самый частый сценарий. Загрузите своё фото, затем либо запишите собственный голос, либо введите сценарий и выберите голос из библиотеки. Результат — это вы, говорящие свои слова, без настройки камеры. Многие авторы хранят одно удачное фото и каждую неделю генерируют из него новые клипы.

10

Можно ли использовать говорящее фото с ИИ в коммерческих целях?

Да. Согласно Условиям использования CreateVision AI, созданный вами контент можно использовать в личных и коммерческих целях, с указанием CreateVision AI там, где это уместно. Вы несёте ответственность за наличие прав на фотографию и голос, которые вы загружаете, а также за соблюдение правил раскрытия информации об ИИ на платформе, где вы публикуете материал.

11

Раньше я добавлял себя в видео через Sora. Это то же самое?

Цель та же, механика другая. Здесь ваша фотография — это личность, а аудио или сценарий управляют речью, поэтому на выходе получается ролик с говорящей головой и синхронизацией губ, а не сцена, в которую вас поместили. Работает с любой одиночной фотографией, не требует видеорегистрации и не зависит от доступности другого приложения.

Создайте свою первую говорящую фотографию с ИИ

Начните создавать