AI टॉकिंग फोटो

एक पोर्ट्रेट और एक ऑडियो ट्रैक अपलोड करें (35s तक), या स्क्रिप्ट टाइप करें और आवाज़ चुनें, और OmniHuman 1.5 फोटो को सिंक किए हुए होठों और स्वाभाविक गति के साथ एक बोलते वीडियो में बदल देता है। इसमें खुद को फीचर करने के लिए अपनी फोटो का इस्तेमाल करें।

0 / 2,000
130 cr/s · ≤35s

एक फ़ोटो से बात करते वीडियो तक

एक तस्वीर और एक स्क्रिप्ट मिलकर बनती है जीवंत प्रवक्ता — होंठ, भाव और हाव-भाव सिंक। न कैमरा, न स्टूडियो।

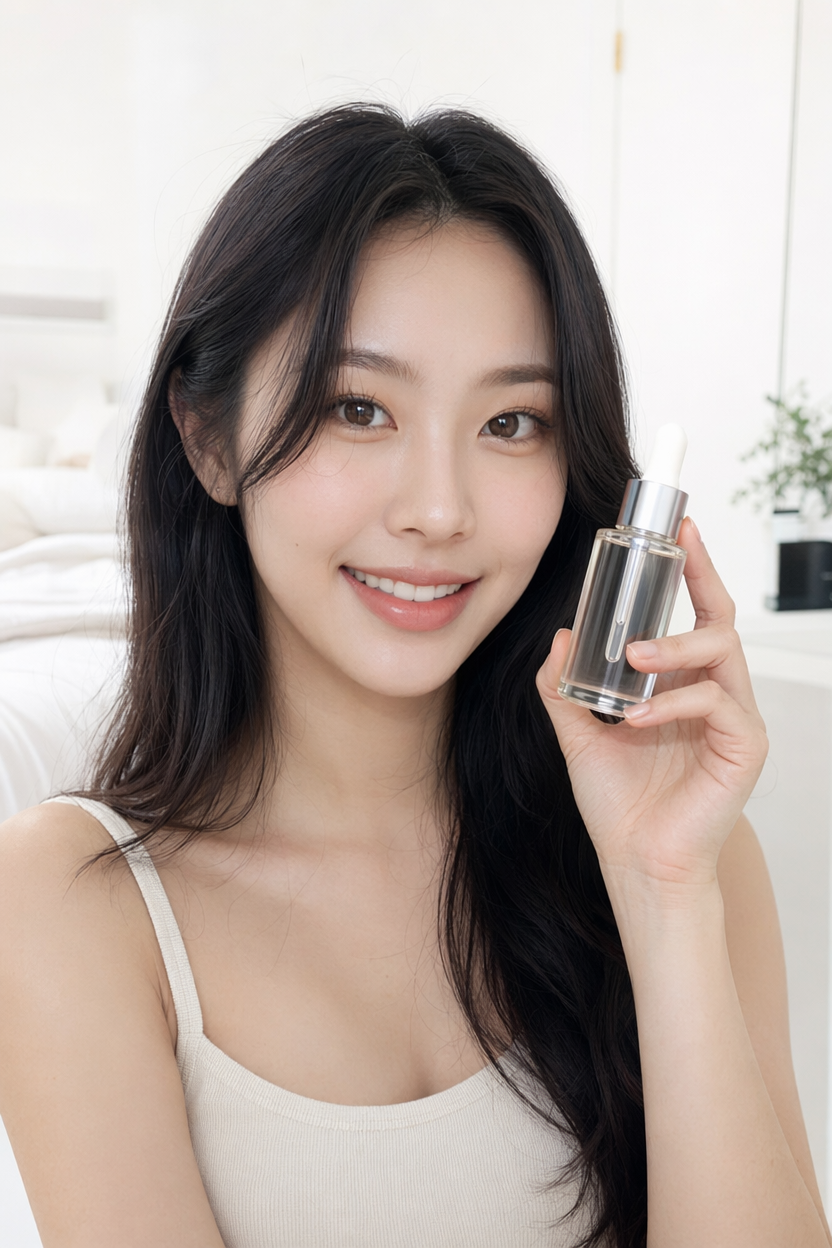
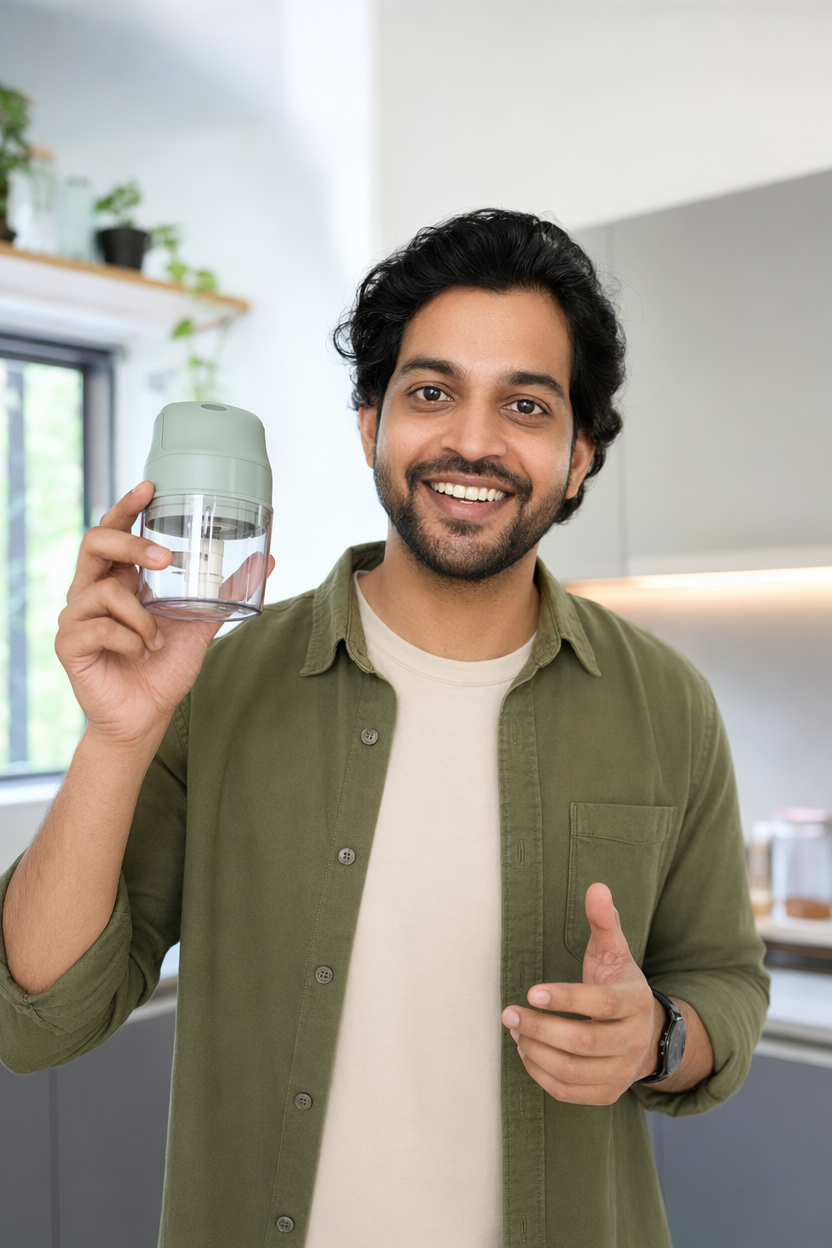
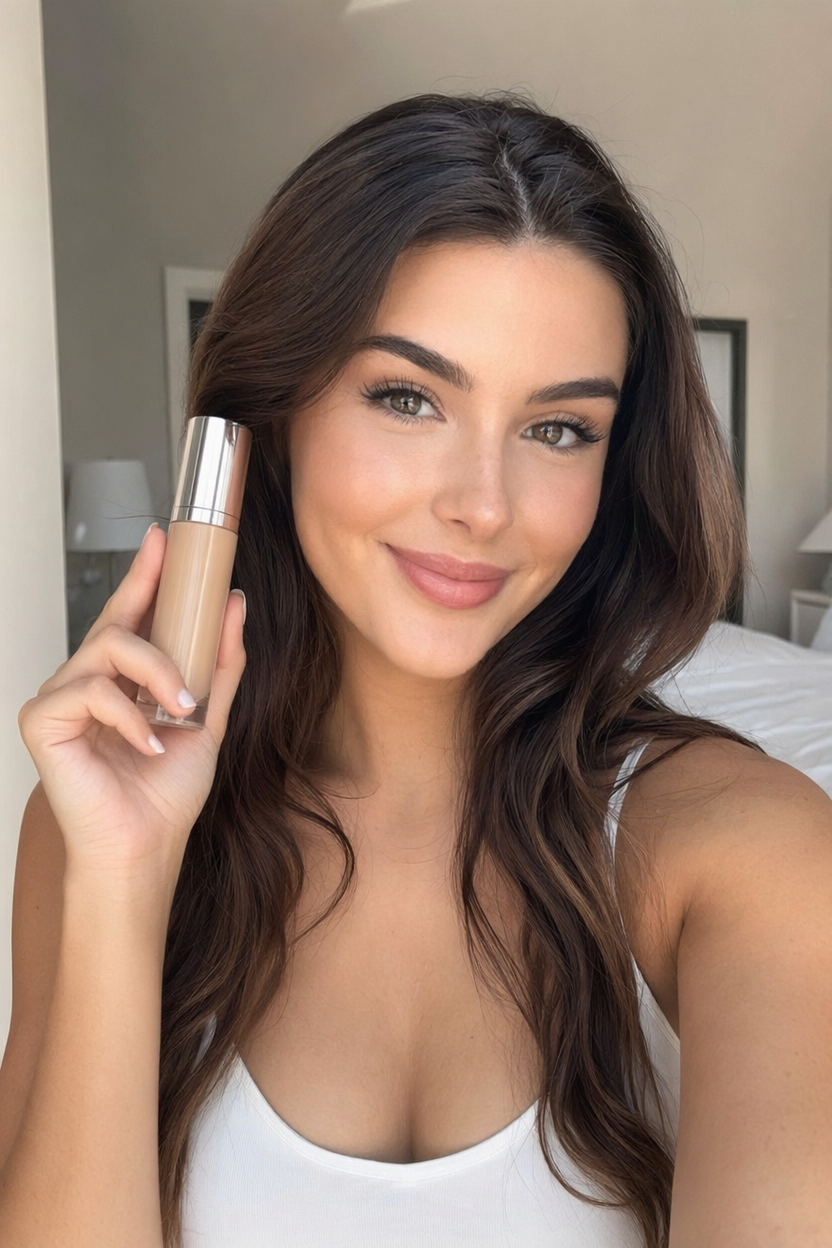
मूल छविOriginal portrait photo of a beauty creator holding a skincare product
स्क्रिप्ट

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

AI अवतार वीडियो

किसी भी फोटो को बोलने दें, आपकी अपनी भी

एक संपूर्ण AI टॉकिंग फोटो (डिजिटल ह्यूमन) जेनरेटर: एक पोर्ट्रेट और एक ऑडियो क्लिप अपलोड करें, या स्क्रिप्ट टाइप करें और एक आवाज़ चुनें, और सिंक किए हुए होठों, स्वाभाविक भावों और इशारों के साथ एक सजीव बोलता वीडियो पाएं। प्रस्तुतकर्ता बनने के लिए अपनी खुद की फोटो इस्तेमाल करें। ByteDance OmniHuman 1.5 द्वारा संचालित, किसी कैमरा, अभिनेता या स्टूडियो की ज़रूरत नहीं।

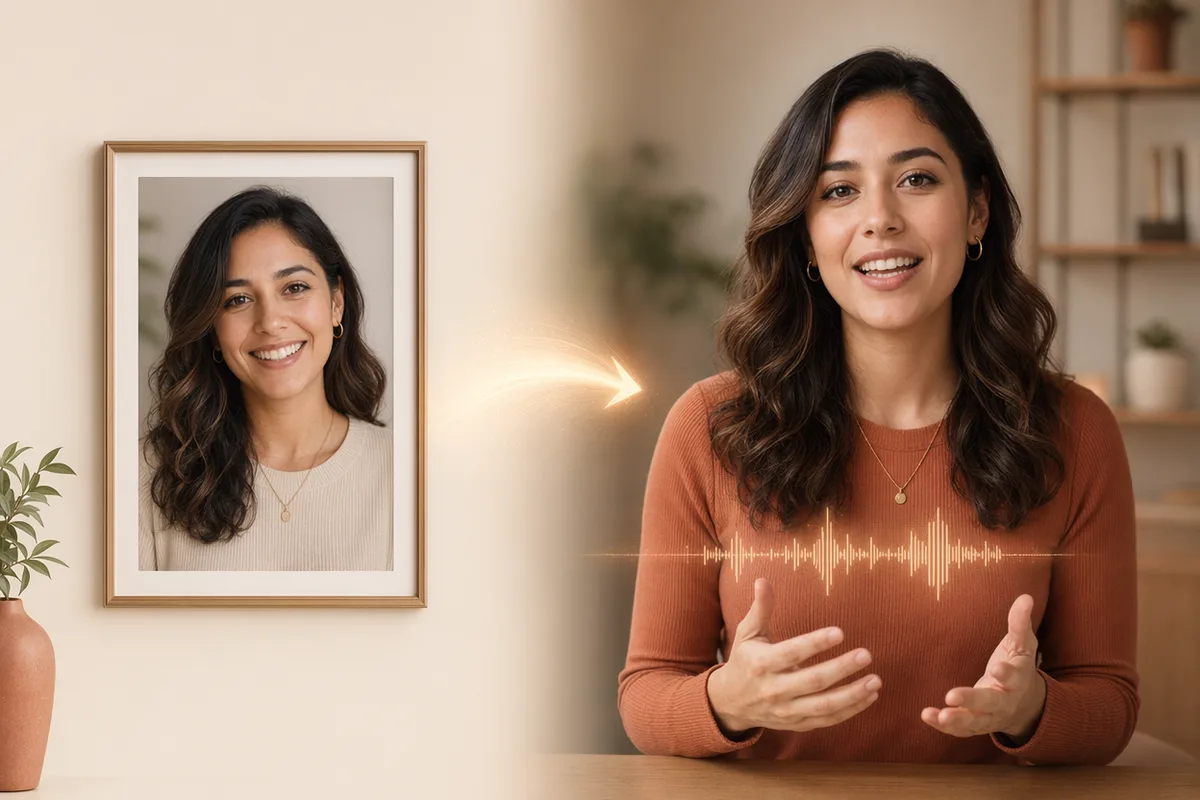
एक फ्रेम की गई पोर्ट्रेट फोटो उसी महिला के बोलते AI अवतार में बदलती हुई, बीच में एक ऑडियो वेवफॉर्म के साथ

खुद उसमें अभिनय करें, या एक डिजिटल प्रवक्ता बनाएं

कोई फिल्मांकन नहीं, कोई अभिनेता नहीं, कोई ग्रीन स्क्रीन नहीं। अपनी एक साफ फोटो अपलोड करें और आप वही प्रस्तुतकर्ता बन जाते हैं जो आपकी स्क्रिप्ट पढ़ता है, आपकी अपनी आवाज़ में या लाइब्रेरी की आवाज़ में। या किसी ऐसे व्यक्ति की फोटो इस्तेमाल करें जिसने आपको अनुमति दी है, और प्रोडक्ट एक्सप्लेनर, कोर्स इंट्रो, घोषणाओं और विज्ञापनों के लिए एक दोबारा इस्तेमाल होने वाला डिजिटल होस्ट बनाएं। बिना दोबारा शूट किए कभी भी नई पंक्तियां जेनरेट करें।
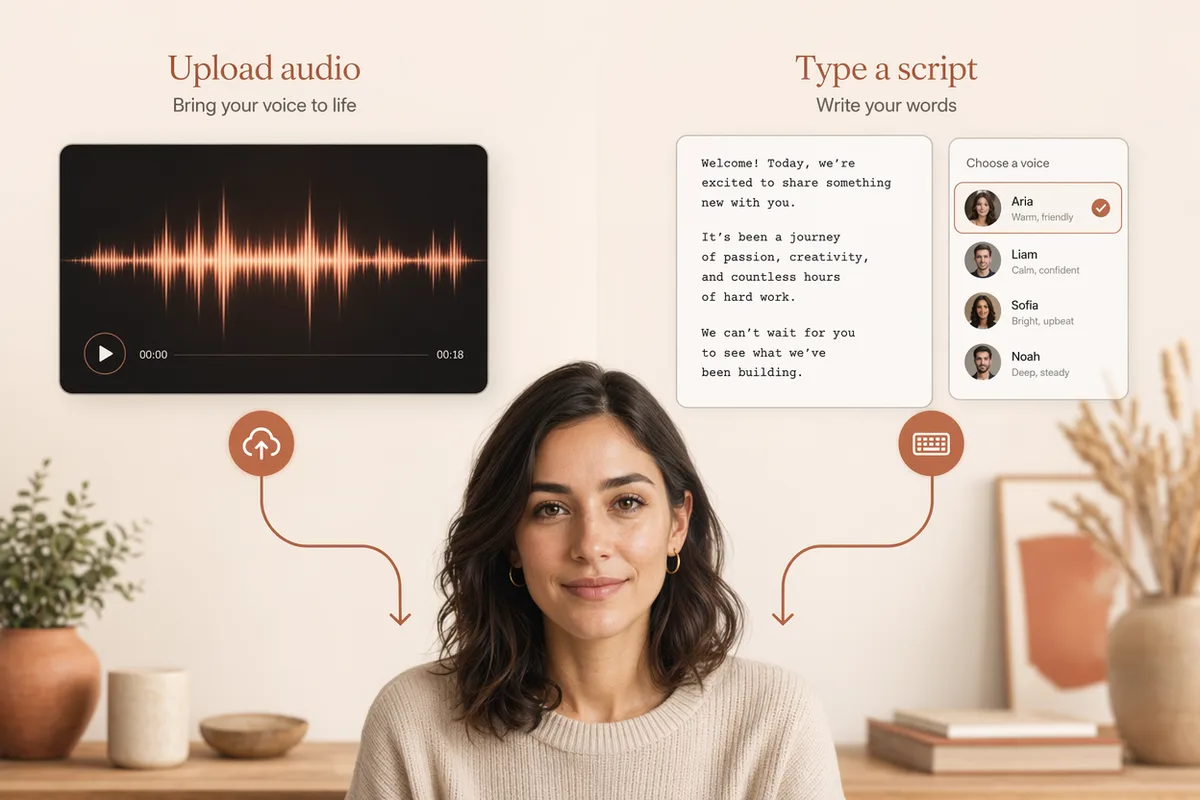
AI टॉकिंग फोटो के लिए दो इनपुट: एक अपलोड की गई ऑडियो वेवफॉर्म और वॉइस पिकर के साथ टाइप की गई स्क्रिप्ट

दो तरीके हैं: ऑडियो अपलोड करें या स्क्रिप्ट टाइप करें।

क्या आपके पास पहले से ही वॉइस रिकॉर्डिंग है? इसे अपलोड करें और आपका अवतार इसके साथ लिप-सिंक करेगा। ऑडियो नहीं है? टेक्स्ट मोड पर स्विच करें — अवतार को जो बोलना है उसे टाइप करें, बिल्ट-इन टेक्स्ट-टू-स्पीच लाइब्रेरी से एक आवाज़ चुनें, और स्क्रिप्ट आपके लिए ड्राइविंग ऑडियो में बदल जाएगी। जनरेट करने से पहले अनुमानित लंबाई और क्रेडिट लागत दिखाई जाएगी।

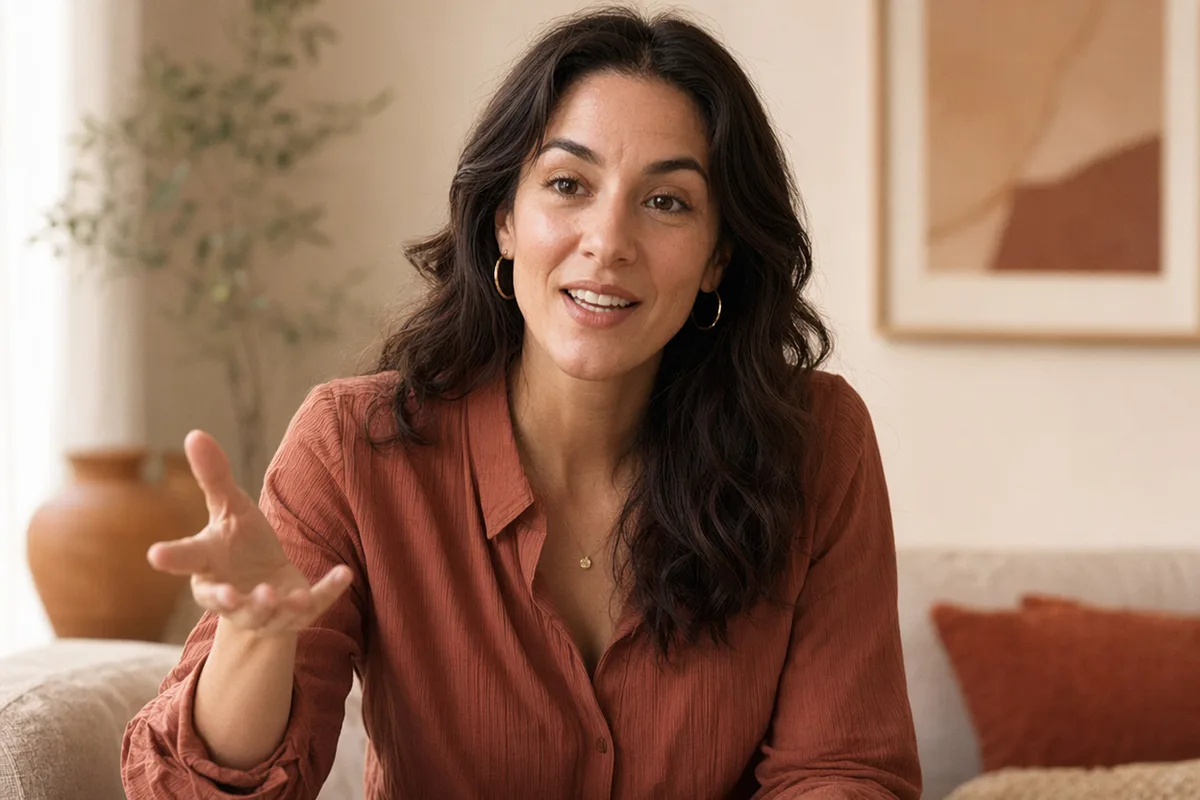
स्वाभाविक हाथ के इशारों के साथ कैमरे से बात करती महिला की AI टॉकिंग फोटो स्टिल

वास्तविक जैसा - केवल हिलता हुआ मुंह नहीं

ओम्नीह्यूमन 1.5 ऑडियो की लय, स्वर और अर्थ को समझकर सिर की हलचल, हावभाव और हाथों के इशारों को सटीक लिप-सिंक के साथ नियंत्रित करता है, साथ ही व्यक्ति की पहचान और प्रकाश व्यवस्था को भी बरकरार रखता है। इसका परिणाम यह होता है कि प्रस्तुति किसी वास्तविक वक्ता की तरह लगती है, न कि किसी स्थिर चित्र की तरह जिसमें केवल होंठ हिल रहे हों।

लिविंग रूम में एक छोटी सोशल क्लिप प्रस्तुत करता AI टॉकिंग फोटो प्रस्तुतकर्ता

मार्केटिंग, प्रशिक्षण और सोशल मीडिया के लिए बनाया गया

विज्ञापन और लैंडिंग पेज के लिए प्रवक्ता क्लिप, प्रशिक्षण के लिए नैरेटेड लेसन और ऑनबोर्डिंग, सोशल मीडिया के लिए टॉकिंग-हेड पोस्ट या एक ही संदेश के बहुभाषी संस्करण तैयार करें। प्रत्येक जनरेशन अपने इनपुट के साथ इतिहास में सहेजी जाती है, जिससे आप तेजी से बदलाव और विभिन्न रूप तैयार कर सकते हैं।

AI टॉकिंग फोटो के लिए तैयार पोर्ट्रेट

CreateVision AI पर बने प्रेजेंटर-स्टाइल पोर्ट्रेट — ऑडियो जोड़ते ही इनमें से कोई भी बोलता हुआ अवतार वीडियो चला सकता है।

एक ब्यूटी क्रिएटर का एआई अवतार स्किनकेयर सीरम प्रस्तुत कर रहा है।
एक स्मार्टफोन प्रस्तुत करते हुए तकनीकी समीक्षक का एआई अवतार
एक लाइफस्टाइल क्रिएटर का एआई अवतार, जिसके हाथ में कॉफी का कप है।
स्नीकर समीक्षक का एआई अवतार एक जूते का प्रदर्शन कर रहा है।
हैंडबैग लिए एक फैशन डिजाइनर का एआई अवतार
एक वेलनेस क्रिएटर का एआई अवतार सप्लीमेंट्स प्रस्तुत करता है।
परफ्यूम की बोतल लिए एक ब्यूटी क्रिएटर का एआई अवतार
रसोई के उपकरणों से लैस एक घरेलू खाना पकाने वाले निर्माता का एआई अवतार

इस AI टॉकिंग फोटो जेनरेटर के पीछे का मॉडल

इस पेज पर lip sync, भाव और शरीर की हलचल OmniHuman 1.5 चलाता है।

AI टॉकिंग फोटो विशिष्टताएं

इनपुटएक पोर्ट्रेट फ़ोटो, और साथ में या तो अपलोड की गई ऑडियो फ़ाइल या टाइप की गई स्क्रिप्ट।
किसकी फोटोआपकी अपनी, या किसी ऐसे व्यक्ति की जिसने आपको अनुमति दी है। फोटो और आवाज़ दोनों इस्तेमाल के लिए आपकी होनी चाहिए।
पोर्ट्रेट के लिए सुझावसामने की ओर चेहरा, अच्छी रोशनी, पूरा चेहरा दिखता हुआ और फ़ोकस में। धूप का चश्मा और गहरी छाया lip sync की सटीकता घटाते हैं।
ऑडियो की लंबाईप्रति जनरेशन 35 सेकंड तक — करीब 85 बोले गए शब्द।
आवाज़ों की लाइब्रेरी10 भाषाओं में 60 बिल्ट-इन आवाज़ें, जनरेट करने से पहले प्रीव्यू सुन सकते हैं।
मॉडलOmniHuman 1.5, जो lip sync, चेहरे के भाव और सिर व शरीर की स्वाभाविक हरकत चलाता है।
लागतबाकी वीडियो जनरेशन की तरह आउटपुट के प्रति सेकंड बिलिंग; जनरेट करने से पहले दिखाया जाता है।
आउटपुटडाउनलोड करने योग्य क्लिप, जो सोर्स पोर्ट्रेट और स्क्रिप्ट के साथ आपकी हिस्ट्री में सेव होती है।

अपनी खुद की AI टॉकिंग फोटो में कैसे अभिनय करें

आपकी फोटो, आपके शब्द, एक क्लिप।

  1. 1

    अपनी एक फोटो अपलोड करें

    एक साफ, सामने की ओर देखती फोटो सबसे अच्छी काम करती है: फोन सेल्फी, हेडशॉट, या किसी वीडियो का एक फ्रेम। टॉकिंग फोटो AI इसी एक फ्रेम से आपका चेहरा पढ़ता है।

  2. 2

    अपनी आवाज़ जोड़ें

    खुद को रिकॉर्ड करें और ऑडियो अपलोड करें, या अपनी स्क्रिप्ट टाइप करें और 60 बिल्ट-इन आवाज़ों में से एक चुनें। ऑडियो 35 सेकंड तक चल सकता है।

  3. 3

    जेनरेट करें, फिर खुद को दोबारा इस्तेमाल करें

    मॉडल होठों, भाव और सिर की स्वाभाविक गति को ऑडियो के साथ सिंक करता है। वही फोटो रखें और जब भी ज़रूरत हो नई पंक्तियां जेनरेट करें, बिना दोबारा शूट किए।

AI टॉकिंग फोटो के लिए स्क्रिप्ट कैसे लिखें

यहाँ कोई इमेज प्रॉम्प्ट नहीं है — काम पोर्ट्रेट और ऑडियो करते हैं। आप जो लिखते हैं वह स्क्रिप्ट है, और स्क्रिप्ट के फ़ैसले ही तय करते हैं कि नतीजा स्वाभाविक लगेगा या नहीं।

1

पहली पंक्ति

शुरुआत कुछ छोटा रखें। पहला सेकंड ही वह जगह है जहाँ lip sync सबसे ज़्यादा दिखता है।

सुनिए — एक छोटी-सी बात।

2

वाक्य की लंबाई

वाक्य करीब 15 शब्दों से कम रखें। लंबे उपवाक्य अस्वाभाविक ठहराव पैदा करते हैं।

इस सीरम में दो ही चीज़ें हैं। पूरा फ़ॉर्मूला बस इतना है।

3

विराम-चिह्न

कॉमा और पूर्ण विराम साँस बन जाते हैं। उन्हें वहीं लगाएँ जहाँ आप सचमुच रुकेंगे।

यह काम करता है — और इसमें दस सेकंड लगते हैं।

4

लंबाई का बजट

करीब 2.5 शब्द प्रति सेकंड। जितनी लंबी क्लिप चाहिए, उतना ही लिखें।

35 सेकंड की क्लिप के लिए ~85 शब्द

अस्पष्ट

हमारा क्रांतिकारी उत्पाद उत्कृष्टता की तलाश करने वाले विवेकशील ग्राहकों हेतु अद्वितीय परिणाम प्रदान करने के लिए अत्याधुनिक प्रौद्योगिकी का उपयोग करता है।

स्पष्ट

यही वह हिस्सा है जिसके बारे में लोग हमेशा पूछते हैं। दो ही चीज़ें, कोई भराव नहीं। फ़र्क आपको करीब एक हफ़्ते में दिख जाएगा।

यह क्यों काम करता है

पहला 19 शब्दों का एक ही वाक्य है, पूरी तरह अमूर्त — अवतार इसे सपाट, बिना साँस लिए एकसार लहजे में बोलता है, क्योंकि रुकने की कोई जगह ही नहीं है। दूसरा तीन छोटे वाक्यों का है जिनमें ज़ोर के स्वाभाविक बिंदु हैं, और यही बोलने को इंसानी बना देता है।

अस्पष्ट

नमस्ते और हमारे चैनल में आपका स्वागत है जहाँ आज हम स्किनकेयर रूटीन के बारे में उन पाँच सबसे ज़रूरी बातों पर चर्चा करेंगे जो आपको ज़रूर जाननी चाहिए।

स्पष्ट

स्किनकेयर की पाँच बातें। पहली वही है जिसमें लोग सबसे ज़्यादा गलती करते हैं।

यह क्यों काम करता है

लंबी, बिना रुके चलने वाली शुरुआत में lip sync सबसे ज़्यादा भटकता है, क्योंकि मॉडल के पास टिकने के लिए कोई विराम-चिह्न नहीं होता। छोटा हुक उसे साफ़ ज़ोर के बिंदु देता है और ध्यान भी बेहतर बाँधता है।

छोड़ने लायक आदतें

  • ऐसा पोर्ट्रेट इस्तेमाल करना जिसमें चेहरा छोटा, तिरछा या आंशिक रूप से छाया में हो। lip sync की सटीकता सीधे इस बात पर निर्भर करती है कि सोर्स फ्रेम में मुँह कितना साफ़ दिख रहा है।
  • ऑडियो की सीमा से ज़्यादा लिख देना। जनरेशन 35 सेकंड ऑडियो पर रुक जाता है — इससे लंबी स्क्रिप्ट कट जाती है, इसलिए उसे हिस्सों में बाँटें और वही पोर्ट्रेट दोबारा इस्तेमाल करें।
  • भारी तकनीकी शब्दावली। नंबर, संक्षिप्ताक्षर और लंबे प्रोडक्ट नाम ही वे जगहें हैं जहाँ सिंथेटिक आवाज़ सबसे साफ़ तौर पर मशीनी लगती है। उन्हें वैसे ही लिखें जैसे आप बोलकर कहेंगे।

AI अवतार वीडियो जेनरेटर से आगे

बोलते अवतार एक तरह का आउटपुट हैं। इमेज और वीडियो जेनरेशन भी इसी अकाउंट से चलते हैं।

AI अवतार वीडियो पर काम के संसाधन

AI टॉकिंग फोटो की कीमत और मुफ़्त क्रेडिट

टॉकिंग फोटो वीडियो अन्य वीडियो आउटपुट की तरह प्रति सेकंड बिल होते हैं। नए अकाउंट को इसे आजमाने के लिए 200 मुफ्त क्रेडिट मिलते हैं।

निःशुल्क

$0

शुरुआत करने के लिए एकदम सही

  • 200 वेलकम क्रेडिट, प्रतिदिन अधिकतम 80
  • Z Image Turbo 0 क्रेडिट पर ड्राफ्ट करता है
  • स्टैंडर्ड जेनरेशन स्पीड
  • जेनरेशन हिस्ट्री शामिल है
शुरू करें

Premium

सबसे लोकप्रिय
$29/month

वार्षिक रूप से बिल किया गया · $240/वर्ष

  • प्रति माह 8,000 क्रेडिट, कोई दैनिक सीमा नहीं
  • सभी प्रीमियम मॉडल — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • 5x जेनरेशन स्पीड, प्राथमिकता कतार
  • AI प्रॉम्प्ट एन्हांसमेंट
Premium में अपग्रेड करें

Ultimate

$59/month

वार्षिक रूप से बिल किया गया · $468/वर्ष

  • प्रति माह 18,000 क्रेडिट, कोई दैनिक सीमा नहीं
  • 4K रेज़ोल्यूशन तक HD जेनरेशन
  • प्राथमिकता सपोर्ट
  • सबसे तेज़ कतार और नए मॉडल्स तक जल्दी पहुँच
Ultimate में अपग्रेड करें

AI टॉकिंग फोटो — अक्सर पूछे जाने वाले सवाल

1

AI टॉकिंग फोटो क्या है?

AI टॉकिंग फोटो, जिसे AI अवतार या डिजिटल ह्यूमन भी कहा जाता है, एक फोटो और एक आवाज़ से बना किसी व्यक्ति का जेनरेट किया हुआ बोलता वीडियो है। फिल्माने की बजाय, आप एक पोर्ट्रेट और ऑडियो (या स्क्रिप्ट + आवाज़) देते हैं, और मॉडल एक सजीव बोलने वाला प्रदर्शन एनिमेट करता है — जिसे डिजिटल प्रस्तुतकर्ता, प्रवक्ता या वर्णनकर्ता के रूप में इस्तेमाल किया जाता है।

2

इसे बनाने के लिए मुझे क्या चाहिए?

एक स्पष्ट, सामने से खींची गई पोर्ट्रेट तस्वीर, साथ ही एक ऑडियो क्लिप (mp3/wav) या टेक्स्ट मोड में, आप जो स्क्रिप्ट बोलना चाहते हैं और बिल्ट-इन लाइब्रेरी से चुनी गई एक आवाज़। इतना ही एक बोलने वाले अवतार का वीडियो बनाने के लिए पर्याप्त है।

3

क्या मैं अपनी आवाज़ का इस्तेमाल कर सकता हूँ?

जी हां। अपनी ऑडियो रिकॉर्डिंग अपलोड करें और अवतार उसके साथ लिप-सिंक करेगा। अगर आपके पास रिकॉर्डिंग नहीं है, तो टेक्स्ट मोड पर स्विच करें और टेक्स्ट-टू-स्पीच लाइब्रेरी से कोई आवाज़ चुनें।

4

अवतार वीडियो कितना लंबा हो सकता है?

प्रति जनरेशन अधिकतम 35 सेकंड का ऑडियो। लंबी स्क्रिप्ट के लिए, उन्हें कई क्लिप में विभाजित करें। अनुमानित अवधि टाइप करते समय दिखाई देगी, और आपसे ऑडियो के प्रति सेकंड के हिसाब से शुल्क लिया जाएगा।

5

मैं एआई अवतारों का उपयोग किस लिए कर सकता हूँ?

इसके सामान्य उपयोगों में उत्पाद संबंधी जानकारी और विज्ञापन, पाठ्यक्रम और ऑनबोर्डिंग संबंधी विवरण, सोशल मीडिया पर चर्चा के लिए क्लिप, घोषणाएं और संदेश के बहुभाषी संस्करण शामिल हैं - ऐसी कोई भी जगह जहां आपको अन्यथा किसी प्रस्तुतकर्ता को फिल्माने की आवश्यकता होती है।

6

एआई अवतार को कौन सा मॉडल शक्ति प्रदान करता है?

CreateVision AI, ByteDance के OmniHuman 1.5 का उपयोग करता है, जो ऑडियो से लिप-सिंक, सिर की गति और हाव-भाव को नियंत्रित करता है। तकनीकी विवरण के लिए OmniHuman 1.5 मॉडल पेज देखें।

7

AI अवतार वीडियो जेनरेटर में कैसा फ़ोटो सबसे अच्छा चलता है?

अच्छी रोशनी वाला, सामने से लिया गया पोर्ट्रेट जिसमें पूरा चेहरा दिखे और फ़ोकस में हो। धूप का चश्मा, चेहरे पर गहरी छाया, बहुत तिरछे एंगल, या फ्रेम में बहुत छोटा चेहरा — ये सब lip-sync की सटीकता घटा देते हैं।

8

क्या मुझे अपनी आवाज़ रिकॉर्ड करनी पड़ेगी?

नहीं। आप स्क्रिप्ट टाइप करके बिल्ट-इन लाइब्रेरी से आवाज़ चुन सकते हैं, जिसमें 10 भाषाओं की 60 आवाज़ें हैं। अगर आप अपनी रिकॉर्डिंग ही इस्तेमाल करना चाहें, तो उसे अपलोड करने की सुविधा भी है।

9

क्या मैं खुद वीडियो में अभिनय कर सकता हूं?

हां, और यह सबसे आम इस्तेमाल है। अपनी एक फोटो अपलोड करें, फिर या तो अपनी आवाज़ रिकॉर्ड करें या स्क्रिप्ट टाइप करके लाइब्रेरी की आवाज़ चुनें। नतीजा आप होते हैं, आपके शब्द बोलते हुए, बिना कैमरा सेटअप के। कई क्रिएटर एक अच्छी फोटो रखते हैं और हर हफ्ते उससे नई क्लिप जेनरेट करते हैं।

10

क्या मैं AI टॉकिंग फोटो का व्यावसायिक इस्तेमाल कर सकता हूं?

हाँ। CreateVision AI की सेवा की शर्तों के अनुसार, आपके द्वारा जनरेट की गई सामग्री का इस्तेमाल निजी और व्यावसायिक उद्देश्यों के लिए किया जा सकता है, जहाँ उचित हो वहाँ CreateVision AI को श्रेय देते हुए। आपके द्वारा अपलोड की गई फोटो और आवाज़ के अधिकार होना, तथा जिस प्लेटफ़ॉर्म पर आप प्रकाशित करते हैं वहाँ के AI-प्रकटीकरण नियमों का पालन करना — ये ज़िम्मेदारी आपकी है।

11

मैं पहले Sora की मदद से खुद को वीडियो में डालता था। क्या यह वही चीज़ है?

लक्ष्य वही है, तरीका अलग है। यहाँ आपकी फोटो ही आपकी पहचान है और आपका ऑडियो या स्क्रिप्ट बोलने को चलाता है, इसलिए नतीजा एक टॉकिंग-हेड क्लिप होता है जिसमें लिप सिंक होता है, न कि ऐसा दृश्य जिसमें आपको डाल दिया जाता है। यह किसी भी एक फोटो से काम करता है, किसी वीडियो एनरोलमेंट की ज़रूरत नहीं, और यह किसी दूसरे ऐप के उपलब्ध रहने पर निर्भर नहीं करता।

अपनी पहली AI टॉकिंग फोटो बनाएं

बनाना शुरू करें