Ảnh biết nói AI

Tải lên một ảnh chân dung và một đoạn âm thanh (tối đa 35s), hoặc gõ kịch bản và chọn một giọng, và OmniHuman 1.5 sẽ biến bức ảnh thành video nói với môi đồng bộ và chuyển động tự nhiên. Dùng ảnh của chính bạn để tự mình đóng vai chính.

0 / 2,000
130 cr/s · ≤35s

Từ một bức ảnh đến video biết nói

Một bức chân dung cùng kịch bản trở thành người phát ngôn sống động — khẩu hình, biểu cảm và cử chỉ đồng bộ. Không cần máy quay, không cần phòng thu.

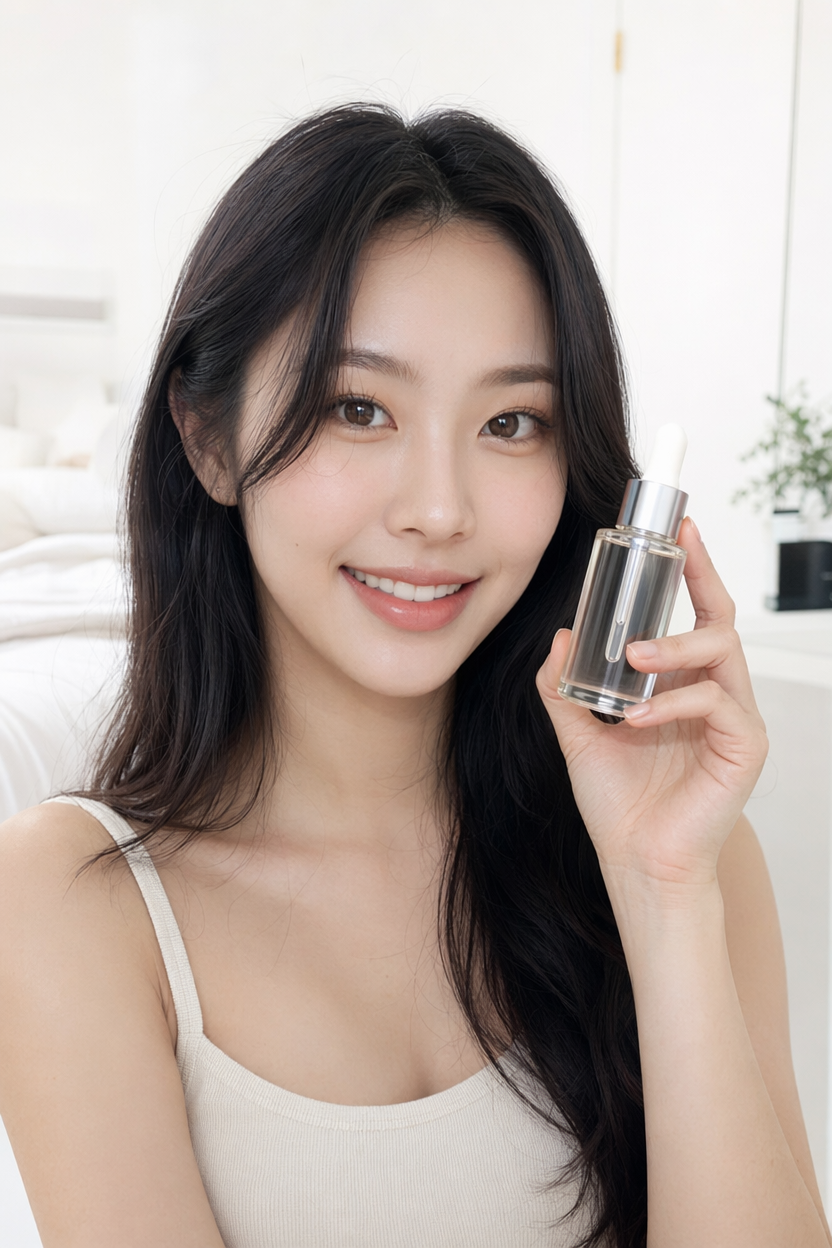
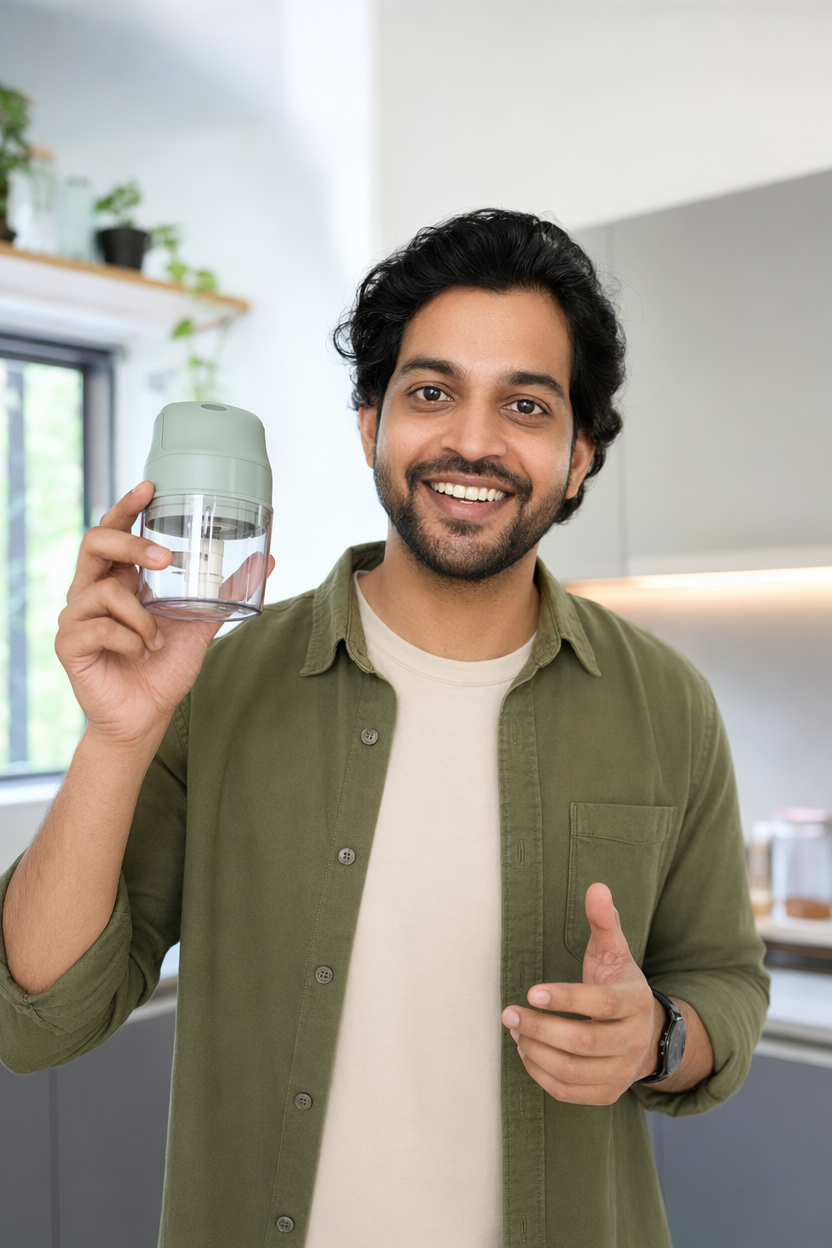
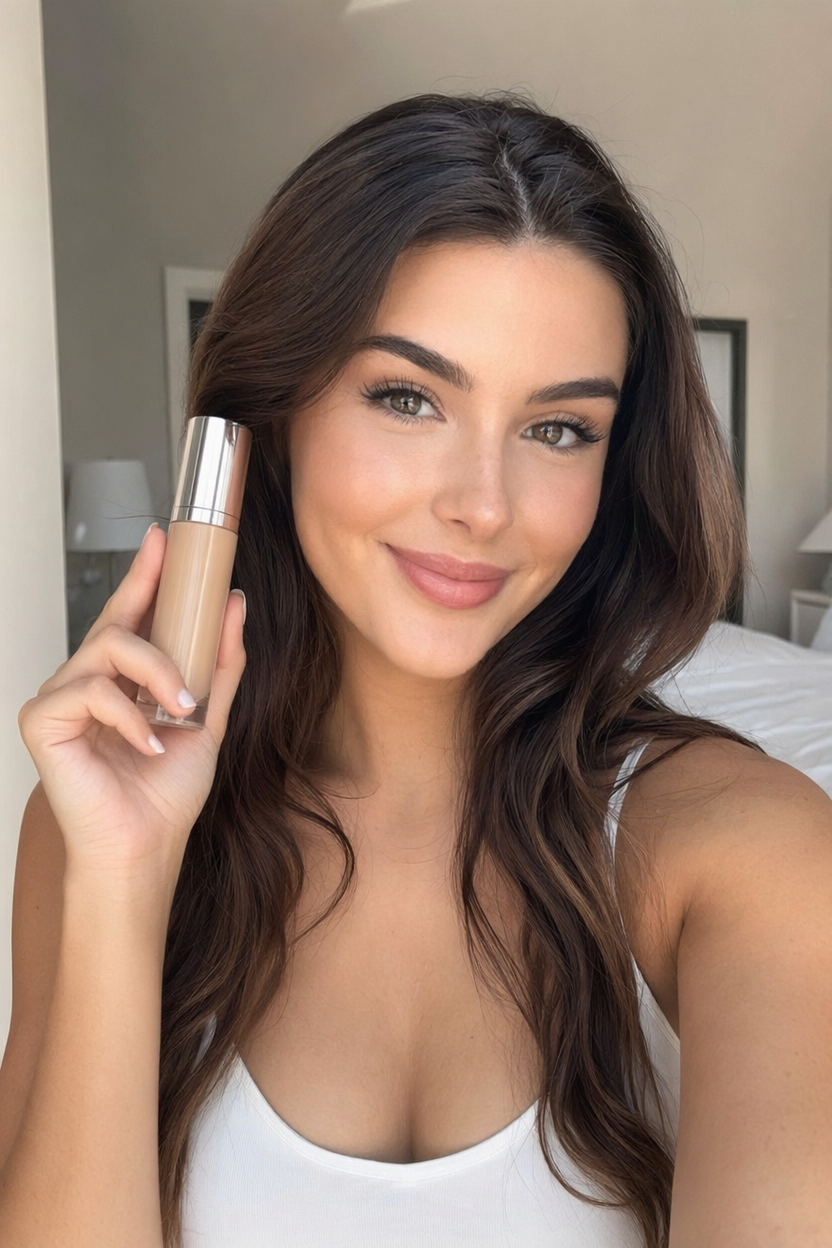
Ảnh gốcOriginal portrait photo of a beauty creator holding a skincare product
Kịch bản

Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.

Video avatar AI

Biến mọi bức ảnh thành ảnh biết nói, kể cả ảnh của bạn

Trình tạo ảnh biết nói AI (con người số) hoàn chỉnh: tải lên một ảnh chân dung và một đoạn âm thanh, hoặc nhập kịch bản và chọn giọng, rồi nhận video biết nói sống động với môi đồng bộ, biểu cảm và cử chỉ tự nhiên. Dùng ảnh của chính bạn để làm người trình bày. Được vận hành bởi ByteDance OmniHuman 1.5, không cần máy quay, diễn viên hay studio.

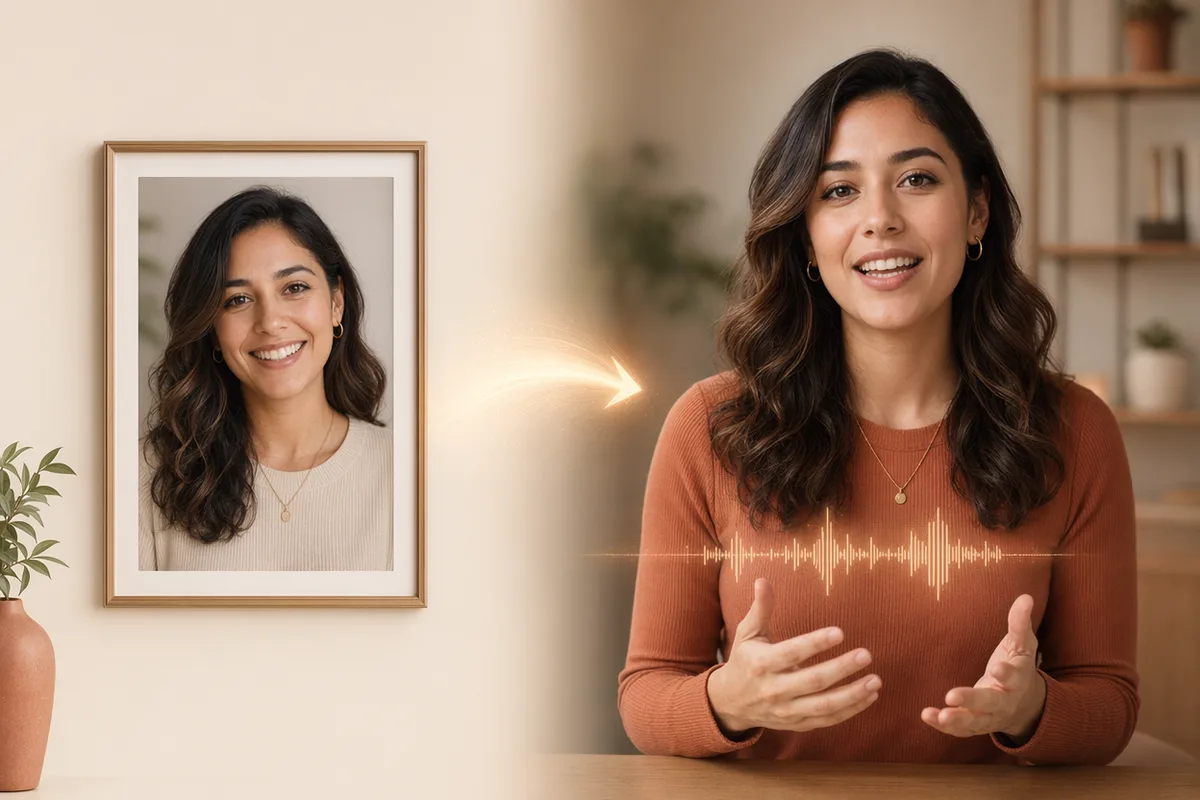
Ảnh chân dung trong khung biến thành avatar AI biết nói của cùng người phụ nữ, với dạng sóng âm thanh ở giữa

Tự vào vai chính, hoặc xây dựng người phát ngôn số

Không quay phim, không diễn viên, không phông xanh. Tải lên một ảnh rõ nét của chính bạn và bạn trở thành người trình bày đọc kịch bản của bạn, bằng giọng của bạn hoặc giọng trong thư viện. Hoặc dùng ảnh của người đã cho bạn phép và xây dựng một người dẫn số tái sử dụng cho video giải thích sản phẩm, mở đầu khóa học, thông báo và quảng cáo. Tạo lại các câu thoại mới bất cứ lúc nào mà không cần quay lại.
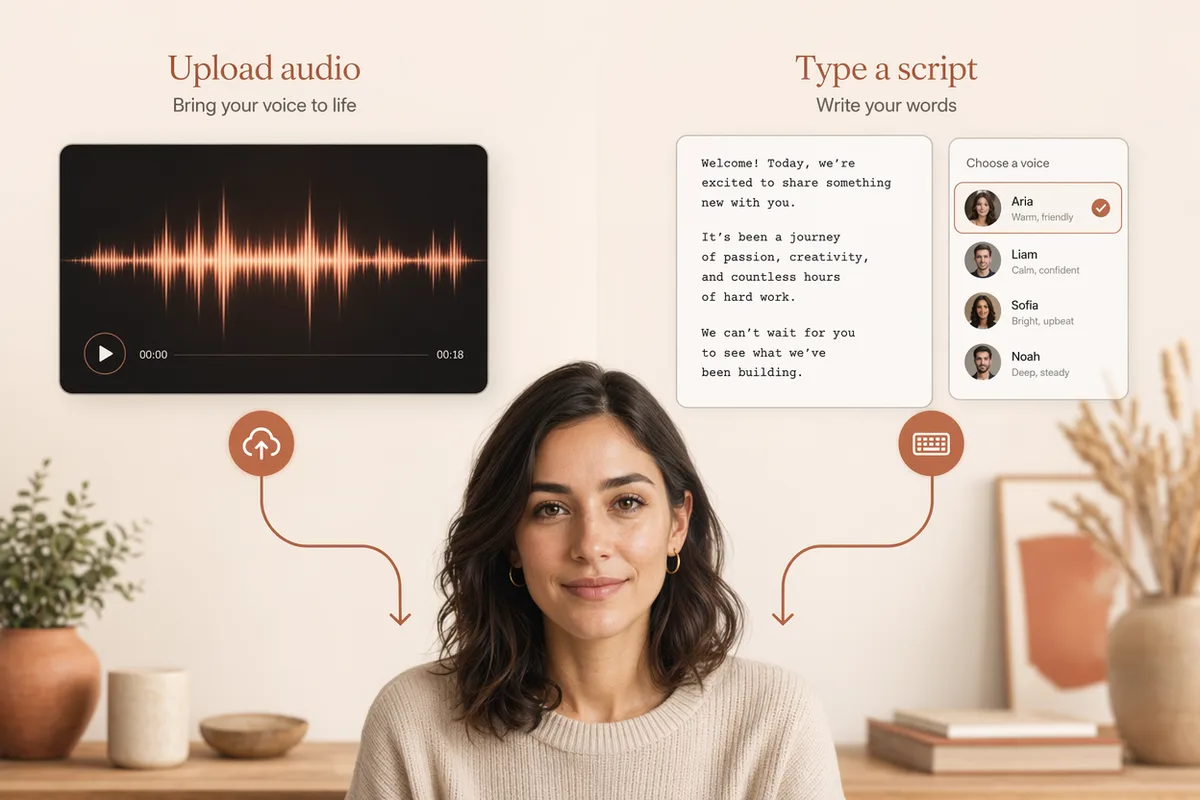
Hai đầu vào cho ảnh biết nói AI: dạng sóng âm thanh đã tải lên và kịch bản đã nhập với bộ chọn giọng

Có hai cách tham gia: tải lên bản ghi âm hoặc nhập kịch bản.

Bạn đã có bản ghi âm giọng nói? Hãy tải lên và hình đại diện sẽ khớp khẩu hình với giọng nói đó. Không có âm thanh? Chuyển sang chế độ văn bản — nhập những gì hình đại diện nên nói, chọn giọng nói từ thư viện chuyển văn bản thành giọng nói tích hợp sẵn, và kịch bản sẽ được tổng hợp thành âm thanh điều khiển cho bạn. Thời lượng ước tính và chi phí tín dụng sẽ được hiển thị trước khi bạn bắt đầu tạo.

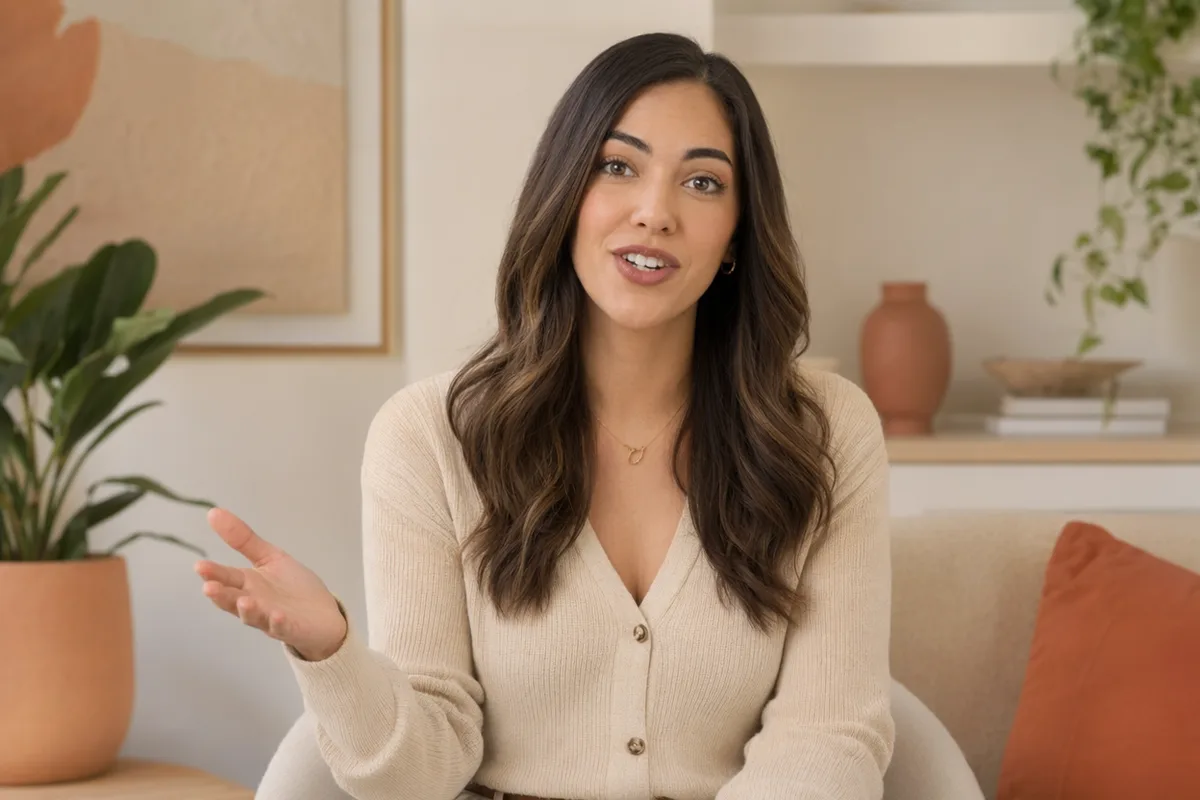
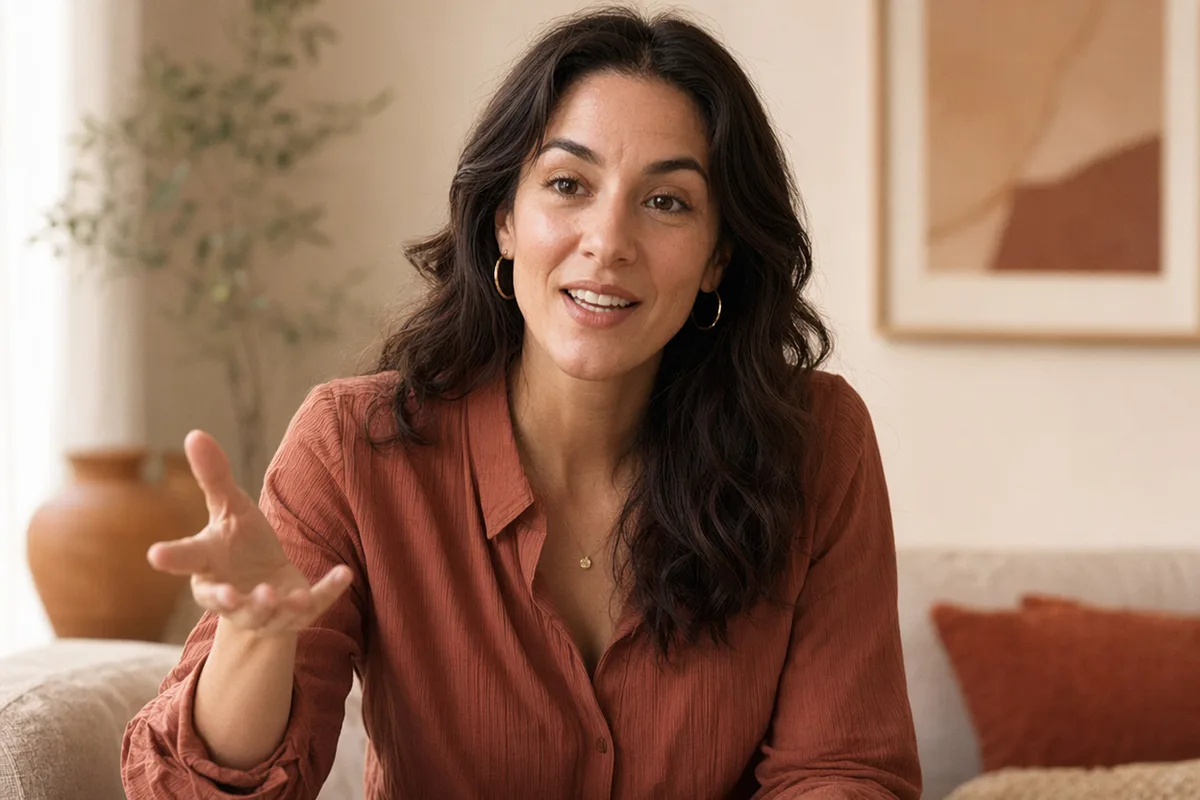
Ảnh tĩnh của ảnh biết nói AI với người phụ nữ nói vào camera cùng cử chỉ tay tự nhiên

Sống động như thật - không chỉ là một cái miệng biết cử động.

OmniHuman 1.5 đọc nhịp điệu, ngữ điệu và ý nghĩa của âm thanh để điều khiển chuyển động đầu, tư thế và cử chỉ tay, đồng thời khớp môi chính xác, trong khi vẫn giữ nguyên danh tính và ánh sáng của người nói. Kết quả mang lại hiệu quả giống như một người thuyết trình thực thụ hơn là một bức chân dung tĩnh với miệng được hoạt họa.

Người trình bày ảnh biết nói AI trong phòng khách đang trình bày một clip mạng xã hội ngắn

Được thiết kế cho mục đích tiếp thị, đào tạo và truyền thông xã hội.

Tạo các đoạn video người phát ngôn cho quảng cáo và trang đích, các bài học có lời thuyết minh và hướng dẫn đào tạo, bài đăng có người dẫn chương trình cho mạng xã hội, hoặc các phiên bản đa ngôn ngữ của cùng một thông điệp. Mỗi thế hệ đều được lưu lại lịch sử với các dữ liệu đầu vào, vì vậy bạn có thể lặp lại và tạo ra các biến thể một cách nhanh chóng.

Chân dung sẵn sàng cho ảnh biết nói AI

Ảnh chân dung kiểu người dẫn chương trình được tạo trên CreateVision AI — chỉ cần thêm âm thanh, bất kỳ ảnh nào cũng có thể chạy thành video avatar biết nói.

Hình ảnh đại diện AI của một chuyên gia làm đẹp đang giới thiệu serum dưỡng da.
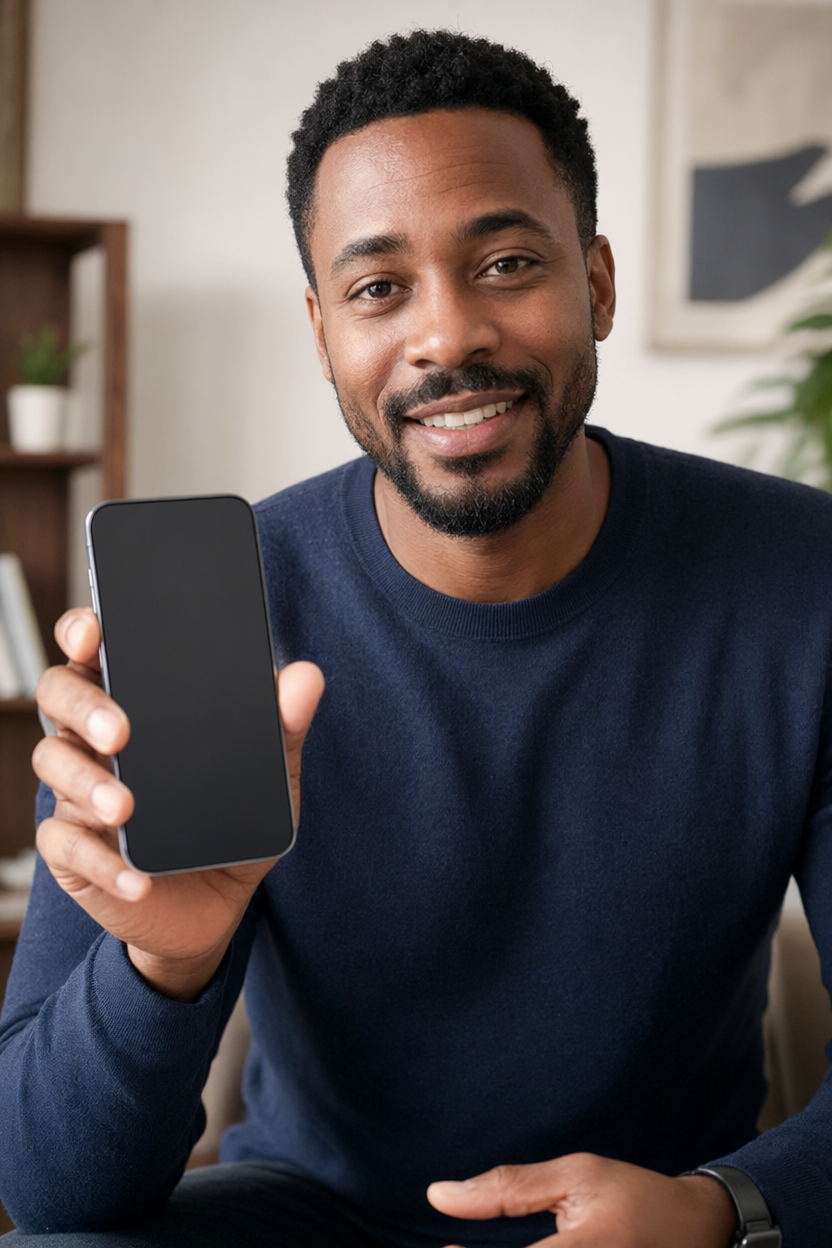
Hình đại diện AI của một nhà đánh giá công nghệ đang giới thiệu một chiếc điện thoại thông minh.
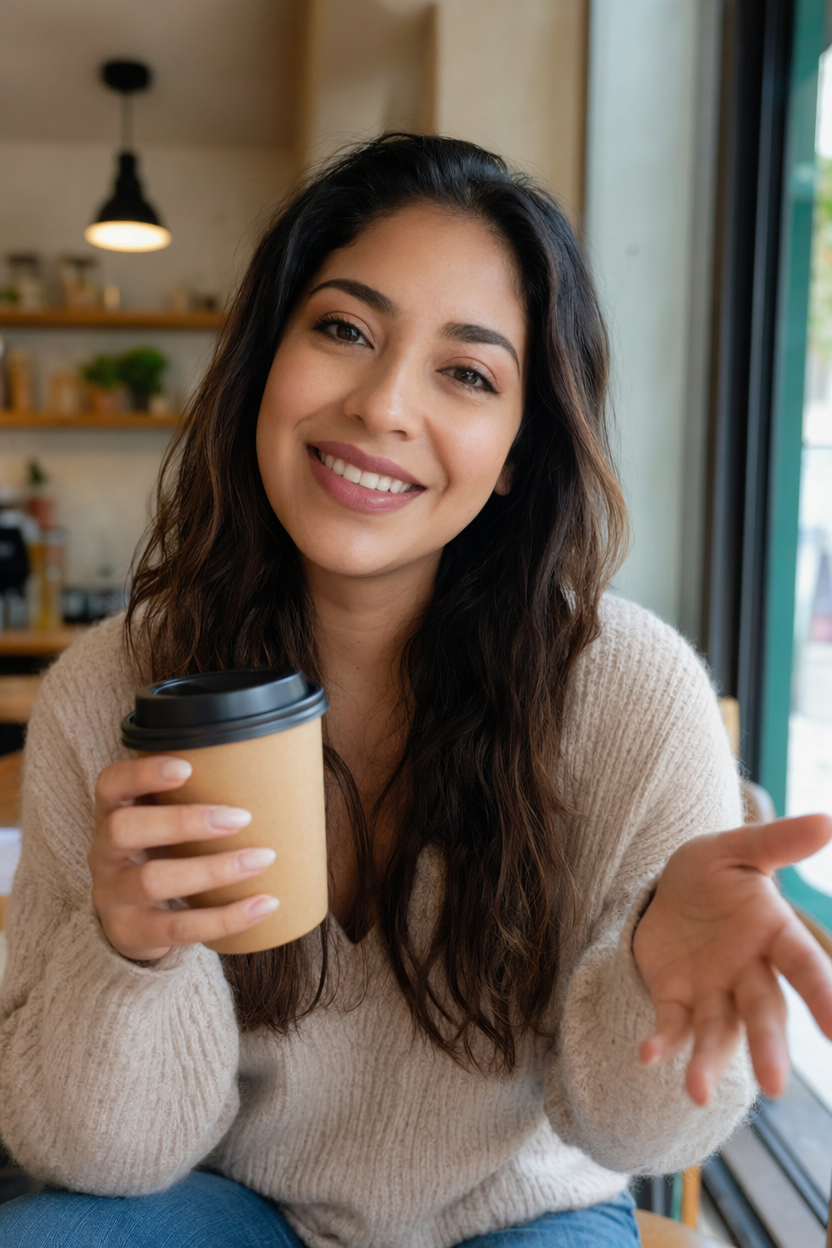
Hình đại diện AI của một người sáng tạo phong cách sống với một tách cà phê.
Hình đại diện AI của một người đánh giá giày thể thao đang giới thiệu một đôi giày.
Hình đại diện AI của một nhà thiết kế thời trang với một chiếc túi xách.
Hình đại diện AI của một chuyên gia về sức khỏe đang giới thiệu các thực phẩm chức năng.
Hình ảnh đại diện AI của một chuyên gia làm đẹp với một chai nước hoa.
Hình đại diện AI của một người sáng tạo nội dung nấu ăn tại nhà với một dụng cụ nhà bếp.

Mô hình đứng sau trình tạo ảnh biết nói AI này

OmniHuman 1.5 điều khiển khẩu hình, biểu cảm và chuyển động cơ thể trên trang này.

Thông số kỹ thuật của ảnh biết nói AI

Đầu vàoMột ảnh chân dung cộng với một tệp âm thanh tải lên hoặc một kịch bản bạn tự gõ.
Ảnh của aiCủa chính bạn, hoặc của người đã cho bạn phép. Cả ảnh và giọng nói đều phải thuộc quyền sử dụng của bạn.
Hướng dẫn về ảnh chân dungChính diện, đủ sáng, thấy trọn gương mặt và nét căng. Kính râm và bóng đổ đậm làm giảm độ chính xác khẩu hình.
Độ dài âm thanhTối đa 35 giây mỗi lần tạo — khoảng 85 từ nói.
Thư viện giọng đọc60 giọng đọc dựng sẵn trên 10 ngôn ngữ, nghe thử được trước khi tạo.
Mô hìnhOmniHuman 1.5, mô hình điều khiển khẩu hình, biểu cảm gương mặt cùng chuyển động đầu và cơ thể tự nhiên.
Chi phíTính phí theo từng giây đầu ra như các kiểu tạo video khác; hiển thị trước khi bạn tạo.
Đầu raMột clip tải về được, lưu vào lịch sử kèm ảnh chân dung gốc và kịch bản.

Cách tự vào vai trong ảnh biết nói AI của chính bạn

Ảnh của bạn, lời của bạn, một clip.

  1. 1

    Tải lên ảnh của chính bạn

    Ảnh rõ nét, chính diện cho kết quả tốt nhất: ảnh selfie bằng điện thoại, ảnh chân dung, hoặc một khung hình từ video. AI ảnh biết nói đọc khuôn mặt bạn từ khung hình duy nhất này.

  2. 2

    Thêm giọng của bạn

    Ghi âm chính bạn và tải lên âm thanh, hoặc nhập kịch bản và chọn một trong 60 giọng tích hợp. Âm thanh có thể dài tới 35 giây.

  3. 3

    Tạo, rồi tái sử dụng chính bạn

    Mô hình đồng bộ môi, biểu cảm và chuyển động đầu tự nhiên theo âm thanh. Giữ nguyên ảnh và tạo các câu thoại mới bất cứ khi nào cần, không cần quay lại.

Cách viết kịch bản cho ảnh biết nói AI

Ở đây không có prompt ảnh — ảnh chân dung và âm thanh mới là thứ làm việc. Cái bạn viết là kịch bản, và những lựa chọn trong kịch bản quyết định kết quả trông có tự nhiên hay không.

1

Câu mở đầu

Hãy bắt đầu bằng một câu ngắn. Giây đầu tiên là lúc khẩu hình lộ rõ nhất.

Này — nói nhanh chuyện này nhé.

2

Độ dài câu

Giữ mỗi câu dưới khoảng 15 từ. Mệnh đề dài tạo ra những khoảng ngắt không tự nhiên.

Serum này có hai thành phần. Đó là toàn bộ công thức.

3

Dấu câu

Dấu phẩy và dấu chấm trở thành nhịp lấy hơi. Đặt chúng ở chỗ bạn thật sự ngừng.

Nó hiệu quả — và chỉ mất mười giây.

4

Khối lượng chữ

Khoảng 2,5 từ mỗi giây. Hãy viết vừa với độ dài clip bạn muốn.

khoảng 85 từ cho một clip 35 giây

Mơ hồ

Sản phẩm mang tính cách mạng của chúng tôi ứng dụng công nghệ tiên tiến nhất để mang lại những kết quả vô song cho các khách hàng tinh tế đang tìm kiếm sự xuất sắc.

Cụ thể

Đây là phần lúc nào cũng có người hỏi. Hai thành phần, không chất độn. Khoảng một tuần là bạn thấy khác.

Vì sao nó hiệu quả

Câu đầu là một câu dài 19 từ toàn khái niệm trừu tượng — avatar đọc nó bằng giọng đều đều, hụt hơi, vì chẳng có chỗ nào để ngừng. Câu thứ hai là ba câu ngắn với những điểm nhấn tự nhiên, và đó là thứ khiến lời đọc nghe ra chất người.

Mơ hồ

Xin chào và chào mừng các bạn đến với kênh của chúng tôi, nơi hôm nay chúng ta sẽ cùng bàn về năm điều quan trọng nhất mà bạn cần biết về các quy trình chăm sóc da.

Cụ thể

Năm điều về chăm sóc da. Điều đầu tiên là điều nhiều người vẫn làm sai.

Vì sao nó hiệu quả

Những câu mở đầu dài lê thê là nơi khẩu hình lệch nhiều nhất, vì mô hình không có dấu câu nào để bám vào. Một câu mở ngắn cho nó những điểm nhấn rõ ràng và cũng giữ chân người xem tốt hơn.

Những thói quen nên bỏ

  • Dùng ảnh chân dung có gương mặt nhỏ, chếch góc hoặc bị bóng che một phần. Độ chính xác khẩu hình tỷ lệ thuận với việc miệng hiện rõ đến đâu trong khung hình gốc.
  • Viết vượt quá giới hạn âm thanh. Mỗi lần tạo dừng ở 35 giây âm thanh — kịch bản dài hơn sẽ bị cắt, nên hãy chia thành từng đoạn và dùng lại cùng một ảnh chân dung.
  • Dày đặc thuật ngữ kỹ thuật. Con số, từ viết tắt và tên sản phẩm dài là nơi giọng tổng hợp nghe máy móc rõ nhất. Hãy viết đúng như cách bạn đọc thành tiếng.

Không chỉ là trình tạo video avatar AI

Avatar biết nói chỉ là một dạng kết quả. Tạo ảnh và tạo video cũng chạy từ chính tài khoản đó.

Tài nguyên hữu ích về video avatar AI

Giá ảnh biết nói AI và tín dụng miễn phí

Video ảnh biết nói được tính phí theo giây như các video khác. Đăng ký miễn phí để dùng thử.

Miễn phí

$0

Hoàn hảo để bắt đầu

  • Đăng ký miễn phí
  • Bản nháp Z Image Turbo với 0 credits
  • Tốc độ tạo tiêu chuẩn
  • Bao gồm lịch sử tạo
Bắt đầu

Premium

Phổ biến nhất
$29/month

Thanh toán hằng năm · $240/năm

  • 8.000 tín dụng/tháng, không giới hạn ngày
  • Tất cả các mô hình cao cấp — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • Tốc độ tạo nhanh gấp 5 lần, hàng đợi ưu tiên
  • Tăng cường prompt bằng AI
Nâng cấp lên Premium

Ultimate

$59/month

Thanh toán hằng năm · $468/năm

  • 18.000 tín dụng/tháng, không giới hạn ngày
  • Tạo ảnh HD lên đến độ phân giải 4K
  • Hỗ trợ ưu tiên
  • Hàng đợi nhanh nhất và truy cập sớm các mô hình mới
Nâng cấp lên Ultimate

Ảnh biết nói AI — Câu hỏi thường gặp

1

Ảnh biết nói AI là gì?

Ảnh biết nói AI, còn gọi là avatar AI hay con người số, là video biết nói được tạo ra về một người từ một ảnh duy nhất và một giọng nói. Thay vì quay phim, bạn cung cấp ảnh chân dung và âm thanh (hoặc kịch bản + giọng), và mô hình tạo chuyển động cho một màn trình diễn nói sống động — dùng làm người trình bày số, người phát ngôn hoặc người thuyết minh.

2

Tôi cần những gì để tạo một cái?

Một bức ảnh chân dung rõ nét, chụp chính diện, cùng với một đoạn âm thanh (mp3/wav) hoặc — ở chế độ văn bản — kịch bản bạn muốn nói và một giọng nói được chọn từ thư viện có sẵn. Chỉ cần như vậy là đủ để tạo ra một video avatar biết nói.

3

Tôi có thể sử dụng giọng nói của chính mình không?

Có. Hãy tải bản ghi âm của riêng bạn lên và hình đại diện sẽ khớp khẩu hình với âm thanh đó. Nếu bạn không có bản ghi âm, hãy chuyển sang chế độ văn bản và chọn một giọng nói từ thư viện chuyển văn bản thành giọng nói.

4

Video avatar có thể dài tối đa bao nhiêu?

Tối đa 35 giây âm thanh cho mỗi lần tạo. Đối với kịch bản dài hơn, hãy chia chúng thành nhiều đoạn nhỏ. Thời lượng ước tính sẽ hiển thị khi bạn nhập và bạn sẽ bị tính phí theo từng giây âm thanh.

5

Tôi có thể sử dụng avatar AI để làm gì?

Các ứng dụng phổ biến bao gồm video giới thiệu sản phẩm và quảng cáo, thuyết minh khóa học và hướng dẫn người mới, video ngắn trên mạng xã hội, thông báo và các phiên bản đa ngôn ngữ của một thông điệp — bất cứ nơi nào bạn cần quay phim người thuyết trình.

6

Mô hình nào cung cấp sức mạnh cho hình đại diện AI?

CreateVision AI sử dụng OmniHuman 1.5 của ByteDance, giúp điều khiển đồng bộ hóa chuyển động môi, chuyển động đầu và cử chỉ từ âm thanh. Xem trang mô hình OmniHuman 1.5 để biết chi tiết kỹ thuật.

7

Ảnh nào hợp nhất với trình tạo video avatar AI?

Ảnh chân dung chính diện, đủ sáng, thấy trọn khuôn mặt và nét căng. Kính râm, bóng đổ đậm trên mặt, góc chụp quá lệch, hay khuôn mặt quá nhỏ trong khung hình đều làm giảm độ chính xác của khẩu hình.

8

Tôi có phải tự thu âm giọng mình không?

Không. Bạn có thể gõ kịch bản và chọn giọng từ thư viện có sẵn, gồm 60 giọng trải trên 10 ngôn ngữ. Nếu muốn dùng bản thu của chính mình, hệ thống cũng cho phép tải lên.

9

Tôi có thể tự vào vai trong video không?

Có, và đó là cách dùng phổ biến nhất. Tải lên ảnh của chính bạn, rồi ghi âm giọng của bạn hoặc nhập kịch bản và chọn giọng trong thư viện. Kết quả là bạn, đang nói lời của bạn, mà không cần thiết lập camera. Nhiều nhà sáng tạo giữ một ảnh đẹp và tạo clip mới từ ảnh đó mỗi tuần.

10

Tôi có thể dùng ảnh biết nói AI cho mục đích thương mại không?

Có. Theo Điều khoản dịch vụ của CreateVision AI, nội dung bạn tạo ra có thể được dùng cho mục đích cá nhân và thương mại, kèm ghi nguồn CreateVision AI khi phù hợp. Bạn chịu trách nhiệm về quyền sử dụng bức ảnh và giọng nói bạn tải lên, cũng như mọi quy định về công khai nội dung AI trên nền tảng nơi bạn đăng tải.

11

Trước đây tôi từng đưa chính mình vào video bằng Sora. Đây có phải là điều tương tự không?

Cùng mục tiêu, khác cơ chế. Ở đây ảnh của bạn là nhận dạng và âm thanh hoặc kịch bản của bạn điều khiển lời nói, nên kết quả là một clip dạng talking-head có đồng bộ môi, chứ không phải một cảnh mà bạn được thả vào. Nó hoạt động từ bất kỳ ảnh đơn lẻ nào, không cần đăng ký video, và không phụ thuộc vào việc một ứng dụng khác còn hoạt động hay không.

Tạo ảnh biết nói AI đầu tiên của bạn

Bắt đầu tạo