Generator Teks ke Video

Deskripsikan adegan, gerakan, suasana, dan arah kamera, lalu hasilkan video dengan model dan set parameter yang sesuai dengan kebutuhan.

Prompt ke gerakKontrol durasiPemilihan model video
0 / 2,000
~75 cr

AI text to video — tulis adegannya, dapatkan rekamannya

Deskripsikan subjek, gerakan, suasana, dan kamera, lalu hasilkan klip sinematik dengan audio native. Didukung oleh Seedance 2.0 — model yang saat ini memenangkan voting preferensi buta — bersama Veo 3.1 Fast.

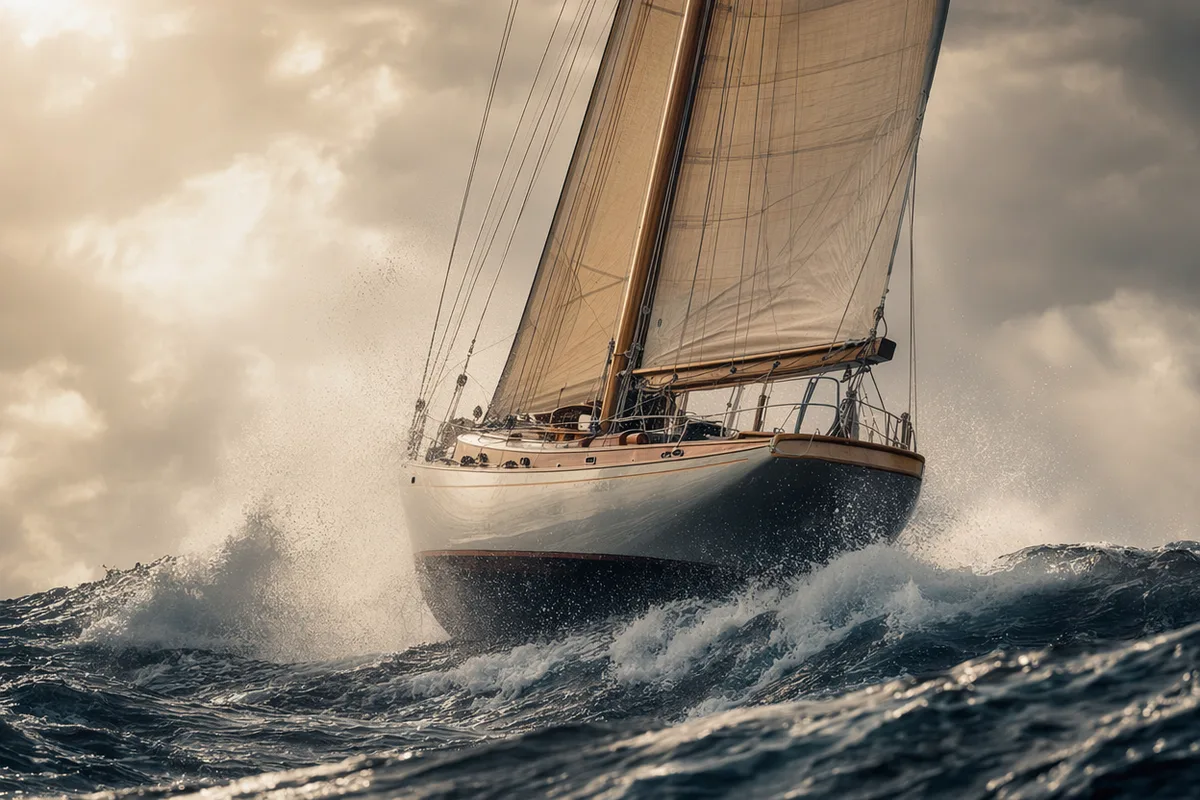
Cuplikan film AI sinematik berupa perahu layar di tengah badai

Adegan sinematik dari kalimat sederhana

Badai di laut, kejar-kejaran di jalanan neon, sebuah diner sepi di malam hari — tuliskan seperti Anda bercerita kepada teman, dan model menangani sinematografinya. Output Veo berulang kali digambarkan sebagai "diarahkan, bukan dihasilkan": pencahayaan yang disengaja, fisika yang meyakinkan, tata bahasa kamera yang nyata.
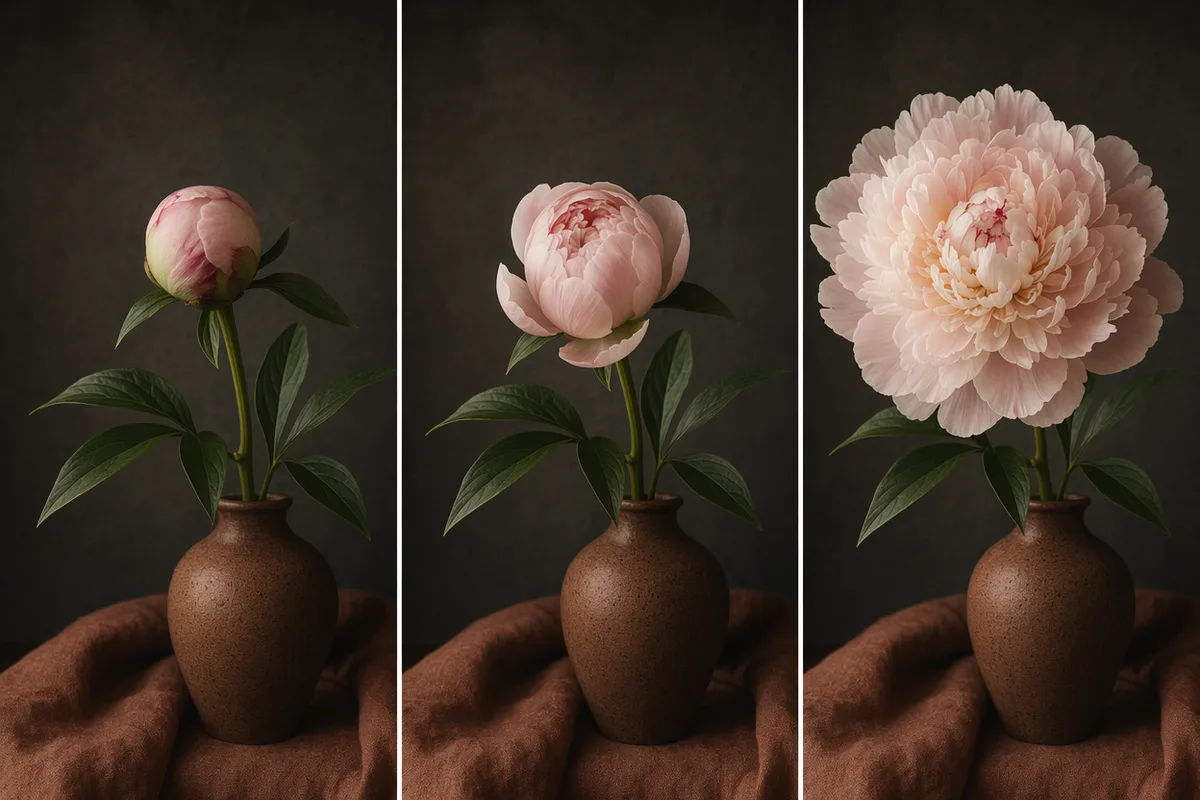
Rangkaian timelapse sekuntum bunga yang mekar di tiga bingkai

Gerakan dan waktu yang dapat Anda tentukan

Push-in lambat, mekarnya timelapse, energi handheld — arah gerakan dalam prompt diikuti, dan durasi terserah Anda untuk diatur (4–15 detik tergantung model). Klip sesuai dengan brief alih-alih sekadar mendekatinya.

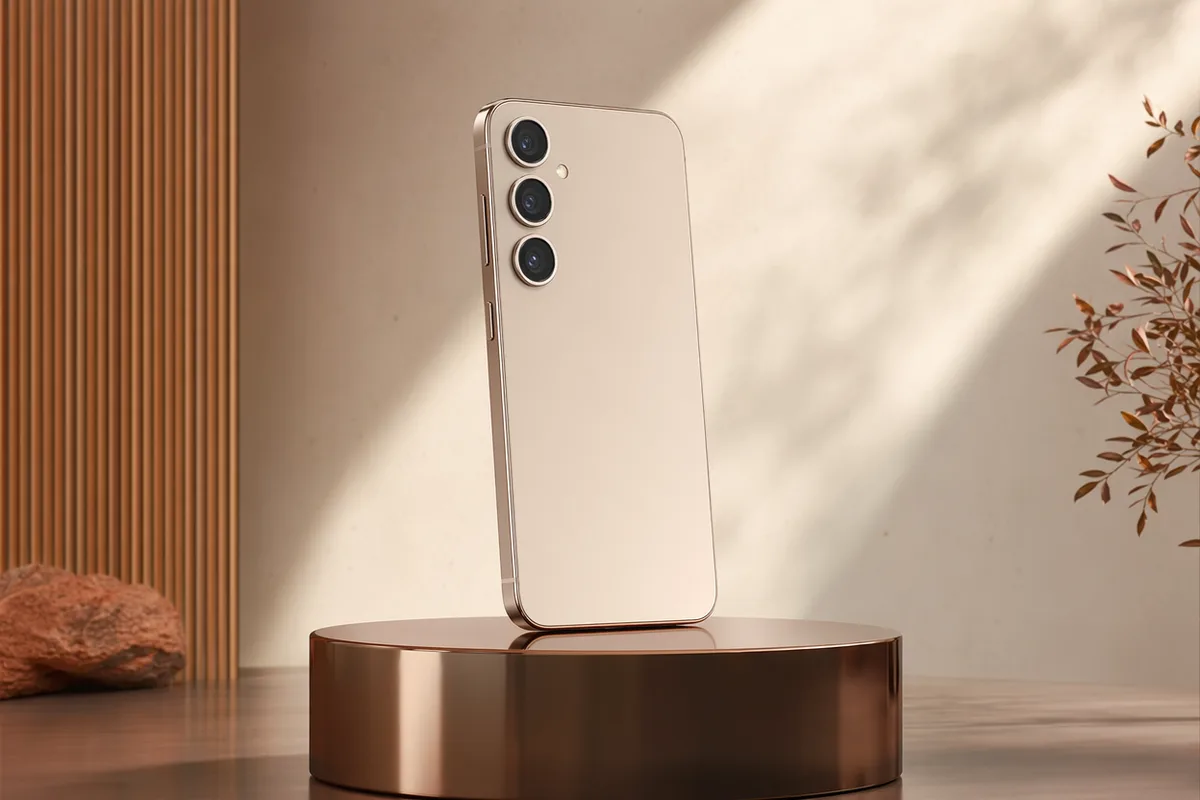
Bingkai video produk bergaya komersial berupa smartphone yang berputar

Klip produk dan brand dalam hitungan menit

Bidikan hero berputar, bidikan tuang, unboxing — rekaman bergaya komersial yang dulu butuh sesi studio kini dihasilkan dari sebuah paragraf. Harga per detik dengan biaya pasti ditampilkan di muka menjaga kampanye tetap dapat dianggarkan.

Timelapse cakrawala kota dengan jejak cahaya saat senja

Termasuk suara, siap vertikal

Dialog, ambience, dan efek native hadir bersama visual; 9:16 vertikal dan 16:9 layar lebar keduanya kelas utama. Outputnya adalah klip yang siap diunggah, bukan draf bisu.

Klip Text to Video yang dibuat di halaman ini

Masing-masing berawal dari teks tertulis saja, tidak ada yang lain. Prompt yang menghasilkannya tercetak di bawahnya.

PromptSeedance 2.5 · 480p · 16:9 · klip 4 dtk · 440 kredit

A ceramicist in a sunlit workshop looks up from the wheel and speaks warmly to camera: "This one finally came out right." Clay-dusted hands, natural skin texture, shallow depth of field, soft window light, ambient studio room tone.

PromptSeedance 2.0 Mini · 720p · 16:9 · klip 5 dtk · 150 kredit

A golden retriever puppy sprinting across a sunlit meadow toward the camera, ears flapping, slow-motion feel, backlit grass glowing, joyful energy.

PromptKling 3.0 Turbo · 1080p · 16:9 · 5 dtk · 350 kredit

A parkour athlete vaulting across rooftop gaps at golden hour, dynamic tracking camera, accurate body mechanics and momentum, dust kicked up on landings, cinematic sports energy.

PromptSeedance 2.0 Mini · 720p · 9:16 · 5 dtk · 150 kredit

Handheld vertical walk through a neon night market, steam rising from food stalls, lanterns swaying, people passing in soft motion blur, lively street ambience.

PromptKling 3.0 Turbo · 720p · 16:9 · 5 dtk · 275 kredit

Close-up of an elderly fisherman laughing warmly at dusk on a boat deck, wrinkles and windblown hair rendered naturally, genuine expressive performance, handheld documentary feel.

PromptSeedance 2.0 Mini · 480p · 16:9 · 4 dtk · 60 kredit

Two tiny paper boats racing down a rain-gutter stream after a storm, water rushing over pebbles, playful close follow shot.

PromptKling 3.0 Turbo · 720p · 9:16 · 5 dtk · 275 kredit

Vertical fashion film: a model in a flowing emerald dress walking toward camera down a rain-slick runway, fabric rippling naturally with each step, confident stride, editorial lighting.

PromptSeedance 2.5 · 480p · 16:9 · 4 dtk · 440 kredit · papan tulisnya keluar sebagai «SOUPE DU JWIN»

Close-up of a chef\'s hands rapidly julienning a carrot on a wooden board, knife tapping fast, a handwritten chalkboard menu reading "SOUPE DU JOUR" visible behind, busy kitchen sounds.

Model Text to Video yang Bisa Anda Ganti Kapan Saja

Satu adegan tertulis, beberapa engine — pilih yang gerakannya paling Anda suka.

Spesifikasi Text to Video

InputHanya prompt teks — tidak perlu gambar.
Bahasa promptSemua 27 bahasa antarmuka; prompt non-Inggris diperkaya sebelum pembuatan.
Durasi4 hingga 30 detik tergantung modelnya. Video yang lebih panjang dibuat dengan memperpanjang klip yang Anda suka.
Resolusi480p dan 720p di seluruh rentang; 1080p dan 4K pada Seedance 2.0 standard.
AudioSebagian mesin membuat audio bawaan yang tersinkron dalam proses yang sama; sebagian lain mengembalikan klip tanpa suara. Ditandai di panel.
BiayaPer detik output, mulai dari 15 kredit/detik pada 480p, ditampilkan lengkap sebelum Anda membuat.
Pembuatan yang gagalTidak ditagih — kredit tetap ada di saldo Anda.

Cara Menggunakan Text to Video Generator

Tulis adegannya, pilih engine-nya, buat.

  1. 1

    Tulis adegannya

    Jelaskan subjek, aksi, latar, dan gerakan kamera. Model text to video jauh lebih responsif terhadap bahasa pengambilan gambar — "slow dolly in", "handheld", "wide" — dibanding model gambar.

  2. 2

    Pilih model, durasi, dan resolusi

    Setiap engine text to video punya keunggulannya sendiri dalam gerakan dan audio. Biayanya per detik dan ditampilkan sebelum Anda menghasilkan video.

  3. 3

    Buat, lalu lanjutkan

    Unduh klipnya, perpanjang, atau bawa ke tahap pengeditan lanjutan. Prompt dan pengaturannya tetap melekat di riwayat.

Cara Menulis Prompt Text to Video

Model text to video membaca deskripsi shot, bukan ringkasan adegan. Empat komponen, dengan urutan ini.

1

Subjek

Siapa atau apa yang ada di dalam frame, dengan satu detail pembeda.

seorang koki dengan jaket putih bernoda

2

Aksi

Satu aksi, dijelaskan sebagaimana ia berlangsung.

menata sepiring hidangan, pinset meletakkan daun terakhir

3

Kamera

Posisi dan gerakan. Sebutkan bahkan ketika jawabannya “tanpa gerakan”.

locked-off shot dari atas

4

Tampilan

Cahaya, warna, dan finishing.

cahaya dapur yang keras, high contrast, documentary

Samar

seorang wanita berjalan di tengah hujan

Spesifik

seorang wanita bermantel panjang berjalan ke arah kamera menembus hujan sore, payung dimiringkan ke belakang, lampu toko buram di belakangnya, slow dolly back setinggi mata, shallow focus, biru sejuk dengan cahaya hangat dari jendela

Kenapa ini berhasil

Versi pendek hanya menyebut subjek dan kondisi cuaca, tidak lebih — kamera, arah, cahaya, dan lensa semuanya diserahkan ke model. Versi panjang mengunci masing-masing, dan itulah sebabnya ia menghasilkan shot yang sama dua kali.

Samar

video produk untuk sebotol skincare

Spesifik

botol serum kaca buram berputar perlahan di atas permukaan batu basah, camera locked off setinggi produk, satu soft key light dari kanan, tetesan air menangkap highlight, macro, tampilan komersial yang bersih

Kenapa ini berhasil

Video produk jauh lebih sering gagal karena framing dan cahaya ketimbang karena objeknya. Mengunci kamera, menyebut satu sumber cahaya, dan memilih macro memberi model tiga keputusan yang tadinya cuma ditebak.

Kebiasaan yang sebaiknya ditinggalkan

  • Meminta terlalu banyak aksi. Setiap gerakan tambahan adalah satu peluang lagi bagi model untuk merusak wajah atau tangan. Satu aksi yang jelas per klip jauh lebih tahan dibanding tiga.
  • Membiarkan kamera tanpa keterangan. Kalau Anda tidak menyebut bagaimana kamera berperilaku, model yang memilih — dan biasanya ia memilih menyimpang. “Locked-off shot” adalah instruksi yang sah dan berguna.
  • Langsung meminta durasi maksimum. Penyimpangan menumpuk seiring waktu. Buat dulu take pendek yang Anda suka, lalu perpanjang, alih-alih minta 30 detik di percobaan pertama.

Lebih dari Sekadar Text to Video

Video dari prompt hanyalah satu jalur. Gambar referensi, avatar, dan pengeditan adalah jalur lainnya.

Sumber Bermanfaat Seputar Text to Video AI

Harga Text to Video dan Credits Harian Gratis

Text to video ditagih per detik output. Akun gratis mendapat 80 credits per hari; paket berbayar membuka engine premium dan durasi yang lebih panjang.

Gratis

$0

Sempurna untuk memulai

  • 200 kredit sambutan, hingga 80/hari
  • Z Image Turbo membuat draf dengan 0 kredit
  • Kecepatan generasi standar
  • Termasuk riwayat generasi
Mulai

Premium

Paling populer
$29/month

Ditagih tahunan · $240/year

  • 8.000 kredit/bulan, tanpa batas harian
  • Semua model premium — GPT Image 2, Nano Banana, Seedream, Seedance, Veo, Kling
  • Kecepatan generasi 5x, antrean prioritas
  • Penyempurnaan prompt AI
Tingkatkan ke Premium

Ultimate

$49/month

Ditagih tahunan · $380/year

  • 18.000 kredit/bulan, tanpa batas harian
  • Generasi HD hingga resolusi 4K
  • Dukungan prioritas
  • Antrean tercepat dan akses awal ke model baru
Tingkatkan ke Ultimate

Text to Video — Pertanyaan yang Sering Diajukan

1

Bagaimana cara kerja text to video?

Anda mendeskripsikan adegan — subjek, gerakan, suasana, kamera — dan model video AI menghasilkan klip dari awal, termasuk audio native. Tidak diperlukan rekaman sumber.

2

Model apa yang harus saya gunakan?

Seedance 2.0 Fast untuk iterasi yang terjangkau, Seedance 2.0 untuk cerita multi-bidikan, Veo 3.1 Fast untuk kerapian sinematik bidikan tunggal, Seedance 1.5 Pro ketika Anda membutuhkan kontrol 1080p/durasi yang tepat.

3

Berapa lama video bisa berdurasi?

Sekitar 4 hingga 15 detik per generasi tergantung modelnya, dengan perpanjangan adegan tersedia pada Seedance 2.0 untuk melanjutkan rangkaian.

4

Apakah klip menyertakan audio?

Ya — Seedance dan Veo menghasilkan dialog, ambience, dan efek secara native. Audio dapat dinonaktifkan pada Seedance untuk tarif per detik yang lebih rendah.

5

Berapa biayanya?

Per detik, bervariasi sesuai model, resolusi, dan audio — selalu ditampilkan sebelum Anda membuat, dengan pengembalian otomatis jika gagal.

6

Bagaimana cara menulis prompt video yang baik?

Sebutkan subjek, aksi, latar, suasana, dan gerakan kamera. Penyempurna prompt bawaan secara otomatis mengembangkan ide singkat menjadi brief video yang terstruktur dengan baik.

7

Bisakah saya membuat video vertikal untuk TikTok dan Reels?

Ya — pilih 9:16 per generasi untuk platform vertikal, atau 16:9 untuk YouTube dan web.

8

Bagaimana cara menulis prompt text to video yang baik?

Pisahkan subjek, aksi, dan kameranya. "Seorang koki menata hidangan" adalah subjek; "push-in perlahan ke arah koki yang menata hidangan, depth of field dangkal, cahaya dapur yang hangat" adalah sebuah shot. Model text to video mengikuti yang kedua jauh lebih andal.

9

Bisakah text to video menghasilkan dialog dan suara?

Pada engine yang mendukung audio native, ya — termasuk ucapan yang tersinkron. Engine lain menghasilkan klip tanpa suara. Mana yang mana ditandai di panel model sebelum Anda mengeluarkan credits.

10

Mengapa klip text to video saya melenceng dari prompt-nya?

Durasi yang lebih panjang lebih mudah melenceng, karena model punya lebih banyak frame untuk diisi dan lebih sedikit pegangan. Klip pendek memegang prompt lebih erat; jika butuh durasi panjang, buat dulu take pendek yang Anda suka lalu perpanjang, ketimbang langsung meminta 30 detik sekaligus.

Tulis satu paragraf — tayangkan perdana satu klip

Mulai Membuat Video

Jelajahi tool video AI sekali klik kami

Tool sekali klik untuk semua hal di sekitar generasi — rapikan, ubah gaya, bagikan.