自分で出演するか、デジタルスポークスパーソンを作る
撮影も俳優もグリーンスクリーンも不要。自分の鮮明な写真を1枚アップロードするだけで、自分の声でもライブラリの声でも、スクリプトを読み上げるプレゼンターになれます。あるいは、許可を得た人物の写真を使って、製品説明、コース紹介、お知らせ、広告向けの再利用可能なデジタルホストを構築できます。再撮影なしで、いつでも新しいセリフを再生成できます。
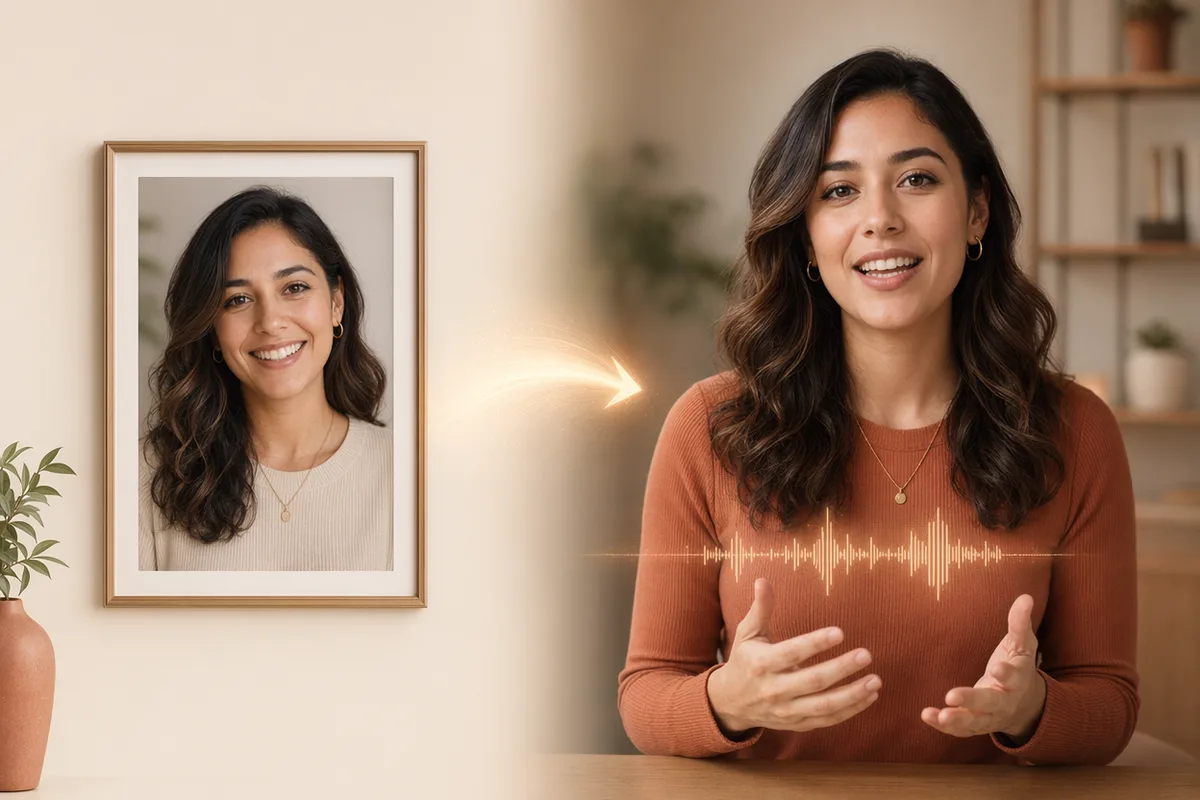
ポートレートと音声トラック(最大 35s)をアップロードするか、スクリプトを入力してボイスを選ぶと、OmniHuman 1.5 が写真を、同期した唇と自然な動きのあるトーキング動画に変換します。自分の写真を使って自分自身で出演できます。
1枚のポートレートと台本が、リアルな話し手に——口元・表情・ジェスチャーが同期。カメラもスタジオも不要。
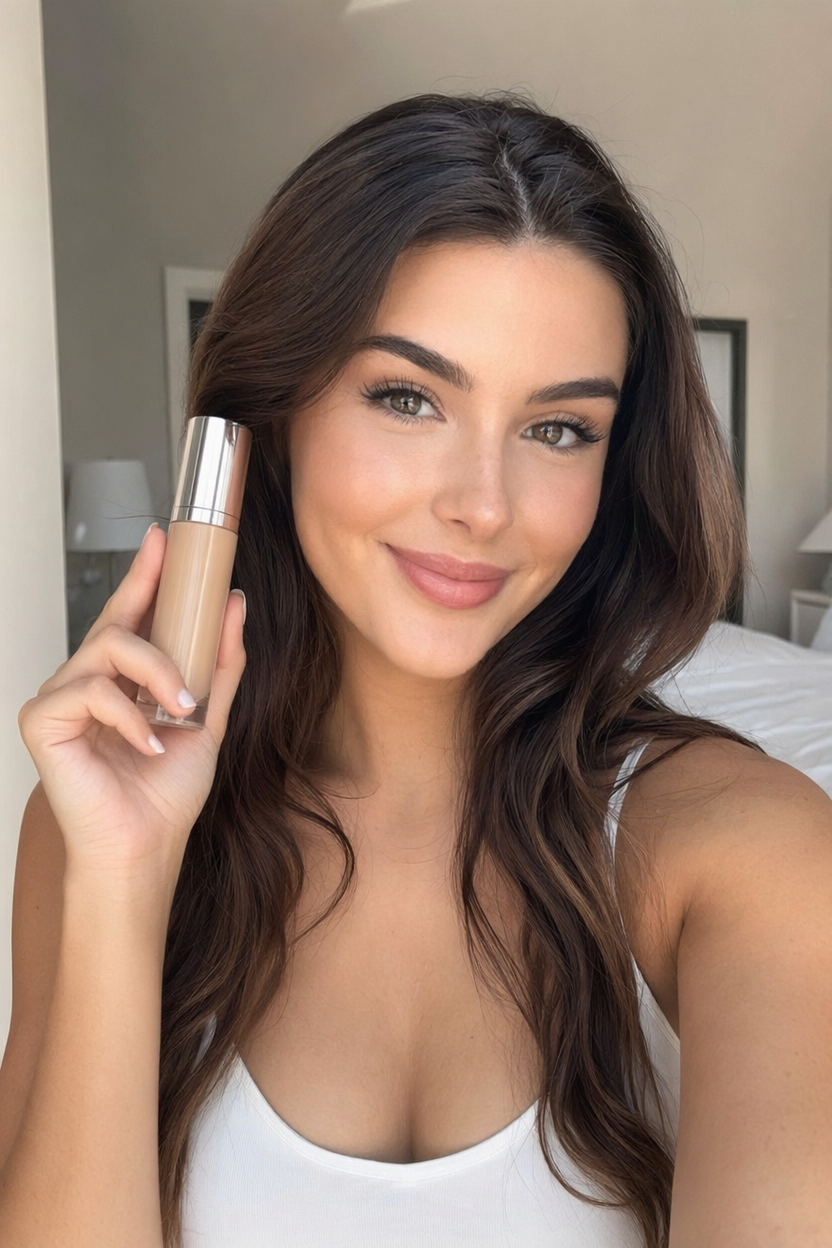
Hey everyone! I am so excited to share my new favorite foundation. It blends in seamlessly for a flawless, natural finish, and it actually feels lightweight all day. A little goes a long way, so one bottle lasts for months.
完全なAIトーキングフォト(デジタルヒューマン)生成ツール:ポートレートと音声クリップをアップロードするか、スクリプトを入力して声を選ぶだけで、唇の動きが同期し、自然な表情とジェスチャーを備えたリアルなトーキング動画が生成されます。自分の写真を使ってプレゼンターになることもできます。ByteDance OmniHuman 1.5を搭載。カメラも俳優もスタジオも不要です。
撮影も俳優もグリーンスクリーンも不要。自分の鮮明な写真を1枚アップロードするだけで、自分の声でもライブラリの声でも、スクリプトを読み上げるプレゼンターになれます。あるいは、許可を得た人物の写真を使って、製品説明、コース紹介、お知らせ、広告向けの再利用可能なデジタルホストを構築できます。再撮影なしで、いつでも新しいセリフを再生成できます。
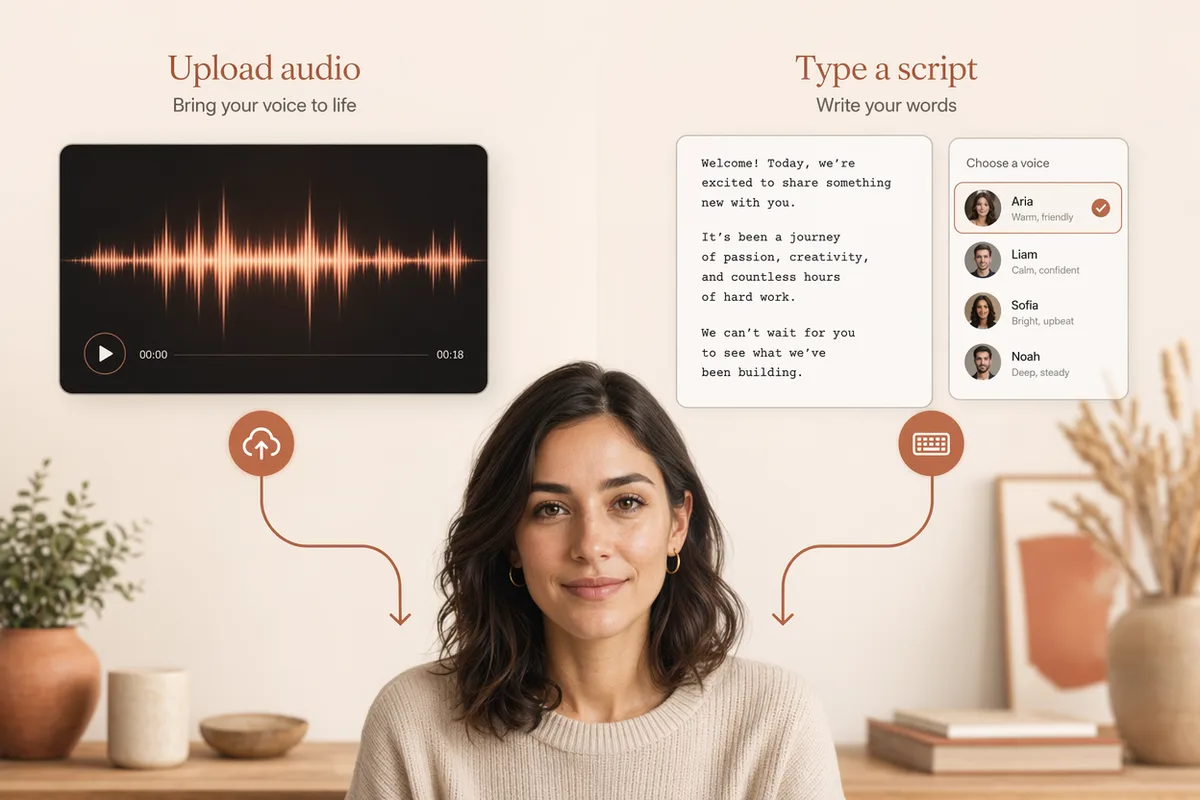
既に音声録音をお持ちですか?それをアップロードすれば、アバターがそれに合わせて口パクします。音声がない場合は、テキストモードに切り替えて、アバターに言わせたいセリフを入力し、内蔵のテキスト読み上げライブラリから音声を選択すれば、スクリプトが音声に変換されます。生成前に、推定される長さとクレジット費用が表示されます。
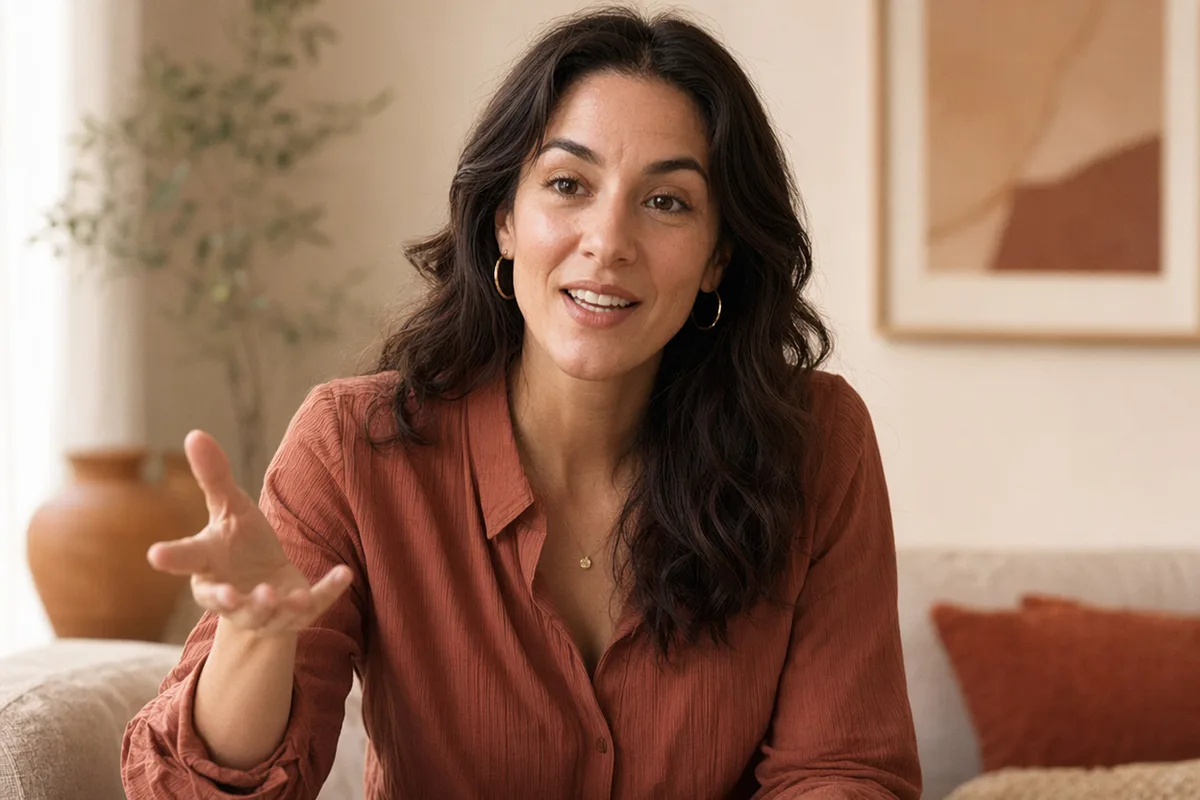
OmniHuman 1.5は、音声のリズム、韻律、意味を読み取り、正確なリップシンクに加え、頭の動き、姿勢、手のジェスチャーを制御します。同時に、人物の個性や照明も維持します。その結果、口元が動くだけの静止画ではなく、まるで本物のプレゼンターのようなパフォーマンスを実現します。
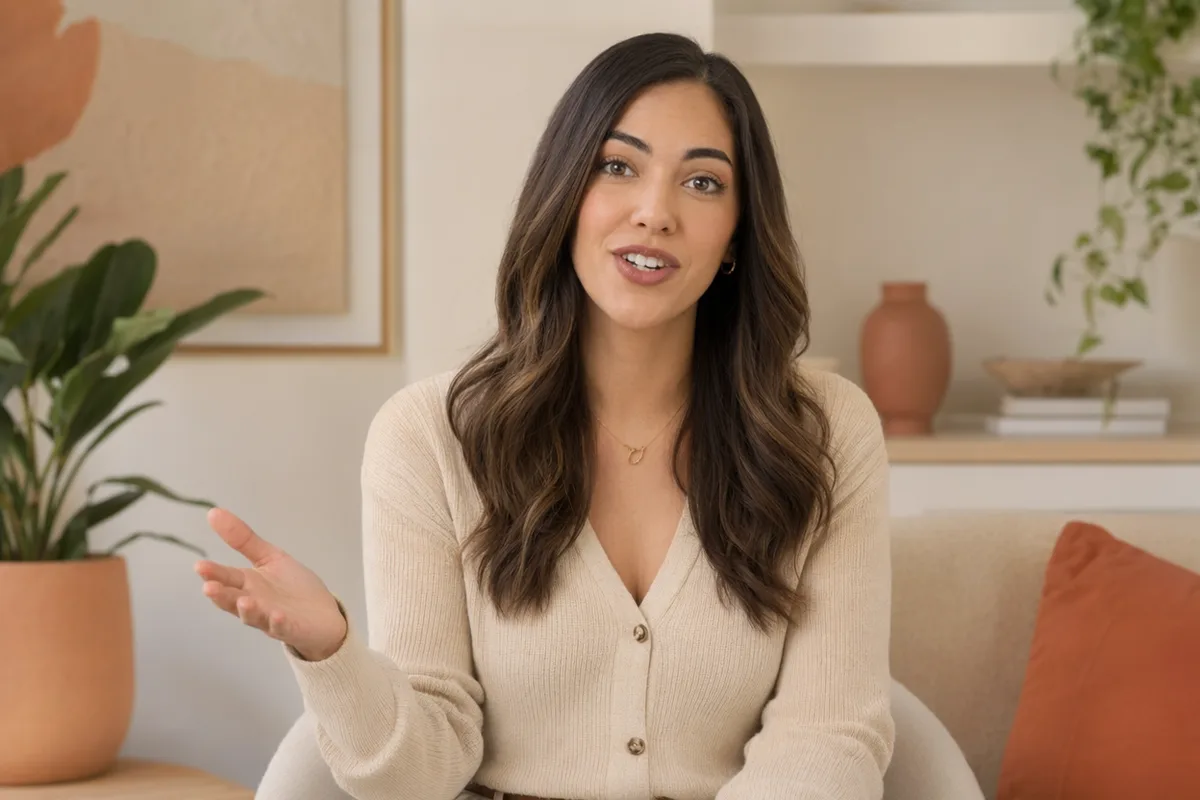
広告やランディングページ用のスポークスパーソンクリップ、トレーニング用のナレーション付きレッスンやオンボーディング、ソーシャルメディア用のトークヘッド投稿、あるいは同じメッセージの多言語版などをすぐに作成できます。各生成データは入力内容とともに履歴に保存されるため、反復作業やバリエーションの作成を迅速に行うことができます。
CreateVision AI で生成したプレゼンター風のポートレートです——音声を足せば、どれでも話すアバター動画を動かせます。
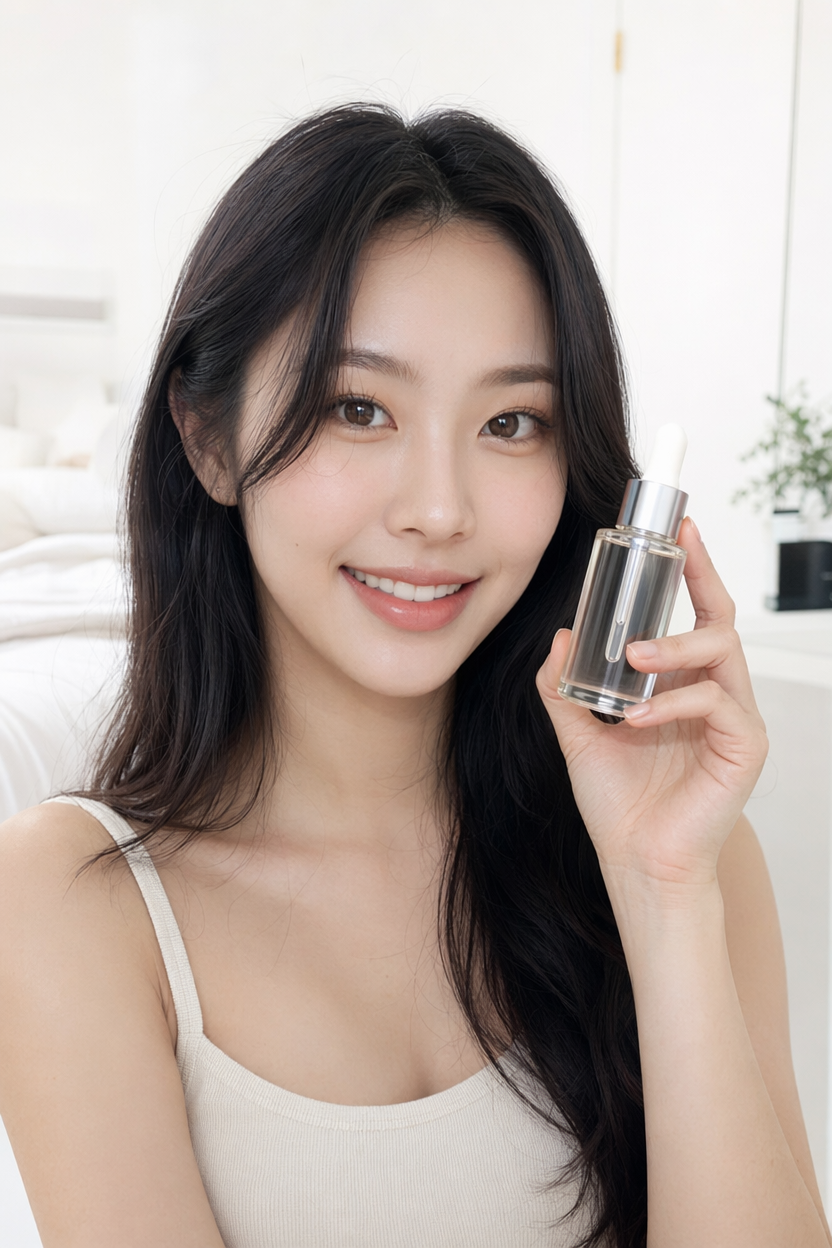
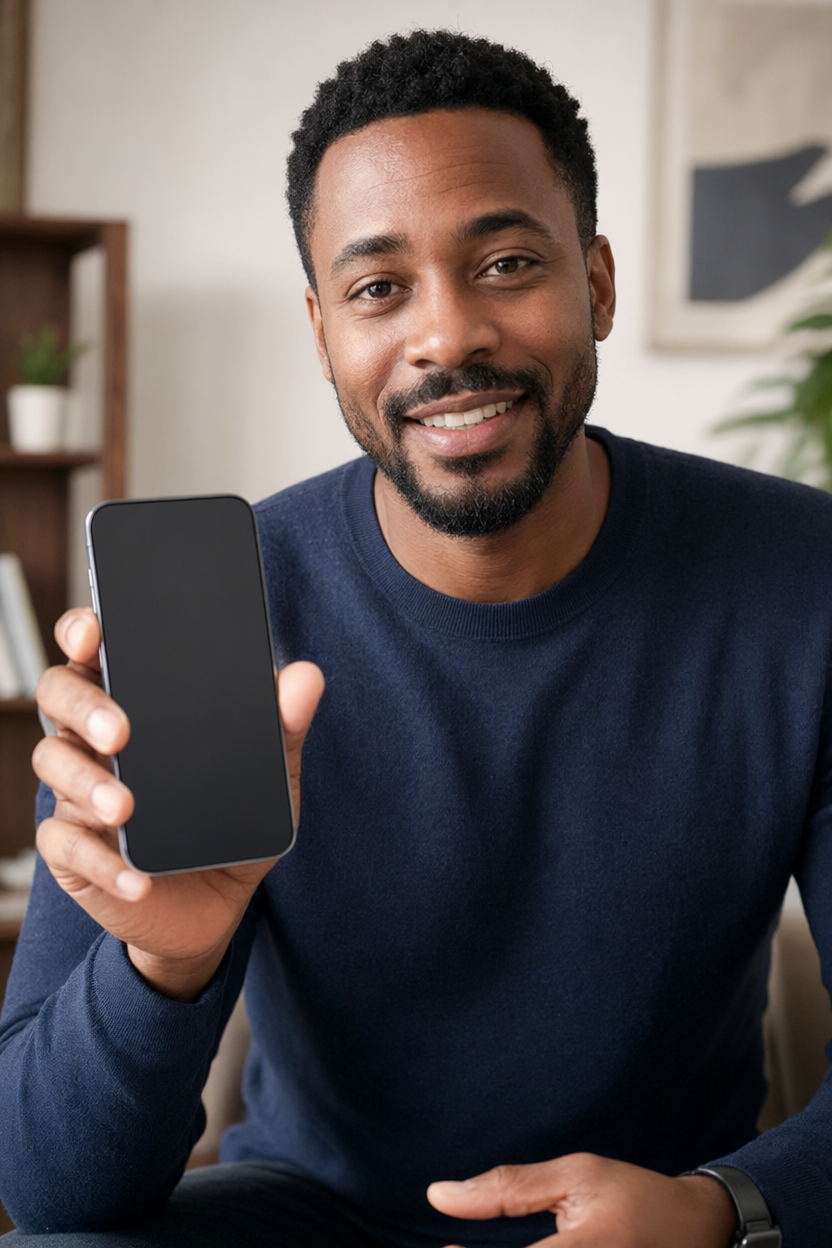
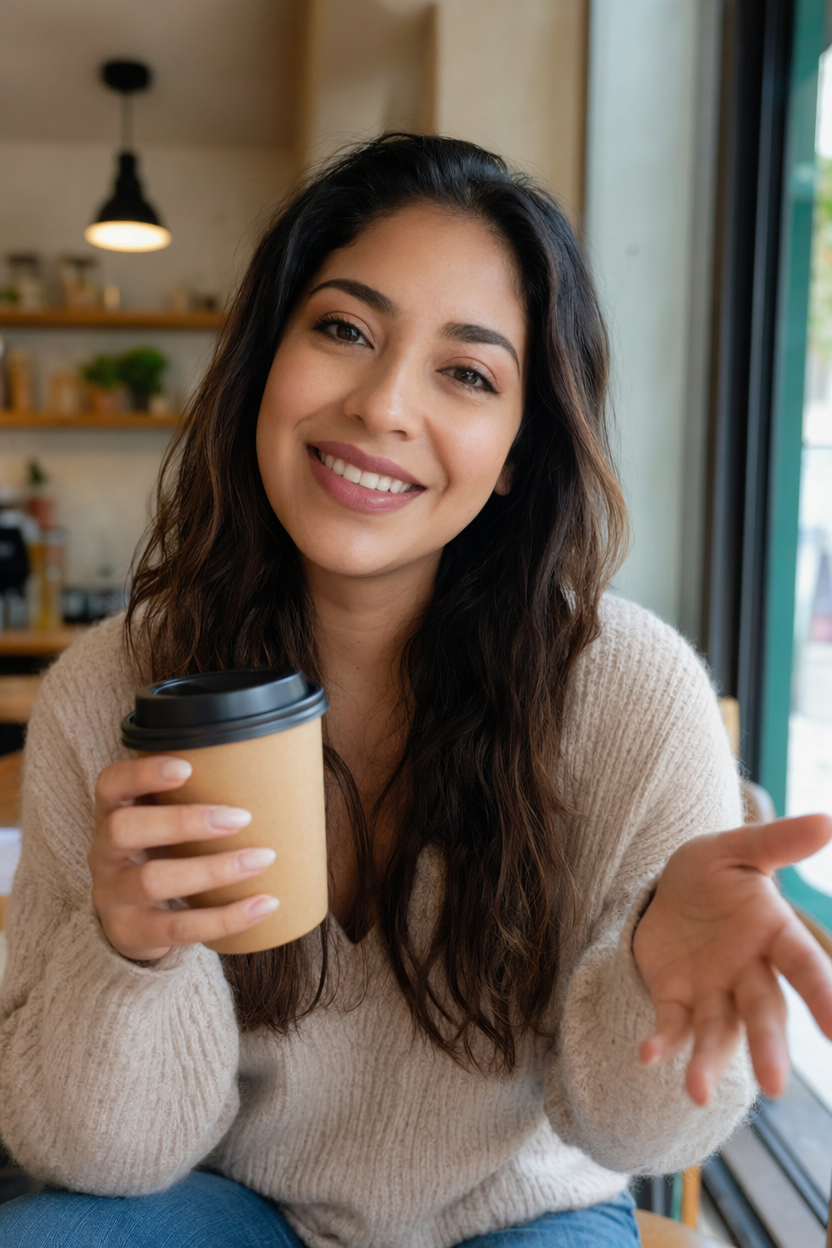
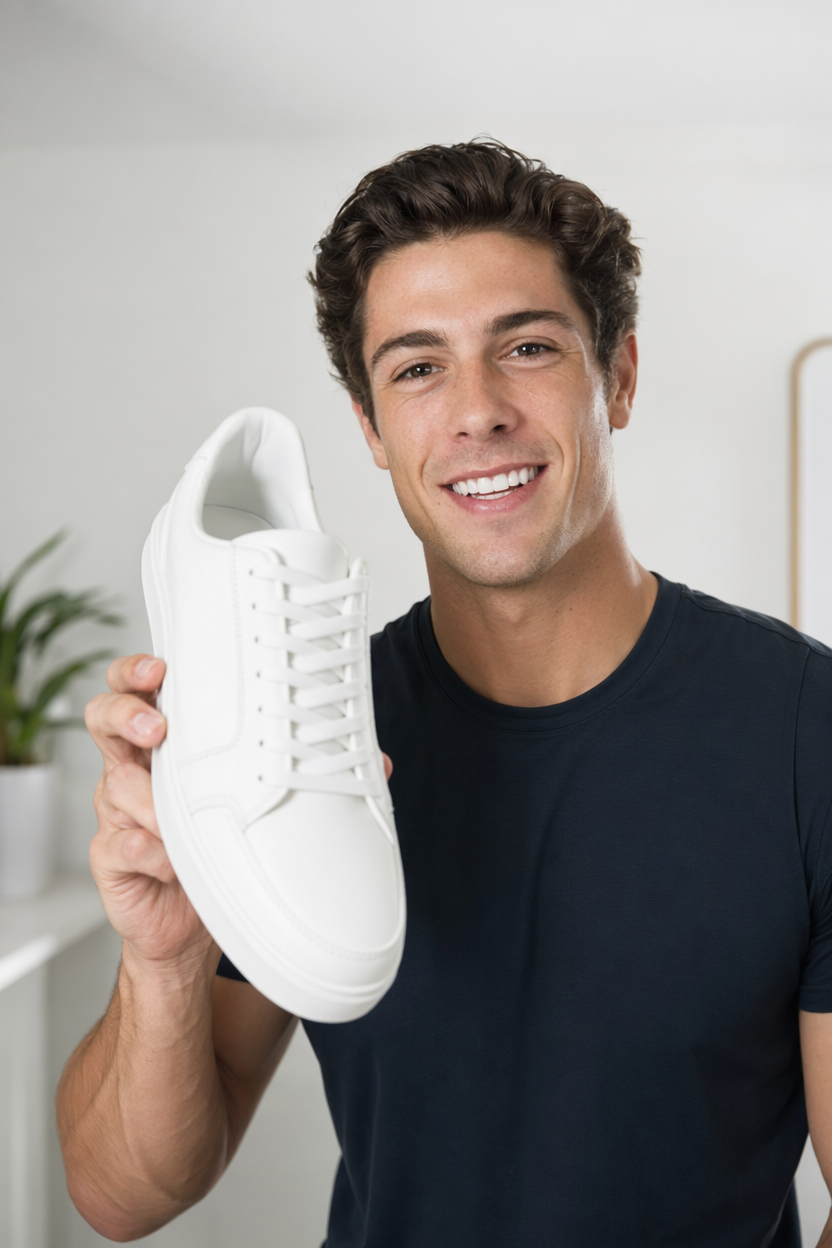
このページのリップシンク、表情、体の動きはOmniHuman 1.5が担っています。
| 入力 | ポートレート写真1枚と、アップロードした音声ファイルまたは入力した台本のどちらか。 |
|---|---|
| 誰の写真 | 自分自身、またはあなたに許可を与えた人物の写真。写真と声の両方が、あなたが使用できるものである必要があります。 |
| ポートレートの条件 | 正面向き、十分な明るさ、顔全体が写っていてピントが合っていること。サングラスや強い影はリップシンクの精度を下げます。 |
| 音声の長さ | 1回の生成につき最大 35 秒——話し言葉でおよそ 85 語です。 |
| ボイスライブラリ | 10 言語にわたる 60 種類の内蔵ボイス。生成前に試聴できます。 |
| モデル | OmniHuman 1.5。リップシンク、表情、そして自然な頭と体の動きを担います。 |
| コスト | 他の動画生成と同じく出力秒数での課金。生成前に表示されます。 |
| 出力 | ダウンロードできるクリップ。元のポートレートと台本を添えて履歴に保存されます。 |
あなたの写真、あなたの言葉、1つのクリップ。
鮮明な正面からの写真が最適です:スマホの自撮り、ヘッドショット、または動画からの1フレーム。トーキングフォトAIはこの1枚のフレームからあなたの顔を読み取ります。
自分で録音して音声をアップロードするか、スクリプトを入力して60種類の内蔵ボイスから1つを選びます。音声は最長35秒です。
モデルは唇、表情、自然な頭の動きを音声に同期させます。同じ写真をそのまま使い、必要なときにいつでも新しいセリフを再撮影なしで生成できます。
ここに画像プロンプトはありません——働くのはポートレートと音声です。あなたが書くのは台本で、その選び方が仕上がりの自然さを決めます。
短い一言から始めましょう。リップシンクが最も目立つのは最初の1秒です。
ねえ、ちょっとだけいい?
1文はおよそ15語以内に。長い節は不自然な間を生みます。
この美容液の成分は2つ。これが処方のすべてです。
読点と句点は息継ぎになります。実際に間を置く場所に打ってください。
効きます——しかも10秒で終わります。
おおよそ1秒あたり2.5語。狙うクリップの長さに合わせて書きましょう。
35秒のクリップでおよそ85語
当社の革新的な製品は最先端のテクノロジーを活用し、卓越性を求める目の肥えたお客様に比類なき成果をお届けします。
これがいつも聞かれる部分です。成分は2つ、余計なものはなし。1週間ほどで違いが分かります。
1つ目は抽象語だけでできた19語の一文で、アバターは平板で息継ぎのない一本調子で読み上げます。間を置ける場所がどこにもないからです。2つ目は自然なアクセントを持つ短い3文で、これが読みを人間らしく聞こえさせます。
皆さんこんにちは、私たちのチャンネルへようこそ。本日はスキンケアのルーティンについて知っておくべき最も重要な5つのことについてお話ししていきたいと思います。
スキンケアについて5つ。1つ目は、みんなが間違えているところです。
だらだら続く長い書き出しは、リップシンクが最もズレる場所です。モデルが拠り所にできる句読点がないからです。短いつかみなら明確なアクセントができ、視聴者も離れにくくなります。
話すアバターは出力のひとつにすぎません。画像生成も動画生成も同じアカウントで動きます。
トーキングフォト動画は他の動画出力と同様に秒単位で課金されます。新規アカウントには200の無料クレジットが付与され、試すことができます。
年額請求 · $240/年
年額請求 · $468/年
AIトーキングフォト(AIアバターまたはデジタルヒューマンとも呼ばれる)は、1枚の写真と音声から生成される、人物のトーキング動画です。撮影の代わりに、ポートレートと音声(またはスクリプト+声)を用意するだけで、モデルがリアルな話し方のパフォーマンスをアニメーション化します — デジタルプレゼンター、スポークスパーソン、ナレーターとして使用されます。
鮮明な正面向きのポートレート写真と、音声クリップ(mp3/wav形式)、またはテキストモードの場合は読み上げたいスクリプトと内蔵ライブラリから選択した音声。これだけで、しゃべるアバター動画を作成できます。
はい。ご自身の音声録音をアップロードすると、アバターがそれに合わせて口パクします。録音がない場合は、テキストモードに切り替えて、テキスト読み上げライブラリから音声を選択してください。
1世代あたり最大35秒の音声。長いスクリプトの場合は、複数のクリップに分割してください。入力すると推定再生時間が表示され、音声1秒単位で課金されます。
一般的な用途としては、製品説明や広告、コースやオンボーディングのナレーション、ソーシャルメディアでの発言動画、告知、メッセージの多言語版など、プレゼンターを撮影する必要があるあらゆる場面が挙げられます。
CreateVision AIは、ByteDanceのOmniHuman 1.5を使用しており、音声からリップシンク、頭の動き、ジェスチャーを自動で処理します。技術的な詳細については、OmniHuman 1.5のモデルページをご覧ください。
光が十分に当たり、顔全体がはっきり写った正面向きのポートレート。サングラス、顔にかかる濃い影、極端なアングル、画面内で顔が小さすぎる——いずれもリップシンクの精度を下げます。
いいえ。台本を入力し、内蔵ライブラリから声を選べます。ライブラリには10言語・60種類の音声が揃っています。自分の録音を使いたい場合はアップロードにも対応しています。
はい。最も一般的な使い方です。自分の写真をアップロードし、自分の声を録音するか、スクリプトを入力してライブラリの声を選びます。カメラのセットアップなしで、あなた自身があなたの言葉を話す動画が完成します。多くのクリエイターは良い写真を1枚用意して、毎週そこから新しいクリップを生成しています。
はい。CreateVision AI の利用規約に基づき、生成したコンテンツは個人目的および商用目的で使用でき、適切な場合には CreateVision AI への帰属表示を行います。アップロードする写真と音声の権利を有していること、および公開先プラットフォームの AI 開示ルールへの対応は、お客様の責任となります。
目的は同じで、仕組みが違います。ここでは写真がアイデンティティとなり、音声またはスクリプトが発話を駆動するため、出力はあなたが放り込まれるシーンではなく、リップシンク付きのトーキングヘッドクリップになります。任意の1枚の写真から動作し、動画のエンロールは不要で、別のアプリが利用可能であり続けることにも依存しません。